Представим ситуацию: в PostgreSQL хранится большое значение — документ, бинарные данные, крупный JSON или другой объект размером в несколько мегабайт. При этом приложению далеко не всегда нужен объект целиком. Иногда требуется получить лишь небольшой фрагмент.
Например, значение занимает 10 MiB, а запросу нужны всего 100 байт.
Кажется логичным, что PostgreSQL должен прочитать только эти 100 байт. Но на практике объём работы зависит от того, как значение хранится, было ли оно сжато и какой алгоритм сжатия использовался.
В этой статье проверим поведение PostgreSQL 18.6 экспериментально. Сравним EXTERNAL, PGLZ и LZ4 и посмотрим, что происходит, если читать один и тот же 100-байтовый фрагмент из начала, середины и конца большого значения.
Цель — не найти универсально «лучший» вариант хранения. Нас интересует более практический вопрос: какую работу PostgreSQL выполняет при частичном чтении большого TOAST-значения и при каких условиях различия становятся заметны.
Зачем здесь вообще нужен TOAST
PostgreSQL хранит данные страницами фиксированного размера — обычно 8 KiB. Строка таблицы не может просто продолжиться на следующей странице, поэтому большие значения нельзя всегда хранить непосредственно внутри основной строки.
Для этого существует TOAST — The Oversized-Attribute Storage Technique.
Большое значение PostgreSQL может сжать и/или вынести из основной строки в связанную TOAST-таблицу. Вынесенное значение разбивается на отдельные части — chunks. При стандартном размере страницы размер одной такой части составляет примерно 2 KiB: PostgreSQL подбирает его так, чтобы несколько chunk-строк помещались на одной странице.
Для нашего эксперимента важны две стратегии хранения:
EXTERNAL позволяет вынести значение в TOAST, но запрещает его сжатие.
EXTENDED разрешает и сжатие, и вынос. Для сжатия PostgreSQL поддерживает PGLZ и LZ4; LZ4 доступен, если конкретная сборка PostgreSQL собрана с его поддержкой.
В документации PostgreSQL отдельно отмечается, что EXTERNAL может ускорять substring() для больших text и bytea. Причина в том, что для несжатого внешнего значения PostgreSQL способен получить только необходимую часть данных. Цена такого подхода — больший объём хранения.
Отсюда и возникает вопрос: что меняется, если то же самое внешнее значение всё-таки сжато?
Что происходит внутри PostgreSQL 18
Для несжатого внешнего значения в функции detoast_attr_slice() предусмотрена отдельная короткая ветка обработки: PostgreSQL передаёт требуемое смещение и длину непосредственно функции чтения части TOAST-значения. То есть при EXTERNAL сервер действительно может запросить только нужный диапазон.
С PGLZ всё сложнее.
Сжатые данные нельзя просто открыть в произвольном месте и начать читать с нужного байта исходного значения. Чтобы получить, например, данные из середины, PostgreSQL сначала должен восстановить данные от начала до этой позиции.
При этом для PGLZ PostgreSQL умеет оценивать, какая начальная часть сжатых данных ему понадобится. Если запрашиваемый фрагмент расположен близко к началу исходного значения, сервер может не читать сжатое значение целиком. Чем дальше находится нужный фрагмент, тем большую часть сжатых данных приходится получить и распаковать.
У LZ4 есть дополнительное ограничение.
В коде PostgreSQL 18 прямо отмечено, что сервер пока не умеет заранее определять, какой объём сжатых LZ4-данных гарантированно достаточен для восстановления нужной части. Поэтому PostgreSQL сначала получает всё сжатое LZ4-значение из TOAST. Но распаковывать его полностью необязательно: декомпрессия может остановиться после того, как восстановлены данные до нужной позиции.
Получается три разных сценария:
EXTERNAL— значение не сжато. PostgreSQL может сразу получить нужный диапазон из TOAST.PGLZ— PostgreSQL получает столько сжатых данных от начала значения, сколько может понадобиться для восстановления нужного участка, после чего распаковывает их до требуемой позиции.LZ4— PostgreSQL получает сжатое значение целиком, но распаковывает его только до той точки, которая нужна запросу.
Из устройства кода уже можно сформулировать гипотезы, но этого недостаточно. Посмотрим, насколько эти различия проявятся в реальных замерах.
Тестовый стенд
Эксперименты проводились локально на PostgreSQL 18.6 под Windows.
Конфигурация PostgreSQL:
PostgreSQL:                18.6
block_size:                8192 B
shared_buffers:            128 MB
effective_cache_size:      4 GB
default_toast_compression: pglz
LZ4:                       поддерживается
Для каждого режима была создана отдельная таблица:
CREATE TABLE toast_external (
    id bigint PRIMARY KEY,
    payload bytea STORAGE EXTERNAL
);

CREATE TABLE toast_pglz (
    id bigint PRIMARY KEY,
    payload bytea STORAGE EXTENDED COMPRESSION pglz
);

CREATE TABLE toast_lz4 (
    id bigint PRIMARY KEY,
    payload bytea STORAGE EXTENDED COMPRESSION lz4
);
В качестве типа данных использовался bytea, чтобы размер и позицию фрагмента можно было задавать непосредственно в байтах.
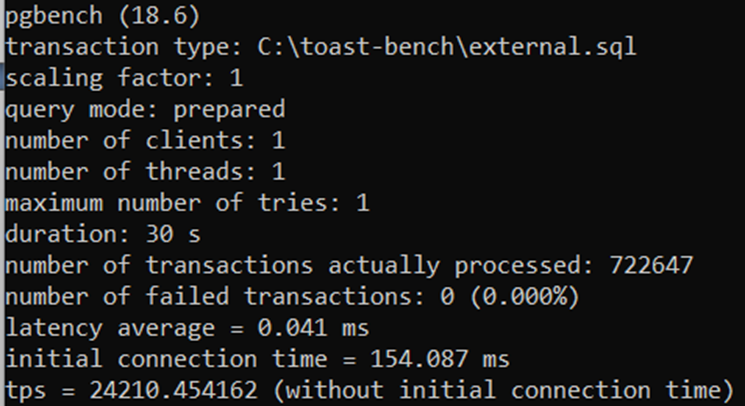
Основные замеры производительности выполнялись штатной утилитой pgbench: один клиент, один поток, 30 секунд на прогон, режим prepared. Для ключевого эксперимента каждая точка запускалась пять раз, а в итоговую таблицу вошла медиана.
pgbench многократно выполняет заданный сценарий и позволяет измерять среднее время одной операции и количество выполненных операций в секунду. В нашем случае один сценарий состоит из одного SELECT.
Сам запрос выглядел так:
SELECT octet_length(
    substring(payload FROM :offset FOR :slice)
)
FROM toast_pglz
WHERE id = 2;
Для остальных вариантов менялось только имя таблицы.
Мы возвращаем клиенту не сами бинарные данные, а их длину, чтобы передача большого значения от сервера клиенту не становилась основной частью измерения.
Сначала проверяем физическое хранение
Указанная у столбца стратегия ещё не означает, что конкретное значение обязательно будет храниться в ожидаемом виде.
Поэтому перед тестами проверялось фактическое состояние данных:
SELECT
    pg_column_size(payload),
    pg_column_compression(payload),
    pg_column_toast_chunk_id(payload)
FROM ...;
pg_column_size() показывает размер сохранённого представления значения с учётом применённого сжатия.
pg_column_compression() возвращает реально использованный алгоритм либо NULL, если конкретное значение не было сжато.
pg_column_toast_chunk_id() позволяет проверить, что значение действительно вынесено во внешнюю TOAST-таблицу.
Контрольный набор: очень хорошо сжимаемые данные
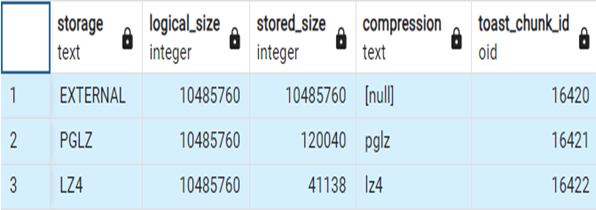
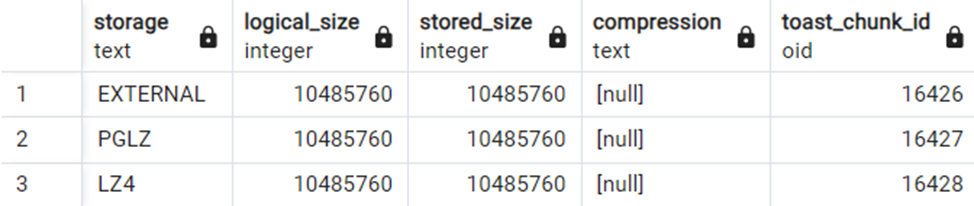
Сначала был создан искусственный объект из повторяющейся последовательности ABCD размером ровно 10 MiB.
Получили:
Режим | Логический размер | Сохранённое представление | Сжатие |
| 10 485 760 B | 10 485 760 B | нет |
| 10 485 760 B | 120 040 B |
|
| 10 485 760 B | 41 138 B |
|
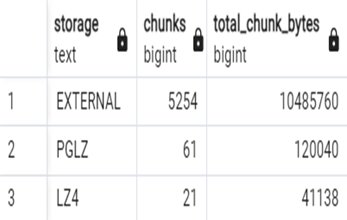
Те же значения заняли в TOAST:
Режим | Chunks |
| 5254 |
| 61 |
| 21 |
Этот пример хорошо показывает, насколько по-разному может выглядеть один и тот же логический объект внутри PostgreSQL.
Но для основного измерения производительности такой набор слишком искусственный: повторяющаяся последовательность ABCD сжимается чрезвычайно хорошо.
Основной набор данных
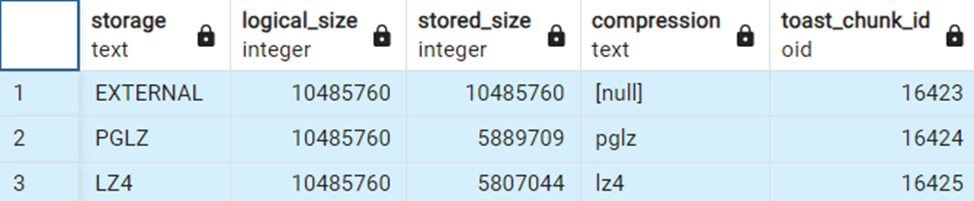
Для основного эксперимента использовалось значение размером 10 MiB, состоящее из повторяющихся и изменяющихся частей: 32 повторяющихся ASCII-байта и 32 символа MD5 на блок.
Фактическое хранение получилось таким:
Режим | Логический размер | Сохранённое представление | Экономия относительно исходного размера |
| 10 485 760 B | 10 485 760 B | 0% |
| 10 485 760 B | 5 889 709 B | ~43,8% |
| 10 485 760 B | 5 807 044 B | ~44,6% |
В этом наборе PGLZ и LZ4 дают близкий физический размер. Поэтому различия при чтении уже нельзя объяснить только тем, что один вариант занимает в десятки раз меньше места другого.
Главный эксперимент: 100 байт из разных 10 MiB
Размер фрагмента 100 B. Проверяем три позиции:
начало: offset = 1
50%:    offset = 5 242 881
90%:    offset = 9 437 185
Для каждой комбинации проводилось пять 30-секундных прогонов.
В таблице ниже указана медиана среднего времени выполнения одной операции, которое показывает pgbench. Далее для краткости будем называть эту величину временем запроса.
Storage | Начало | 50% | 90% |
| 0,040 ms | 0,040 ms | 0,040 ms |
| 0,040 ms | 7,064 ms | 10,422 ms |
| 2,016 ms | 3,669 ms | 5,269 ms |
EXTERNAL: положение фрагмента практически ничего не изменило
Для EXTERNAL медианное время во всех трёх точках оказалось одинаковым с точностью, которую показывает pgbench:
начало → 0,040 ms
50%    → 0,040 ms
90%    → 0,040 ms
Это хорошо соответствует механизму, который мы видели в исходном коде: значение не сжато, поэтому PostgreSQL может получить непосредственно нужный диапазон TOAST.
С точки зрения произвольного чтения небольших частей большого объекта такое поведение наиболее предсказуемо.
Цена видна из предыдущей таблицы: те же данные занимают 10 MiB вместо примерно 5,8 MiB в сжатых вариантах.
PGLZ: очень быстро в начале, существенно дороже дальше
У PGLZ первые 100 байт читались практически с тем же временем: 0,040 ms, но в середине значение выросло до: 7,064 ms, а на отметке 90%: 10,422 ms.
Разница получилась очень большой.
Причину проще представить так: PGLZ позволяет PostgreSQL не читать всё сжатое значение, если нужен фрагмент около его начала. Но чтобы получить данные из середины или ближе к концу, серверу требуется всё большая начальная часть сжатого потока, которую затем приходится распаковывать до нужной позиции.
Дополнительно посмотрим на результат:
EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)
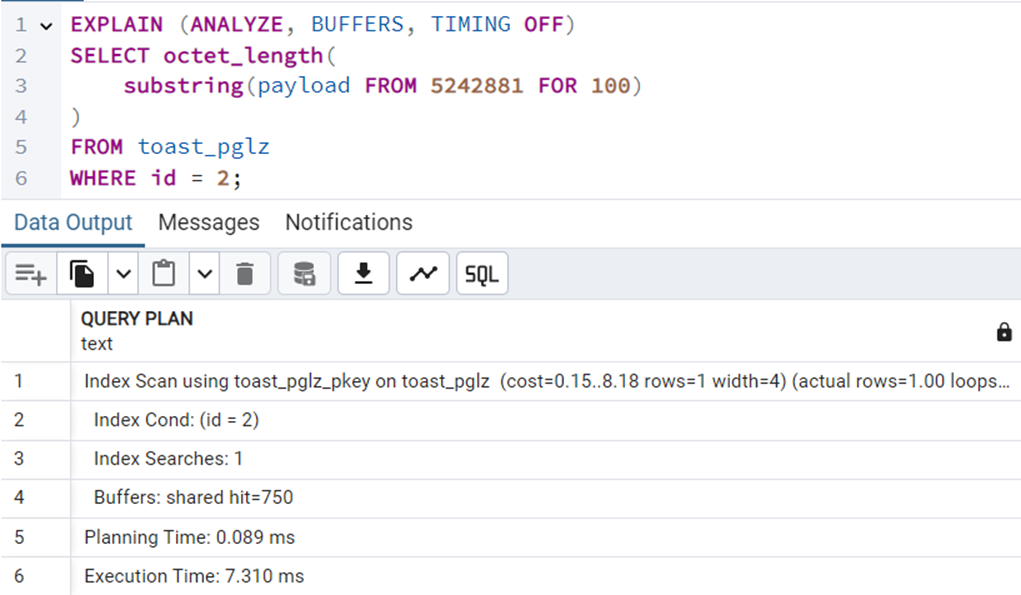
BUFFERS показывает, сколько страниц PostgreSQL пришлось затронуть при выполнении запроса. shared hit означает, что нужная страница уже находилась в общем буферном кэше PostgreSQL, поэтому читать её с диска не пришлось.
Получили:
PGLZ, начало:
Buffers: shared hit=5
Execution Time: 0.051 ms

PGLZ, 50%:
Buffers: shared hit=750
Execution Time: 7.310 ms

PGLZ, 90%:
Buffers: shared hit=750
Execution Time: 10.658 ms
Execution Time — итоговое время выполнения запроса, которое сообщает EXPLAIN ANALYZE. Оно включает выполнение плана запроса, но не время его планирования и не передачу результата по сети клиенту. Эти одиночные значения времени мы используем только как диагностические, а не как основной замер производительности.
Здесь интересен ещё один момент.
При 50% и 90% количество обращений к страницам уже практически одинаковое — около 750, но время продолжает расти.
Это согласуется с устройством PostgreSQL: даже если необходимая сжатая часть уже была получена, для фрагмента ближе к концу нужно распаковать больше исходных данных. То есть количество затронутых страниц уже перестало увеличиваться, а вычислительной работы всё ещё становится больше.
LZ4: цена появляется уже в начале
У LZ4 картина отличается:
начало → 2,016 ms
50%    → 3,669 ms
90%    → 5,269 ms
Даже запрос первых 100 байт большого сжатого значения оказался заметно дороже, чем у PGLZ.
Это также согласуется с текущей реализацией PostgreSQL 18: для LZ4 сервер сначала получает всё сжатое внешнее значение, поскольку заранее вычислить достаточную часть сжатых данных он сейчас не умеет. После этого распаковка выполняется только до необходимой позиции.
Диагностический тест показал:
LZ4, начало:
Buffers: shared hit=747

LZ4, 50%:
Buffers: shared hit=739

LZ4, 90%:
Buffers: shared hit=739
То есть в отличие от PGLZ большое количество обращений к страницам появляется уже при чтении начала значения.
Значения Execution Time из этих одиночных диагностических запусков мы не сравниваем с результатами основной серии: для итоговой таблицы использовались отдельные 30-секундные прогоны pgbench с пятью повторениями. Здесь EXPLAIN нужен прежде всего для того, чтобы увидеть различие в количестве затронутых страниц.
Почему LZ4 оказался быстрее PGLZ в середине и конце
На основном наборе при offset=50% медианное время составило:
PGLZ → 7,064 ms
LZ4  → 3,669 ms
На отметке 90%:
PGLZ → 10,422 ms
LZ4  →  5,269 ms
В этих двух точках LZ4 на нашем стенде оказался примерно вдвое быстрее PGLZ.
Но превращать это в правило «LZ4 быстрее PGLZ» нельзя.
В начале значения соотношение противоположное: PGLZ оказался почти таким же быстрым, как EXTERNAL, а у LZ4 уже появилась заметная стоимость.
Результат также зависит от конкретных данных, степени их сжатия, размера объекта и позиции запрашиваемого фрагмента.
Корректнее сформулировать вывод так: у
PGLZиLZ4разный профиль стоимости частичного чтения.
PGLZ способен очень дёшево получить небольшой фрагмент около начала значения, поскольку в таком случае PostgreSQL достаточно небольшой начальной части сжатых данных. У LZ4 PostgreSQL сначала получает сжатое значение целиком, поэтому заметная стоимость появляется уже при чтении начала. При движении к концу соотношение может измениться.
А если данные не сжимаются?
Для контроля был создан ещё один 10-MiB объект из последовательности бинарных MD5-значений.
Результат проверки хранения:
Настройка столбца | Размер значения | Фактическое сжатие |
| 10 485 760 B | нет |
| 10 485 760 B | нет |
| 10 485 760 B | нет |
То есть столбцы по-прежнему были настроены на PGLZ и LZ4, но конкретное значение фактически не сохранилось в сжатом виде: pg_column_compression() вернул NULL.
Это нормальное поведение TOAST. Для EXTENDED PostgreSQL сначала пытается сжать значение, но если дальнейшего выигрыша получить нельзя, он не обязан хранить бесполезное сжатое представление.
В контрольных 30-секундных прогонах все три варианта после этого показали очень близкое поведение:
Настройка столбца | Начало | 50% | 90% |
| 0,041 ms | 0,041 ms | 0,041 ms |
| 0,041 ms | 0,043 ms | 0,042 ms |
| 0,042 ms | 0,041 ms | 0,041 ms |
Это не основная серия с пятью повторениями, поэтому таблицу стоит воспринимать как контрольный эксперимент. Но она хорошо показывает важную вещь:
Настройка алгоритма сжатия у столбца и реальное представление конкретного значения — не одно и то же.
Столбец может быть настроен на LZ4 или PGLZ, но конкретное значение в нём при этом оказаться несжатым. Перед оптимизацией поэтому полезно проверить реальные данные:
SELECT
    pg_column_size(payload),
    pg_column_compression(payload),
    pg_column_toast_chunk_id(payload)
FROM table_name;
Размер значения тоже имеет значение
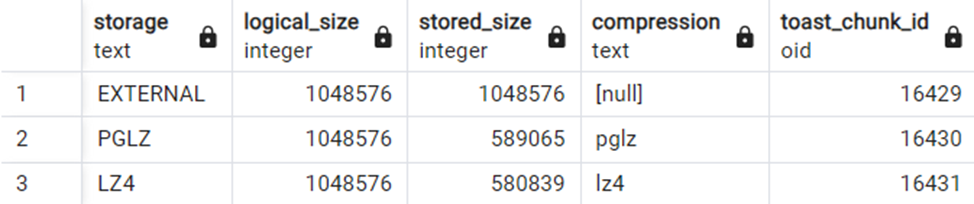
Для ещё одной контрольной проверки тот же умеренно сжимаемый набор был уменьшен с 10 MiB до 1 MiB.
Получили:
PGLZ → 589 065 B
LZ4  → 580 839 B
При чтении 100 байт контрольный прогон дал:
Storage | Начало | 50% | 90% |
| 0,040 ms | 0,039 ms | 0,039 ms |
| 0,040 ms | 0,747 ms | 0,890 ms |
| 0,040 ms | 0,747 ms | 0,894 ms |
На объекте размером 1 MiB различие PGLZ и LZ4 в итоговом времени практически исчезло. При этом внутренний путь всё ещё был разным. Для чтения первых 100 байт EXPLAIN показал:
PGLZ:
Buffers: shared hit=5
Execution Time: 0.080 ms

LZ4:
Buffers: shared hit=78
Execution Time: 0.388 ms
То есть близкое время обычного выполнения ещё не означает, что PostgreSQL проделал внутри одинаковую работу.
Эта проверка была контрольной, а не частью основной серии с пятью повторениями. Поэтому её задача — показать направление эффекта, а не дать универсальные численные коэффициенты.
Что получилось в итоге
Рекомендация документации по поводу EXTERNAL имеет понятное техническое основание.
На нашем стенде чтение 100 байт из несжатого 10-MiB значения практически не зависело от того, находился фрагмент в начале, середине или ближе к концу. PostgreSQL мог получать непосредственно необходимую часть TOAST.
Цена EXTERNAL — отсутствие сжатия. На основном наборе это означало около 10 MiB хранения против примерно 5,8 MiB при PGLZ или LZ4.
PGLZ показал другой профиль. Чтение небольшого фрагмента в начале оказалось очень дешёвым, потому что PostgreSQL было достаточно небольшой начальной части сжатых данных. Чем дальше находился запрашиваемый фрагмент, тем больше сжатых данных требовалось получить и тем больше исходных данных — распаковать.
LZ4 в PostgreSQL 18 работает иначе. Для внешнего сжатого значения сервер сначала получает всё сжатое представление даже тогда, когда нужен небольшой фрагмент в начале. Поэтому у больших объектов появляется заметная начальная стоимость. При этом на нашем наборе LZ4 оказался быстрее PGLZ для фрагментов в середине и ближе к концу.
Самый практический вывод при этом не в том, что нужно всегда выбирать один конкретный режим.
По одной только настройке столбца нельзя заранее определить реальную стоимость частичного чтения.
На неё влияют:
сжалось ли конкретное значение вообще;
насколько сильно оно сжалось;
размер самого значения;
положение требуемого фрагмента;
используемый алгоритм сжатия;
характер запросов приложения.
В PostgreSQL для этого есть два отдельных параметра. STORAGE определяет общую стратегию хранения столбца — например, разрешено ли выносить значение в TOAST и разрешено ли его сжимать. COMPRESSION задаёт алгоритм сжатия, который будет использоваться там, где выбранная стратегия хранения разрешает сжатие.
Поэтому перед изменением STORAGE или COMPRESSION разумно сначала посмотреть, как фактически хранятся реальные значения, а затем измерить типичные для приложения запросы.
Документация PostgreSQL справедливо указывает, что EXTERNAL может ускорять substring() для больших text и bytea. Но за этой короткой рекомендацией скрывается более интересная картина: для сжатого TOAST стоимость частичного чтения зависит не только от размера возвращаемого фрагмента, но и от того, каким способом PostgreSQL должен до него добраться.
Ограничения эксперимента
Основная серия измерений выполнялась локально под Windows с одним клиентом и одним потоком на прогретом сервере PostgreSQL.
Поэтому абсолютные значения времени нельзя воспринимать как норматив для другого компьютера или сервера.
В выводе pgbench параметр latency average — это среднее время выполнения одной транзакции с точки зрения клиента pgbench. Поскольку наш тестовый сценарий состоял из одного SELECT, эта величина в нашем случае отражает среднее время одной тестовой операции.
Для нас важны прежде всего относительные различия между режимами при одинаковых данных и одинаковых условиях.
Основной эксперимент с 10-MiB умеренно сжимаемым объектом повторялся пять раз для каждой точки, и в статье используется медиана. Дополнительные эксперименты с несжимаемыми данными и объектом размером 1 MiB использовались как контрольные и не имеют той же статистической силы.
Мы также не исследовали высокую конкурентную нагрузку и сценарий чтения «с холодного диска» — ситуацию, когда нужных страниц ещё нет в кэше и их приходится получать с накопителя. Не сравнивались и разные типы накопителей. Для этих вопросов потребовался бы отдельный тестовый стенд.
Наконец, статья описывает PostgreSQL 18.6 и текущую реализацию ветки PostgreSQL 18. Внутреннее устройство TOAST и оптимизации частичного чтения могут измениться в будущих версиях.