Кто-то уже указывает на предвзятость и пропаганду, скрытые за обучающими данными этих моделей: кто-то тестирует их и проверяет практические возможности таких моделей.
Лично я получил еще одно подтверждение своему прогнозу: Китай выиграет ИИ-гонку!
Эта статья посвящена новому семейству рассуждающих моделей DeepSeek-R1-Zero и DeepSeek-R1: в частности, самому маленькому представителю этой группы.

DeepSeek-R1 с открытым исходным кодом и конкурирует с моделью o1 от OpenAI
В сообществе Generative AI поднялась шумиха после того, как лаборатория DeepSeek-AI выпустила свои рассуждающие модели первого поколения, DeepSeek-R1-Zero и DeepSeek-R1. Сейчас уже накопилось столько хвалебных отзывов, но и столько критики, что можно было бы написать целую книгу.
Кстати, название этого раздела взято прямо с официального сайта DeepSeek. Для меня это все еще претензия.

Deepseek-R1 - это модель Mixture of Experts, обученная с помощью парадигмы отражения, на основе базовой модели Deepseek-V3. Это огромная модель, с 671 миллиардом параметров в целом, но только 37 миллиардов активны во время вывода результатов.
Согласно их релизу, 32B и 70B версии модели находятся на одном уровне с OpenAI-o1-mini. А вот и настоящее достижение (на мой взгляд...) этой китайской ИИ-лаборатории - они создали шесть других моделей, просто обучив более слабые базовые модели (Qwen-2.5, Llama-3.1 и Llama-3.3) на R1-дистиллированных данных.
Если вы не понимаете, о чем идет речь, то дистилляция - это процесс, когда большая и более мощная модель «обучает» меньшую модель на синтетических данных.
Но пробовали ли вы их?
Я протестировал сам, и вот что я могу вам сказать. Все логи и код для самостоятельного запуска находятся в моем репозитории на GitHub.
Вот результаты моего личного бенчмарк-теста
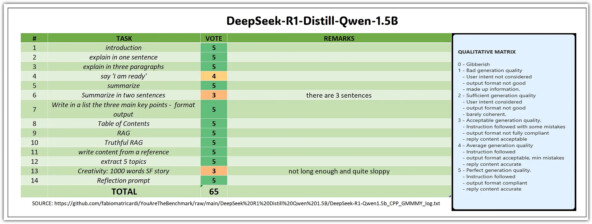
Рассуждающие модели
Начало рассуждающих моделей - это промпт Reflection, который стал известен после анонса Reflection 70B, лучшей в мире модели с открытым исходным кодом. Обучается с помощью Reflection-Tuning - техники, разработанной для того, чтобы дать возможность LLM исправить свои собственные ошибки.
Это довольно недавняя тенденция как в научных работах, так и в техниках промпт-инжиниринга: мы фактически заставляем LLM думать. Если говорить точнее, генеративные ИИ-модели являются слишком быстрыми!
Генерация и предсказание следующего токена дает слишком большое вычислительное ограничение, ограничивающее количество операций для следующего токена количеством уже увиденных токенов.
В этой замечательной статье "Think before you speak: Training Language Models With Pause Tokens" предлагается добавить так называемый токен <пауза> как во время предварительного обучения, так и во время вывода, чтобы дать модели больше времени на „размышление“. И результаты поражают!
Мы эмпирически оцениваем обучение с паузами на моделях декодера с параметрами 1B и 130M с предварительным каузальным обучением на C4, а также на последующих задачах, включающих рассуждения, ответы на вопросы, общее понимание и запоминание фактов. Наш основной вывод заключается в том, что задержки во времени вывода показывают прирост, когда модель как предварительно обучена, так и тонко настроена с помощью задержек. Для модели 1B мы наблюдаем прирост в 8 из 9 задач, наиболее заметным из которых является прирост в 18 % баллов EM в задаче QA в SQuAD, 8 % в CommonSenseQA и 1 % точности в задаче рассуждения в GSM8k.
Изначально Reflection 70B обещали еще в сентябре 2024 года, о чем Мэтт Шумер сообщил в своем твиттере: его модель, способная выполнять пошаговые рассуждения. По словам автора, техника, лежащая в основе Reflection 70B, простая, но очень мощная.
Современные LLM склонны к галлюцинациям и не могут распознать, когда они это делают. Reflection-настройка позволяет LLM признавать свои ошибки и исправлять их, прежде чем ответить.
Модель доступна на Hugging Face Hub и была обучена с помощью Llama 3.1 70B Instruct на синтетических данных, сгенерированных Glaive. По всей видимости, все похвалы должны быть отданы специальной технике промптов. Давайте посмотрим:
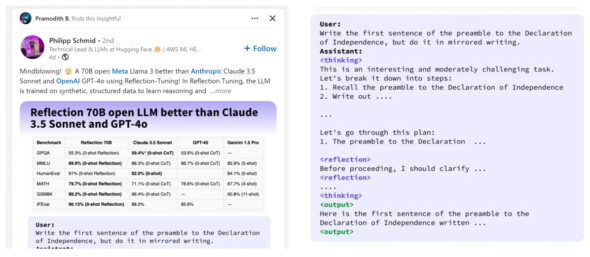
Вот это да. Похоже, что просьба к модели подумать и поразмыслить, прежде чем выдать результат, расширяет возможности рассуждения и уменьшает количество ошибок.
DeepSeek-R1 - это не то же самое
Эти модели размышляют «вслух», прежде чем сгенерировать конечный результат: и этот подход очень похож на человеческий.
Правда, парадигма Reflection положила начало этому процессу (документ, правда, датируется 2023 годом...), но DeepSeek придерживается другого подхода:
В этой работе мы делаем первый шаг к улучшению способности языковых моделей к рассуждениям с помощью чистого обучения с подкреплением (RL). Наша цель - исследовать потенциал языковых моделей в развитии способности к рассуждениям без каких-либо контролируемых данных, сосредоточившись на их саморазвитии в процессе чистого RL. - из источника
Модель проходит посттренинг с масштабированием времени вывода за счет увеличения длины процесса рассуждений Chain-of-Thought. Это реальная тенденция последнего времени: в последнее время посттренинг стал важным компонентом полного цикла обучения. Было показано, что оно повышает точность решения задач рассуждения, согласуется с социальными ценностями и адаптируется к предпочтениям пользователя, при этом требуя относительно минимальных вычислительных ресурсов по сравнению с предварительным обучением.
Но я должен сказать: это действительно раздражает!

Раздражающие и многословные ответы
Может быть, это действительно хорошая идея - показать лимиты и шаги, которые делает большая языковая модель, прежде чем прийти к ответу (как процесс DEBUG в тестировании программного обеспечения). Но на каждое взаимодействие, даже тривиальное, я получаю кучу (бесполезных) слов из цепочки размышлений.
Если я поприветствую модель:
Интересные статьи
Интересные статьи