Вообще правильно статья должна называться “Какие SEO-факторы влияют на GEO”. Так будет точнее. Так как отдельных факторов оптимизации сайта под нейросети не существует.
А еще есть проблема в том, что мы смешиваем две разные задачи. Одна - чтобы нейросеть нашла страницу, сослалась на неё и привела посетителя. Другая - чтобы она вообще знала компанию и рекомендовала её в ответах. У этих задач есть общая база, но механика и метрики разные.
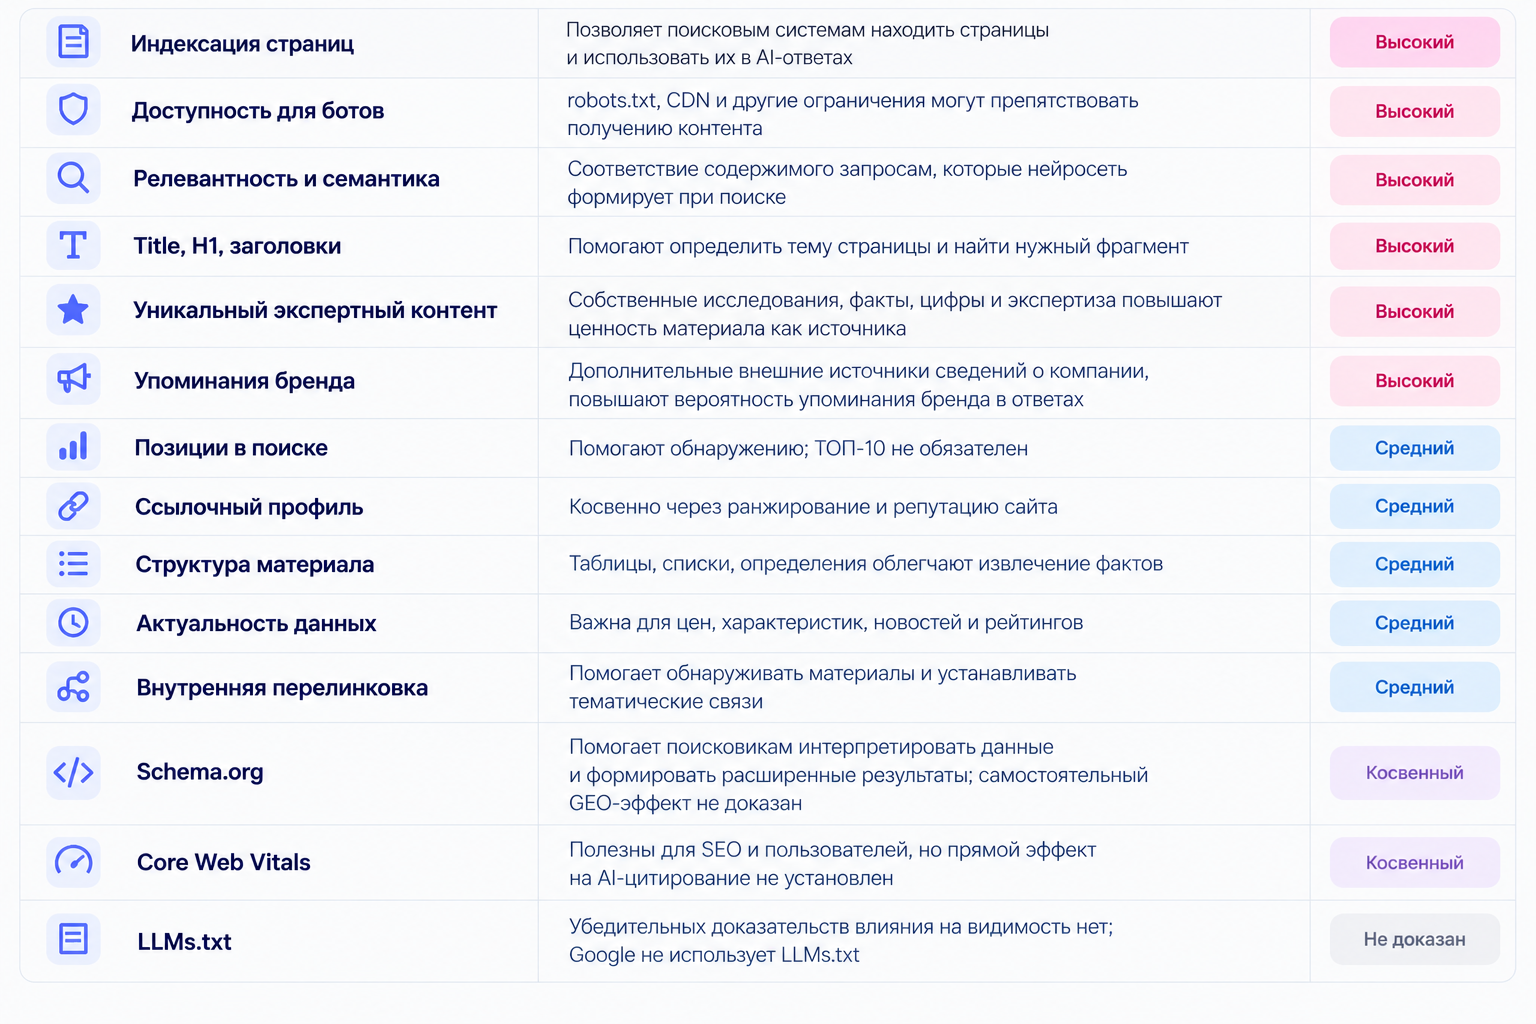
Я составил таблицу, в которой расставил SEO-факторы по значимости для GEO. Это моё текущее видение и практическая расстановка приоритетов на октябрь 2026 года, а не опубликованные данные алгоритмов ChatGPT, Google или Алисы. Ниже сначала покажу всю картину, а затем разделю факторы по двум сценариям продвижения.
Все факторы GEO: моя текущая оценка
Высокое влияние
Индексация страниц; доступность контента для поисковых и AI-ботов; релевантность и семантика; Title, H1 и заголовки; уникальный экспертный контент с данными; упоминания бренда на внешних площадках. Первые пять преимущественно помогают находить и цитировать страницы. Последний особенно важен для узнавания и рекомендации компаний.
Среднее влияние
Позиции в обычной поисковой выдаче, ссылочный профиль, структура материала, актуальность данных и внутренняя перелинковка. Они помогают разными путями: через обнаружение страниц, SEO-видимость, извлечение конкретных фрагментов и поддержку доверия к информации. Но назвать любой из них гарантированным «фактором ранжирования нейросети» нельзя.
Косвенное или недоказанное влияние
Schema.org и Core Web Vitals - косвенные факторы; убедительный самостоятельный эффект llms.txt на AI-цитирование не доказан никем. Сами по себе таблица, FAQ-блок, микроразметка или хорошая оценка скорости не заставят нейросеть выбрать конкретную страницу.
Один и тот же SEO-фактор может помогать в одном сценарии и почти ничего не давать в другом. Поэтому дальше разберу отдельно продвижение страниц и продвижение бренда.
Часть 1. Факторы для сайта: стать источником и получать трафик
Здесь мы оптимизируем URL, а не абстрактную известность компании. Для сайта нужно пройти несколько этапов: страница должна быть доступна → нейросеть или её поиск должны её обнаружить → система должна выбрать документ как источник → пользователь должен увидеть ссылку и захотеть перейти. Четвёртый этап не следует автоматически из третьего: даже процитированная статья может не получить ни одного перехода. Более того, попадание в источник не гарантирует что информация с вашего сайта будет взята и использована.
1. Индексация и доступность - без этого остальное не имеет смысла
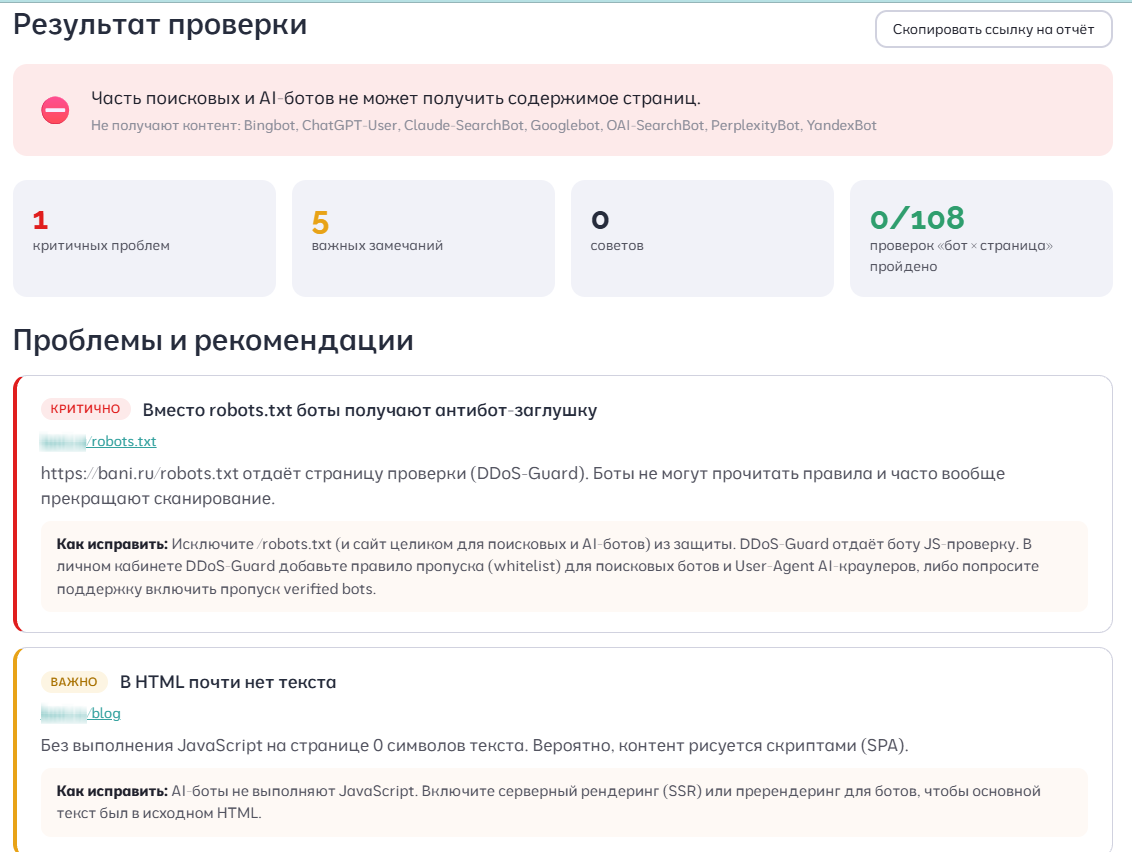
Начинаю с SEO-базы: проверяю, индексируются ли нужные URL в Google и Яндексе, разрешён ли обход robots.txt, нет ли noindex, некорректных canonical, ошибок HTTP, ловушек JavaScript и защитных фильтров CDN/WAF. Отдельно смотрю, могут ли получать контент нужные боты. Возможность попасть в поисковый индекс и возможность прямого чтения AI-ботом вещи разные.
Google прямо указывает, что для появления страницы среди ссылок AI Overviews и AI Mode она должна индексироваться и быть допустимой к показу со сниппетом. Никаких отдельных технических требований сверх базовых требований Google Search компания не заявляет. В других AI-системах маршрут поиска может отличаться, с той лишь разницей что используют существующий поисковый индекс той или иной поисковой системы
Источник: Google Search Central - AI features and your website
Пример проблемы
2. Семантика, Title и H1 - отвечать на тот вопрос, который нейросеть действительно ищет
Нейросеть может не искать буквально то, что пользователь написал ей в чат. Она формирует дополнительные запросы (query fan-out), разбивает сложный вопрос на подтемы, получает разные наборы страниц, а затем выбирает источники. Поэтому для GEO мало знать одну позицию своего URL по исходной ключевой фразе.
В исследовании AirOps и Kevin Indig (13 апреля 2026 года) изучили 16 851 запрос, три прогона каждого и 353 799 страниц в цепочке поиска ChatGPT. Страницы с заголовками, наиболее близкими по смыслу к пользовательскому запросу, цитировались в 41,0% случаев против примерно 30% для слабо совпадающих заголовков. Это статистическая связь в исследованной выборке если что.
Поэтому строим статьи и посадочные не вокруг бессмысленно широкой подборки LSI-слов, а вокруг конкретных вопросов. Title и H1 должны чётко обозначать предмет, а содержание - давать ответ, который поисковая подсистема сможет распознать и извлечь. Ничего нового, правда?)
AirOps / Kevin Indig - The Fan-Out Effect
3. Экспертный контент и структура - материал должен быть полезным источником
Исследования, собственные расчёты, измеримые результаты, сравнительные таблицы, определения и описания методики дают странице фактуру, которую имеет смысл пересказывать или цитировать. Ценность возникает, когда материал действительно отвечает на запрос и содержит проверяемые сведения.
А еще AirOps обнаружил, что при высокой релевантности исходному вопросу умеренное покрытие дополнительных подзапросов могло работать лучше попытки закрыть все возможные подтемы. То есть не нужно превращать каждую статью в энциклопедию только ради GEO. Таблицы, списки и короткие смысловые блоки полезны там, где помогают структурировать факты.
Актуальность данных важна прежде всего там, где информация быстро меняется: цены, тарифы, характеристики, рейтинги, новости. Обновление даты публикации без изменения содержания так себе затея.
4. SEO-позиции: ТОП-10 помогает, но не является обязательным условием
Здесь необходимо различать два ранжирования. Первое - позиции по исходному запросу в Google или другом поисковике. Второе - место URL среди результатов, которые получила сама нейросеть по своим поисковым подзапросам.
AirOps показал сильную зависимость цитирования от второго: для первой позиции во внутренней выдаче ChatGPT доля цитирования была 58,4%, для десятой - 14,2%. А Ahrefs, изучив 863 тысячи поисковых выдач и около 4 млн URL в Google AI Overviews, обнаружил, что только 37,9% процитированных URL входили в первые десять блоков обычной поисковой выдачи по исходному запросу. Ещё 31,2% находились на позициях 11–100, а 31,0% не было в первых ста блоках.
При этом помним что та же Алиса в поиске, вообще редко выходит за пределы ТОП10
Получается, хорошие SEO-позиции не потеряли ценность, но без них можно получать результат. Вот почему в моей таблице позиция в классической выдаче - средний фактор, а релевантность запросам нейросети - высокий.
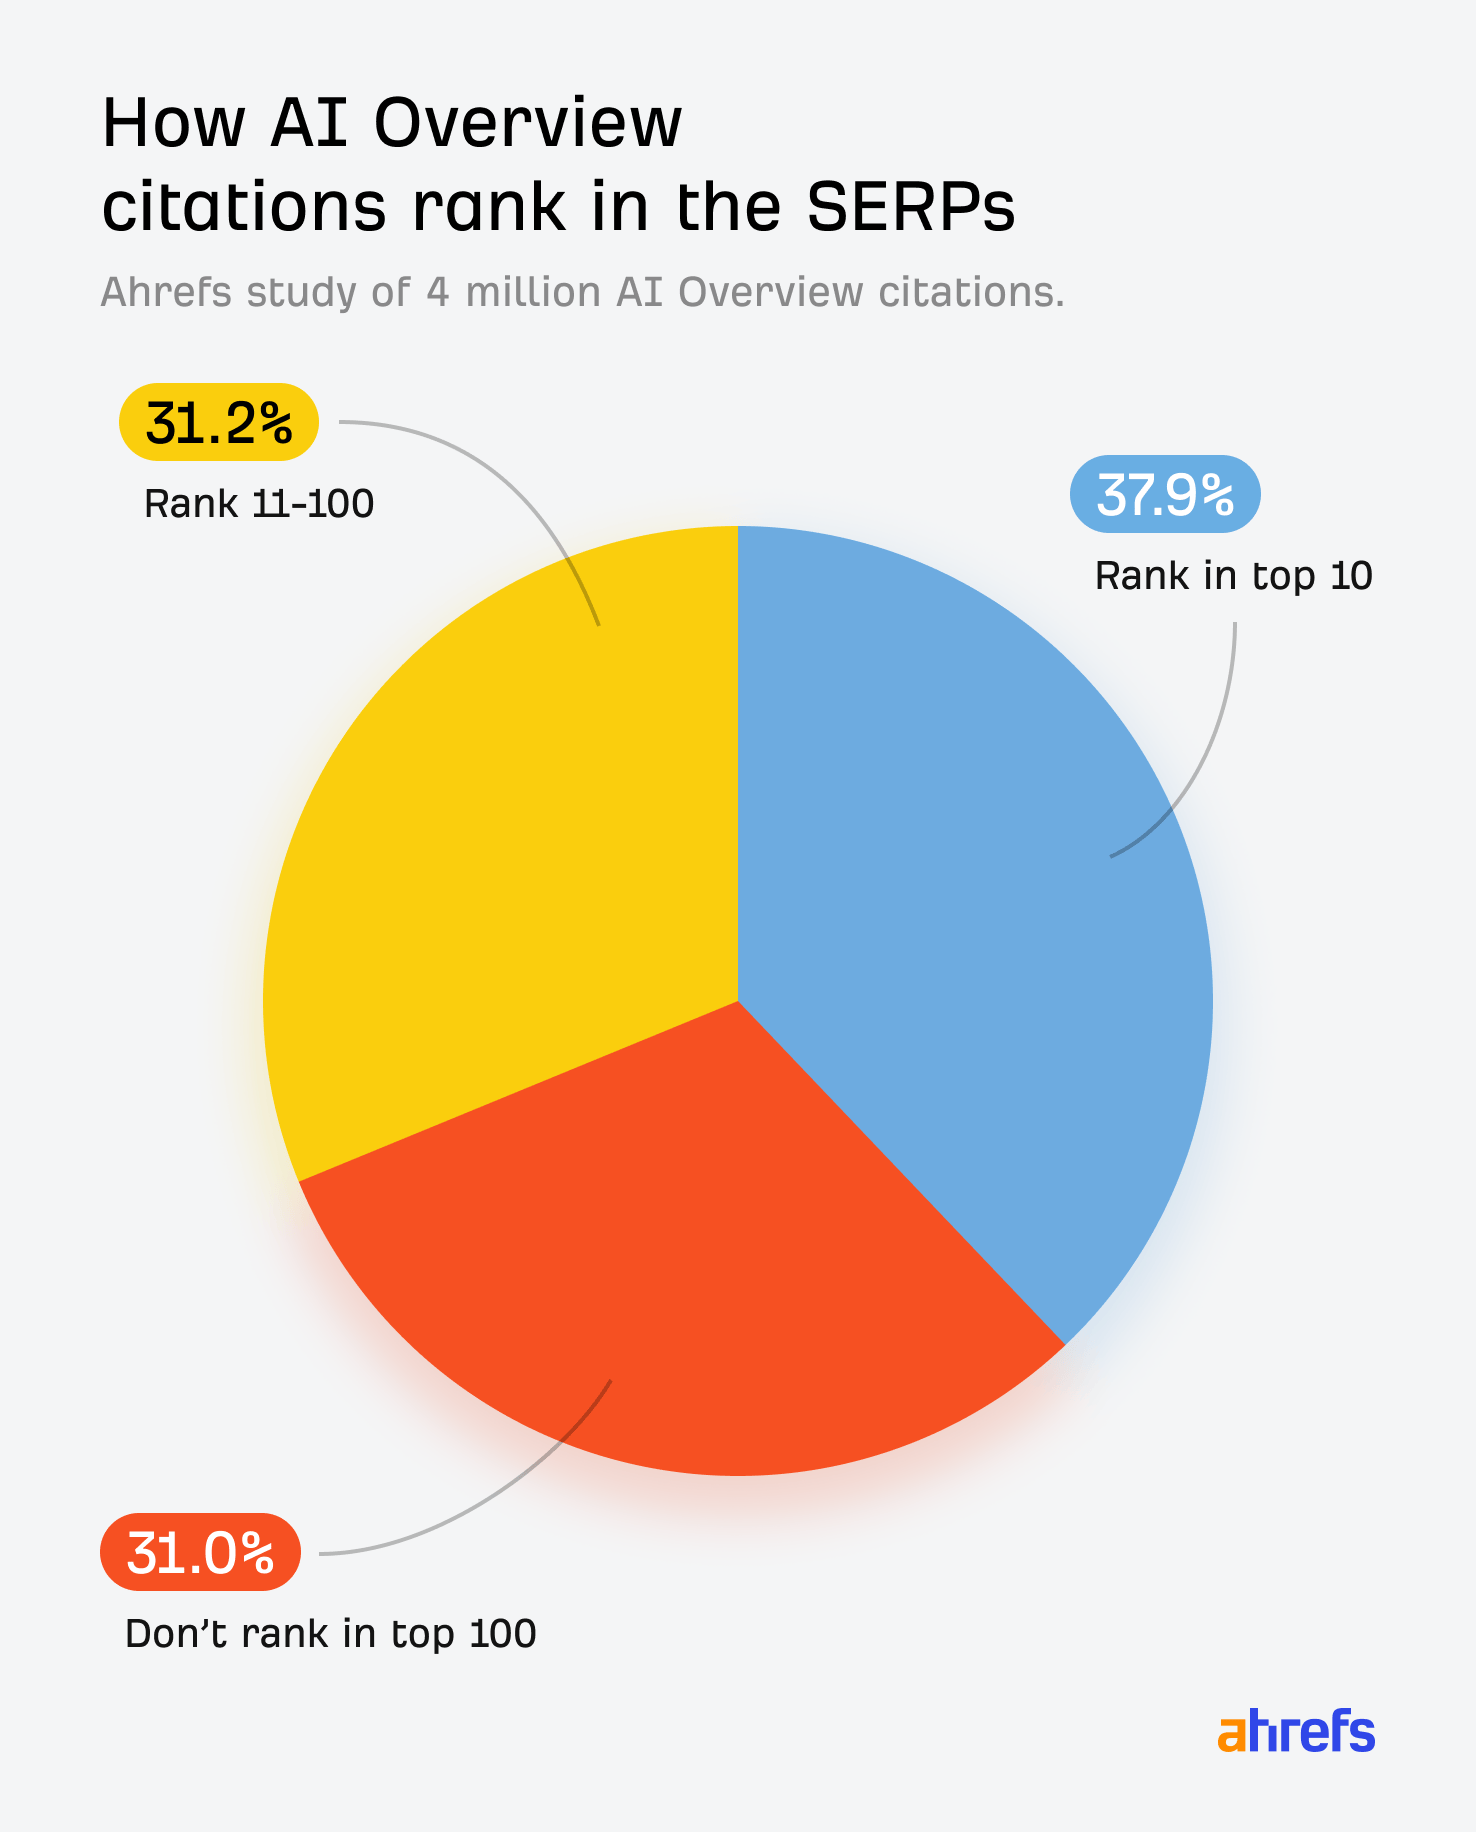
Ahrefs - 38% of AI Overview Citations Pull From The Top 10
5. Ссылочный профиль и внутренняя перелинковка - полезная SEO-база
Внешние ссылки могут способствовать обнаружению контента, SEO-ранжированию и известности публикации. Внутренние ссылки помогают роботам находить документы и понимать связи между ними. Но их нельзя считать прямой кнопкой увеличения AI-цитирования. В моих исследованиях доменный авторитет и объём обратных ссылок не показали положительной корреляции с цитированием нейросетями. Мой приоритет в проектах: исправить внутренние связи важных страниц, затем работать с содержимым.
6. Schema.org, Core Web Vitals и llms.txt
Schema.org может помочь поисковым системам интерпретировать данные и формировать расширенные результаты. Но доказанного самостоятельного причинного эффекта на AI-цитирование у нас нет. В AirOps у страниц с JSON-LD наблюдалась более высокая доля цитирований, однако подобные сравнения не позволяют утверждать, что разметка сама вызвала этот результат.
У меня есть теория что это расширяя спиппет дает больше слов в него, и нейронки на первом шаге анализа считывают именно сниппеты, и только лучшие попадают в выборку сайтов-источников. Но данная мысль требует отдельных проверок, я их еще не закончил.
Core Web Vitals имеют значение для удобства сайта и общего SEO в плане поведенческих факторов, но корреляцию между улучшением LCP и ростом цитирования AI пока нельзя считать установленной. Не путайте метрики пользовательского опыта со способностью бота получить основной текст: доступность и корректный HTTP-ответ важны по другой причине.
llms.txt тоже не стоит продавать как работающий приём GEO. Google не объявлял его дополнительным требованием для AI Overviews и AI Mode; убедительного подтверждения роста AI-цитирований от создания этого файла нет. Множенство экспериментов это показало.
Почему нейросеть цитирует одни страницы, а другие нет
Исследователи Mahe Chen и Nick Koudas проанализировали 158 099 ответов и 468 037 цитирований. Они сравнили страницы внутри одних и тех же сайтов, чтобы отделить особенности отдельных материалов от известности домена.
Оказалось, что ChatGPT сначала находил страницу через собственный поиск и только потом мог её процитировать. Причём поисковые запросы нейросеть формулирует сама - они могут отличаться от исходного вопроса пользователя.
Авторы построили статистические модели. То, насколько часто URL попадал во внутренний поиск ChatGPT и как высоко располагался в результатах, помогало объяснить 32% различий в количестве цитирований страниц одного сайта. Характеристики страниц - заголовки, содержание, FAQ, Schema.org и другие - объясняли только 2,8%.
Представим вопрос: «Какой биллинг выбрать оператору связи?» Нейросеть может отдельно искать сведения о тарификации, функциях и ограничениях разных систем. Если вашу статью вообще не нашла, дополнительная микроразметка не сделает её источником этого ответа. При этом релевантность текста по-прежнему важна: страницы, чьи заголовки и абзацы лучше отвечали на вопросы, цитировались чаще.
Мой вывод: прежде чем добавлять специальные «GEO-блоки», надо проверять, какие запросы делает нейросеть, какие URL находит и соответствует ли наш материал этим запросам.
Chen & Koudas - What Drives AI Citations? (препринт, 10.10.2026)
Часть 2. Факторы для бренда: что делать чтобы нейросеть называла и рекомендовала компанию
Теперь другая задача. Пользователь может спросить: «какую компанию выбрать», «какие сервисы решают такую задачу», «назови альтернативы продукту X». Нейросеть отвечает названиями организаций и продуктов. При этом она вовсе не обязана указывать сайт каждой из них среди источников и тем более приводить посетителя на этот сайт.
Поэтому для бренда важнее есть ли у модели достаточно сведений о компании, в каком контексте она встречается, с какими задачами её связывают и насколько уместно рекомендовать её по конкретному вопросу.
1. Внешние упоминания
Ahrefs в декабре 2025 года исследовал 75 тысяч брендов и обнаружил сильную корреляцию между количеством их упоминаний в интернете и присутствием в ответах ChatGPT, AI Mode и AI Overviews: примерно 0,66–0,71. С упоминаниями на YouTube корреляция была ещё выше - около 0,737. Зависимость от традиционных показателей вроде Domain Rating или числа страниц сайта оказалась слабее.
Известные бренды и чаще упоминаются, и чаще встречаются в запросах. Здорово, правда?)
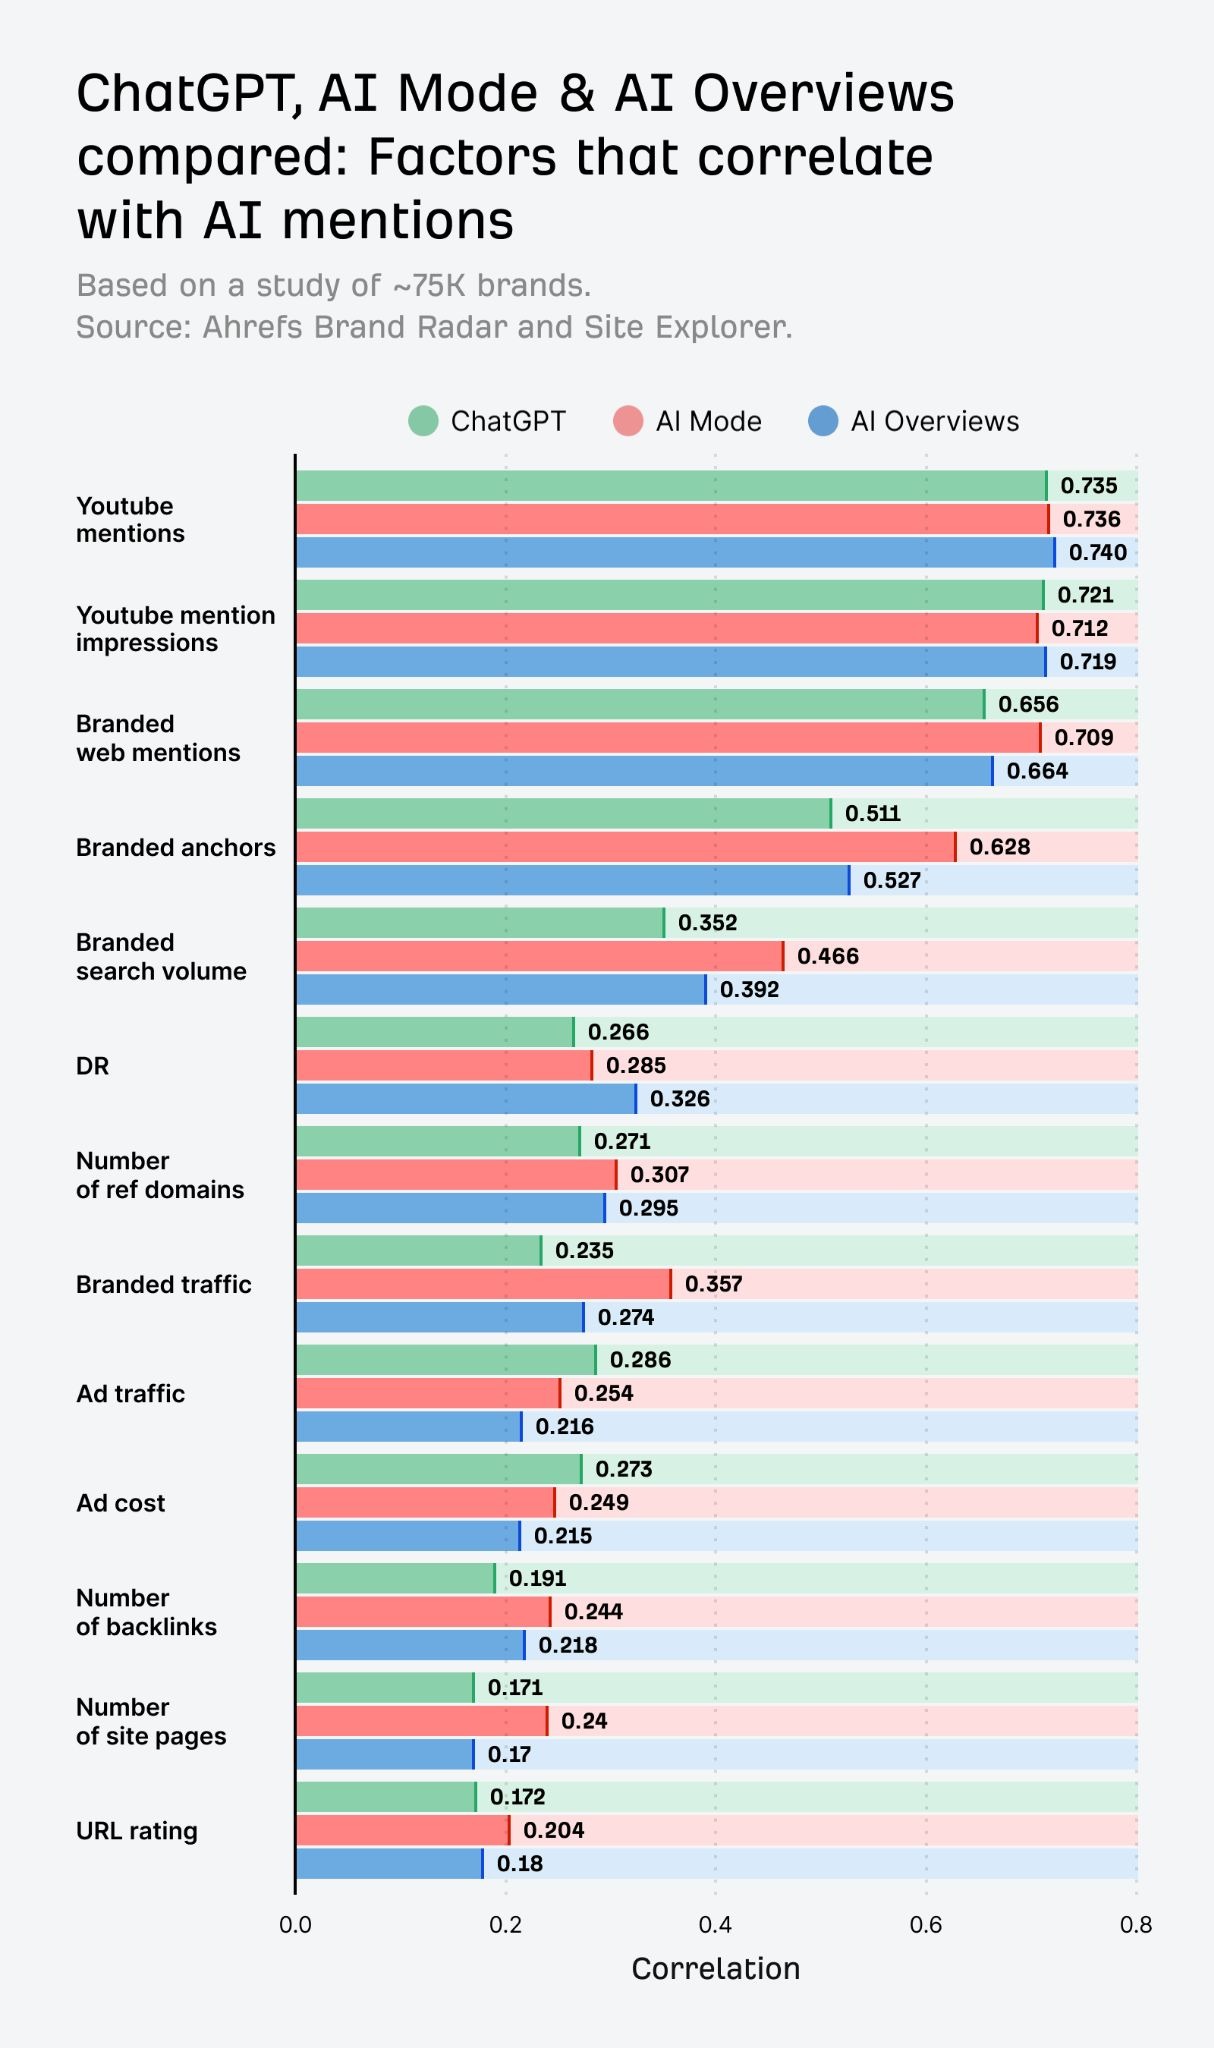
Ahrefs - Top Brand Visibility Factors in ChatGPT, AI Mode, and AI Overviews
Позднее это подтвердилось и собственной практикой и другими исследованиями. Основной метрикой будет число упоминаний бренда в сети. Статьи, СМИ, соцсети, отзывы, видео и пр. Просто наличие бренда и описание его продукта, деятельности, сравнения и так далее.
2. Где и как упоминать бренд
Я работаю обычно не столько ради числа публикаций, а ради полноты присутствия в ситуациях выбора. Отраслевые СМИ, профильные обзоры, рейтинги, экспертные комментарии, видео, интервью, тематические сообщества, содержательные отзывы и материалы независимых авторов. Формат площадки выбираем по тому, где будущий покупатель ищет подтверждения и где нейросети находят релевантные данные.
Важнее, чтобы бренд упоминался вместе с конкретной компетенцией, категорией товара, проблемой клиента, характеристикой продукта, ценой, географией или сравнением. Но прямых универсальных коэффициентов для этих форматов пока нет.
3. Позиционирование и знания модели
Знания модели о брендах могут влиять на то, какие поисковые запросы она формулирует и какие компании называет. В контролируемых экспериментах название знакомого бренда могло менять порядок рекомендаций при одинаковых характеристиках продуктов. А еще упоминание бренда может возникнуть и без ссылки на конкретную страницу в ответе.
Значит, для продвижения бренда нужны устойчивые связи «название → категория → задачи → отличия → доказательства». Их формирует не только сайт, но и внешняя информационная среда. Это не повод обещать, что можно оперативно «переобучить» ChatGPT публикациями. Эффект от индексации поисковиками информации быстрее; чем изменение знаний модели.
4. Зачем бренду всё-таки собственный сайт
Сайт должен подтверждать сведения, которые встречаются о компании снаружи: чем она занимается, какие продукты предлагает, где работает, сколько стоят решения, какие есть ограничения, кейсы и отзывы. Если внешняя статья говорит одно, а карточка продукта - другое, нейросети сложнее собрать непротиворечивый ответ.
Здесь снова помогают правильные заголовки, семантика и экспертный контент, но уже как часть общей базы знаний о бренде. Их роль отличается от цели «вывести статью в источники»: мы повышаем вероятность корректной идентификации и уместной рекомендации компании.
5. Что считать результатом GEO для бренда
Я бы разделял:
долю проверяемых запросов, где бренд упоминается;
долю по сравнению с конкурентами;
наличие положительных и отрицательных искажений;
число запросов где наш сайт истчоник информации;
переходы на сайт из отдельных нейросетей;
если не занимаетесь SEO параллельно, то рост поискового трафика можете себе в + засчитать, так как клики в поиске по источникам нейроответов в метрике видны как “поисковый трафик”
Измерять нужно на устойчивом наборе реальных вопросов и по конкретным нейросетям: ChatGPT, Gemini, Perplexity, Алиса и другие системы ищут и формируют ответы по-разному.
Как я бы разделил работы на проекте
Если задача - трафик и цитирование сайта
Начать с индексирования и доступности ботов → изучить реальные вопросы аудитории и поисковые подзапросы нейросетей → привести Title, H1 и содержание в точное соответствие интенту → добавить уникальную фактуру → обеспечить удобную структуру и перелинковку → замерять источники, переходы и конверсии.
Если задача - упоминание и рекомендация бренда
Определить ситуации выбора и конкурентов → проверить, что именно нейросети знают о компании → устранить несоответствия на официальных страницах → получить содержательные независимые упоминания в релевантных источниках → отслеживать не только само появление названия, но и контекст, точность и изменения относительно конкурентов.
Вывод
Для сайта главная задача - стать найденным и выбранным источником, а затем получить переход. Для бренда - стать известной и уместной рекомендацией в конкретной ситуации выбора.
Это моя текущая модель GEO-факторов. По мере появления воспроизводимых исследований и результатов собственных экспериментов её приоритеты могут измениться. И если кто-то покажет контролируемое влияние микроразметки или CWV на цитирование и рекомендации при прочих равных - с интересом посмотрю.