Здесь я представляю поверхностный обзор статьи, вышедшей в уже далёком (по научным меркам) 2019-м году: "Representation Learning in Heterogeneous Professional Social Networks with Ambiguous Social Connections". Т. к. это лишь поверхностный обзор, от читателя требуются следующие познания:
Skip-gram и его адаптация под графы (word2veс, LINE, DeepWalk);
общие понятия о графах знаний.
В указанной статье частично представлена структура графа LinkedIn’s Economic Graph и относительно подробно описан метод обучения эмбеддингов Star2Vec. К сожалению, исходного кода авторы не предоставили, поэтому в статье есть несколько непонятных моментов (лично для меня), на которые я укажу ниже.
LinkedIn’s Economic Graph
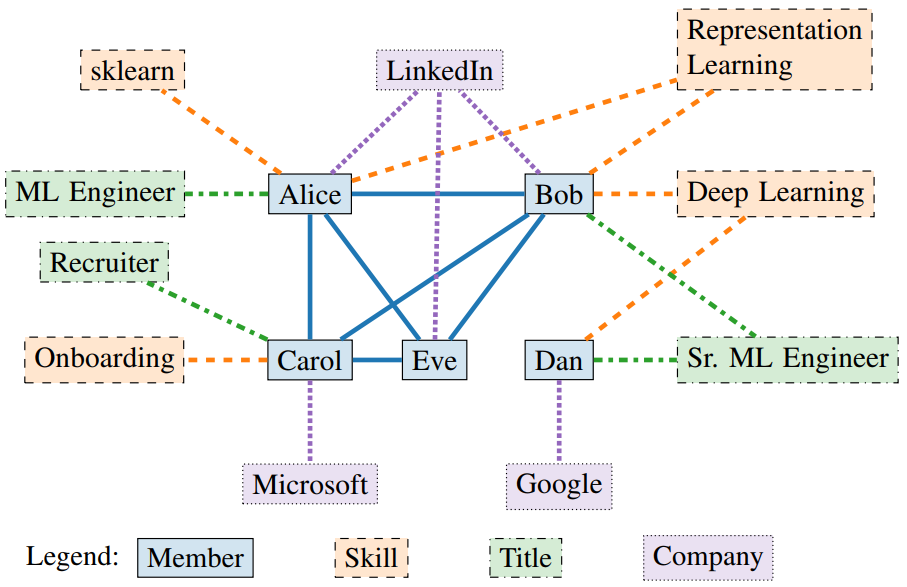
Начнём с графа. Его структура немного необычна. Напомню, что граф знаний – это мультиграф, т. е. граф, в котором несколько типов сущностей и рёбер. Особенность графа в LinkedIn заключается в том, что эти типы также разбиваются на группы. Типы сущностей делятся на две группы:
Person (пользователи);
Entity (non-Person, все остальные типы сущностей).
Соответственно, типы рёбер делятся на
Person-to-Person;
Person-to-Entity.
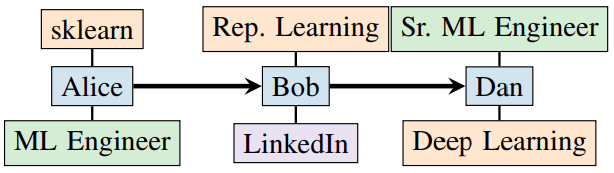
И, главное, non-Person сущности не могут быть связаны между собой напрямую: только через Person-узлы! Для наглядности посмотрите на рисунок из статьи.
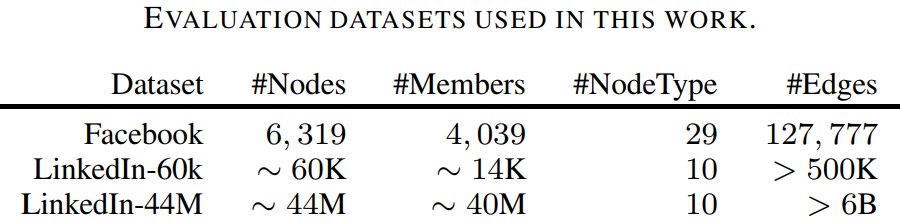
Датасет, на котором проверяется нижеописанный метод, содержит 44 миллиона узлов (из них 40 млн. Person-узлов), 10 типов узлов и 6 млрд. рёбер. Внушительный объём, но на сайте проекта уже говорится о графе с ~800 млн. узлов. К сожалению, не сказано, сколько отношений в графе и не перечислены все 10 типов узлов. Представлена также и мини-версия датасета, состоящая из 60 тыс. узлов. Дополнительно авторы используют общедоступный датасет из данных Facebook, но его я не изучал и не освещаю в этом обзоре.
Star2Vec
Теперь перейдём к методу Star2Vec. Напомню, что он разработан на основе Skip-gram, и, следовательно, нуждается в случайных блужданиях. Весь метод можно разделить на три этапа:
I. Генерация случайных блужданий по Person-узлам
II. Расширение сгенерированных случайных блужданий non-Person узлами
III. Skip-gram, который учитывает новую структуру случайных блужданий
Подробнее опишем этапы.
I. Генерация случайных блужданий по Person-узлам. Здесь вычисляются два значения:
а) сила связи между двумя людьми по конкретному Person-to-Person отношению;
б) вероятность перехода от одного человека к другому во время случайного блуждания.
Второе (б) вычисляется через первое (а).
Сила связи между двумя людьми зависит от общего non-Person окружения этих людей. Для каждого Person-to-Person отношения  задаётся множество типов узлов
 которые, как полагается, оказывают большее влияние на связь между людьми (Person-узлами). Например, пусть между людьми есть отношение "коллеги". Тогда для этого отношения резонно определить множество, состоящее из типов узлов "Работодатель" и "Профессия". Т. е., если у двух людей общая работа и профессия, то, скорее всего, они, действительно, коллеги. Как видим, выбор этих типов узлов неоднозначен. Авторы предлагают три способа определения этих множеств:
association rule mining (например, AMIE);
predicate path mining;
определять множества вручную.
Не готов сейчас говорить о первых двух способах, хотя на первый довольно часто ссылаются в статьях о графах знаний. Последний же довольно субъективен и затруднителен в случае большой онтологии.
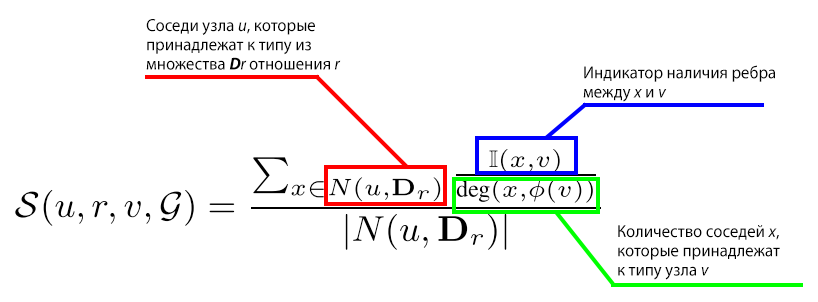
Вероятность перехода от одного человека к другому учитывает как существующие Person-to-Person связи, так и потенциальные. И те, и те оцениваются с помощью силы связи, описанной выше. Таким образом, во время случайного блуждания возможен переход к несмежному узлу в графе.

Итого, после генерации таких блужданий мы имеем подобную структуру:
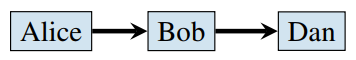
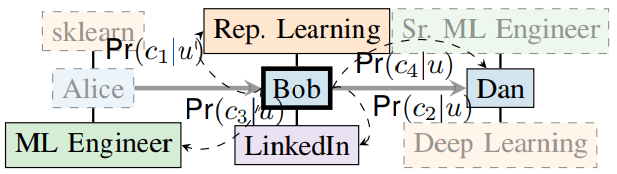
II. Добавление к каждому узлу в сгенерированном случайном блуждании смежных ему [узлу] non-Person узлов. Здесь вводится понятие «звезда» (star-shaped structure), центром которой является Person-узел. По сути, звезда – это эго-сеть, но из которой исключены все Peson-узлы, кроме центрального. Также, звезда ограничена по размеру и отбор конкретных соседей узла в звезду опять неоднозначен. Отправляю читателя самостоятельно почитать статью и разобраться, а в случае осознания – поделиться с нами в комментариях. Так вот, каждый узел в сгенерированном блуждании заменяется на свою звезду, но главными «направляющими» в пути по-прежнему остаются Person-узлы.
III. Skip-gram, учитывающий новую структуру случайных блужданий. В связи с изменённой структурой случайных блужданий необходимо как-то модифицировать Skip-gram. Здесь всё просто. Вместо того чтобы в качестве контекста рассматривать только  Person-узлов сзади и столько же спереди, в контекстное окно включаются и non-Person элементы звёзд. Таким образом, и Person-узлы, и узлы всех остальных типов проецируются в одно общее пространство.
Задачи
Теперь посмотрим, какие задачи решают авторы при помощи полученных векторных представлений.
Много-классовая классификация. В качестве меток используется отрасль (industry), которую указал пользователь.
Кластеризация. Здесь решаются три задачи: кластеризация пользователей по отрасли (industry), кластеризация навыков (skills) по домену (domain, размечено вручную), кластеризация профессии по специальности (specialty).
Восстановление связей. Три задачи: person-region, person-industry, person-skill. Задача рассматривается в режиме Closed World Assumption, поэтому используются метрики классификации (AUROC).
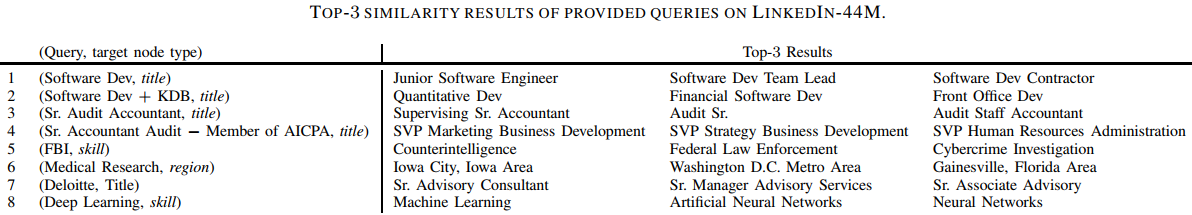
Помимо классических задач, проводится анализ векторов в пространстве. Например, можно добавить к вектору профессии вектор навыка и посмотреть на ближайшие векторы профессий. Таким образом, можно моделировать карьеру пользователя, обуславливаясь его текущими профессией и компанией, и предполагая, какую профессию он мог бы освоить, если бы изучил новый навык. Примеры из статьи показаны ниже.
Классификация проводилась как на маленьком, так и на большом датасетах, а остальные задачи проверялись только на большом. Очень странно, что на большом графе применяются только Skip-gram-подобные модели, тогда как на маленьком проверяются также Knowledge Graph Embeddings (TransE и подобные). Авторы говорят, что не удалось запустить TransE на большом графе, но с запуском node2vec у них никаких проблем не возникло. Это довольно странно, ведь, казалось бы, всё должно быть наоборот. Также, неясно, как авторы умудрились запустить методы для простых графов на графе знаний. Видимо, в LinkedIn’s Economic Graph между любыми двумя узлами может быть только одно ребро.
Достоинства и недостатки
На мой взгляд, этому методу присущи все недостатки Skip-gram моделей: затраты на генерацию случайных блужданий и отсутствие индуктивного режима (обобщение на новые данные).
Аналогично по достоинствам: главная особенность – это работа чисто на структуре графа, нет необходимости искать признаковое описание для узлов. С другой стороны, признаки могут быть преобразованы в узлы и учитываться при обучении векторных представлений.
На этом моё повествование подошло к концу. Ещё раз, просьба разобравшимся читателям освещать в комментариях непонятные моменты, буду рад устроить совместный мозговой штурм.