Мотивация
Недавно я писал научную статью с AIRI по графовым рекомендательным системам. Это был мой первый практический опыт работы с этой технологией, поэтому пришлось углубиться в исследования и изучение доступных материалов. Я решил, что пока я разбираюсь в этой теме, было бы полезно поделиться своими находками с вами.
Эта статья будет частью серии, состоящей из двух или трех частей. В первой части мы рассмотрим базовые понятия, концепции и простые модели, а также выделим их ключевые особенности. Вторую часть напишут мои знакомые из WildRecSys, где они расскажут о lightGCN и поделятся своим опытом использования этой модели. Все остальные части можно будет найти в моем телеграм канале, поэтому приглашаю подписаться что бы не пропустить, а вам приятного чтения.
Концепция
Граф — это как социальная сеть, где люди и их связи формируют целую систему. Представьте себе, что каждый пользователь — это точка, а линии между ними — это связи или взаимодействия.

Составляющие графа:
Вершины — их же называеют узлами это основные элементы графа, которые могут представлять объекты. Такими объектами могут быть как пользователи, товары, категории, города или точки на карте. Например, на схеме метро станции — это вершины, а в социальной сети это будет каждый человек, паблик, а на маркетплейсе может быть категория или определенный товар.
Рёбра — линии, соединяющие вершины, показывающие отношения или связи между вершинами. Как правило это признак дружбы, подписки, покупки, лайка или любого другого взаимодействия.

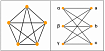
Рёбра могут быть направленными (например, если один человек подписан на другого) или ненаправленными (если связь взаимная, как дружба).
Примеры:
Человек-паук и его друзья: Помните мем где три человека-паука? Каждый из человеков пауков указывает на соседнего, но и соседний указывает на него. В таком случае такой граф назывался бы ненаправленным или неориентированный.

За орду или за альянс?
Гомофилия — это склонность людей с похожими характеристиками (например, возраст, пол, раса, социальный класс или религия) общаться и формировать социальные связи друг с другом.
Представьте себе, что вы в мире World of Warcraft. Все фанаты Орды скорее всего тусуются вместе, так же как и поклонники Альянса. Это явление не случайно — оно подкрепляется как личными предпочтениями, так и структурными факторами.
Гомофилия помогает формировать социальные сети, будь то дружеские или профессиональные связи. Она может быть явной, когда люди явно выбирают общение с похожими на себя, или скрытой, проявляясь в менее очевидных структурах. Например, сотрудники одного отдела на работе могут чаще общаться между собой не только из-за рабочих обязанностей, но и из-за схожих интересов или образа жизни.

Но что, если мы посмотрим на противоположное явление? Гетерофилия, или любовь к различному, — это тенденция людей собираться в разнообразные группы. Представьте, что на вечеринке World of Warcraft все фанаты смешиваются и знакомятся с новыми, непохожими на них игроками. Это противоположность гомофилии, и она тоже важна. Гетерофилия помогает создавать разнообразные и инновационные коллективы, особенно на работе. Разные точки зрения и подходы могут приводить к более креативным и эффективным решениям.
И на самом деле графы оперируют этими понятиями. По сути это и есть базовые функции графа мы либо смотрим на объекты рядом в одной группе, либо идешь дальше смотреть на соседнии.
Рекомендательные системы
Линейная алгебра
Графы имеют глубокие корни в линейной алгебре. Каждый граф можно представить с помощью матрицы смежности, где строки и столбцы соответствуют вершинам, а элементы матрицы указывают на наличие или отсутствие ребра между парами вершин.
Например мы можем представить граф в виде матрицы, где строки и столбцы представляют вершины графа, а значения в ячейках показывают, есть ли связь между двумя вершинами. Это помогает нам находить группы тесно связанных узлов (кластеров) и изучать структуру сети. Линейная алгебра играет важную роль в этих задачах, помогая анализировать и обрабатывать большие и сложные сети.

Матричная факторизация
Матричная факторизация — это еще один мощный метод, который тесно связан с графами. В рекомендательных системах матричная факторизация часто используется для разложения большой матрицы взаимодействий (например, пользователей и товаров) на две меньшие матрицы, которые легче анализировать.
Эти методы могут быть расширены до графов, где они помогают выявлять скрытые паттерны в данных. На самом деле, графы выступают в роли репрезентации, представления этой матрицы. А мы же этот граф можем перевести в различные матрицы — Лапласиан или кобордюра, которые уже будут в привычном нам виде.
Cross-Domain рекомендации

Графы — это не просто обычные сети с однотипными узлами и связями. Представьте себе, что ваш граф — это живая, дышащая экосистема, где каждый узел и каждое ребро имеют свою уникальную историю.
На самом деле, графы могут вместить в себя огромные объемы информации из различных сервисов и взаимодействий. Представьте себе данные из музыкальных сервисов, доставки еды, такси и других платформ, объединенные в одном графе. Каждый элемент этой сети может содержать уникальные свойства. Например, узлы могут представлять пользователей, товары или услуги, а ребра могут показывать клики, добавления в корзину, заказы и другие действия.
Но это еще не все. Эти узлы и ребра могут иметь множество характеристик, или, как их еще называют, фичей. Товары могут иметь цену, цвет, категорию и другие свойства. Пользователи могут иметь свои предпочтения, историю покупок и демографические данные. Каждое взаимодействие может нести информацию о времени, месте и типе действия.
Длинные хвосты
Одной из задач в рекомендательных системах является оптимизация рекомендаций для "длинного хвоста" (long tail) — редких и менее популярных товаров или контента.
Преимущество графов в том, что они позволяют находить скрытые связи между объектами и пользователями, которые не были явными в традиционных моделях. Это помогает рекомендовать менее популярные товары, которые могут быть интересны пользователям, но которые они не нашли бы самостоятельно.
Случайное блуждание
На самом деле самое растоя реализация это просто случайное блуждание по графу. По сути случайное блуждание это просто случайный выбор следующего шага из возможных.
Вы начинаете в одной точке (вершине) и случайным образом переходите к одной из соседних точек (вершин), повторяя этот процесс несколько раз. Результатом этого блуждания будет путь, который вы прошли, и он может быть использован для понимания структуры графа.

Цель этого процесса — сделать так, чтобы вершины, у которых схожие соседи, находились близко друг к другу в новом пространстве, которое мы создаем.
Поиск в ширину и глубину
И в рамках случайного блуждания у нас есть два параметра p и q, который по сути и задают насколько модель будет склонна к гомофилии и гетерофилии.
p — параметр возврата, который управляет вероятностью повторного посещения предыдущего узла.
q — параметр, который управляет вероятностью исследовать узлы дальше или ближе к предыдущему узлу.

Поиск в ширину (Breadth-First Search, BFS): Этот метод начинается с исходного узла и исследует всех его непосредственных соседей (на картинке это показано красными линиями). Затем алгоритм переходит к соседям этих узлов и так далее, пока не достигнет нужной глубины или не закончатся узлы. Поиск в ширину полезен для определения структурной эквивалентности узлов, то есть для понимания их места и роли в локальной сетевой структуре.
Поиск в глубину (Depth-First Search, DFS): Все так же начинается с исходного узла и идет как можно глубже по одному пути, прежде чем отступить и следовать другому пути (на картинке это синие линии). Это полезно для выявления общих паттернов связности, таких как принадлежность к определенному сообществу или кластеру внутри графа.
Рассмотрим конкретный кейс
Представим, что блуждание только что перешло от узла t к узлу v и теперь оценивает следующий шаг из узла v. Метки на рёбрах указывают на смещения поиска  . Это означает, что алгоритм использует эти метки для принятия решения о том, в какой узел перейти дальше, основываясь на предыдущем узле t и текущем узле v, чтобы сохранить структурную целостность блуждания, учитывая различные типы связей в графе.
 представляет собой кратчайшее расстояние между узлами t и x.
Параметр α в node2vec контролирует, как случайное блуждание по графу выбирает следующий узел. Он настраивается в зависимости от того, насколько далеко или близко следующий узел находится от текущего узла.
Конкретные формулы:
 , если предыдущий шаг был возвращением назад, что уменьшает вероятность повторного возвращения.
 , если следующий узел — непосредственный сосед текущего узла, что обеспечивает стандартное случайное блуждание.
 , если следующий узел находится дальше по графу, что увеличивает вероятность исследовать дальние узлы.
Например, если p высок, то блуждание склонно оставаться ближе к исходному узлу, а если q высок, то блуждание склонно достигать дальних узлов. Эти параметры помогают алгоритму обучать векторы узлов, которые отражают структуру и связи в графе.
Обучение
Лосс функция
Мы используем специальную формулу, чтобы определить, насколько хорошо наше представление отражают структуру графа. Давайте разберемся с этой формулой:

Интересные статьи
Интересные статьи