Если вы работаете с данными или просто любите графики и карты, то наверняка знаете то самое чувство. Увидели классную визуализацию, захотели сохранить, кинули в закладки или переслали себе в чат. А через пару недель она либо потерялась, либо вы уже не помните, зачем вообще её сохраняли.
У меня было ровно так же. Моя личная коллекция датавиза выглядела как хаос из закладок в браузере, сохранённых постов в LinkedIn и случайных ссылок в Notion Obsidian. Найти что-то конкретное спустя время было почти невозможно.
Поэтому в какой-то момент из всего этого хаоса появился DataDrops, мой небольшой пет-проект, который представляет собой галерею визуализаций данных. Это рассказ о его создании, а ещё о том, как я полтора года делал платформу, а потом за месяц почти полностью пересобрал её.
Как всё началось
Проблема с закладками была только половиной истории. Параллельно меня мучил другой вопрос. Я ведь и сам время от времени делаю графики и карты. Куда бы их выкладывать, чтобы ими можно было просто и удобно поделиться?
Я перебирал разные варианты, но... GitHub явно не для картинок: работу там найдёт только тот, кто уже знает, где искать; соцсети не дают никакой структуры: всё превращается в ленту, и через сутки пост уже никто не увидит; Behance и Dribbble больше про дизайн, чем про данные: там никого не интересует, откуда взяты цифры; а Pinterest хорош для вдохновения, но там у картинки нет контекста: ни источника данных, ни кода, ни нормального автора.
Так появилась мысль о галерее датавиза. Условный "Pinterest для аналитиков": место, где можно хранить свои работы, вдохновляться чужими и постепенно собирать портфолио.
Признаюсь, эта идея крутилась у меня в голове несколько месяцев и никак не отпускала. Но одно дело — придумать идею, и совсем другое — сесть и сделать полноценный сервис, учитывая, что я программист только отчасти (прежде всего, занимаюсь аналитикой данных, но порой приходится и в коде копаться).
От идеи к первому коммиту
В какой-то момент я наконец решил перестать прокручивать идею в голове и просто начать делать. В качестве основы выбрал Django как наиболее простой и понятный мне инструмент. Плюс заручился поддержкой ИИ-агентов. Хотя, честно говоря, в конце апреля 2025 года, когда в проекте появился первый коммит, они были совсем на другом уровне.
Почти все вечера и выходные у меня уходили на DataDrops: интерфейс, логика публикаций, пользовательские сценарии. Мне хотелось сделать не просто хранилище картинок, а инструмент именно под визуализацию данных. Поэтому с самого начала я заложил три основных принципа:
в центре внимания — сами визуализации, а не интерфейс вокруг них;
у каждой работы есть контекст: описание, источник данных, теги для поиска;
платформа работает и как галерея для вдохновения, и как место для своих работ, то есть портфолио.
Правда, одно дело заложить принципы, а другое — их соблюдать. Если бы можно было описать стиль моего программирования (да и любого созидания), то это было бы что-то в духе творческого перфекционизма-анархизма. Сначала делаю одно. Потом понимаю, что надо бы доделать ещё это, и то, и вот это. А потом и вовсе всё переделываю, потому что понимаю: изначально надо было делать по-другому.
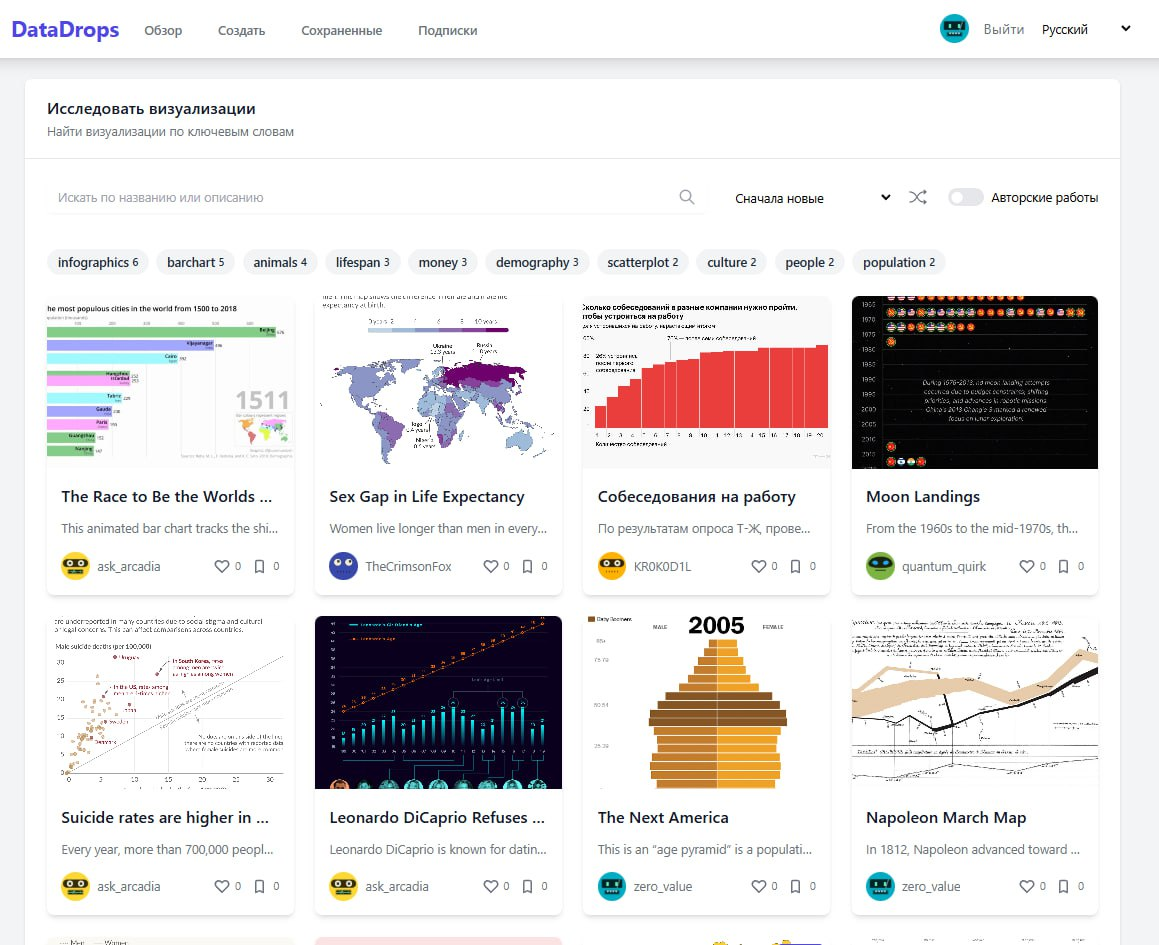
Тем не менее, 1 сентября 2025 года DataDrops открылся для всех. Технически это было классическое веб-приложение: авторизация, база данных, загрузка изображений, лайки, комментарии и подписки. Выглядело действительно как я задумывал!
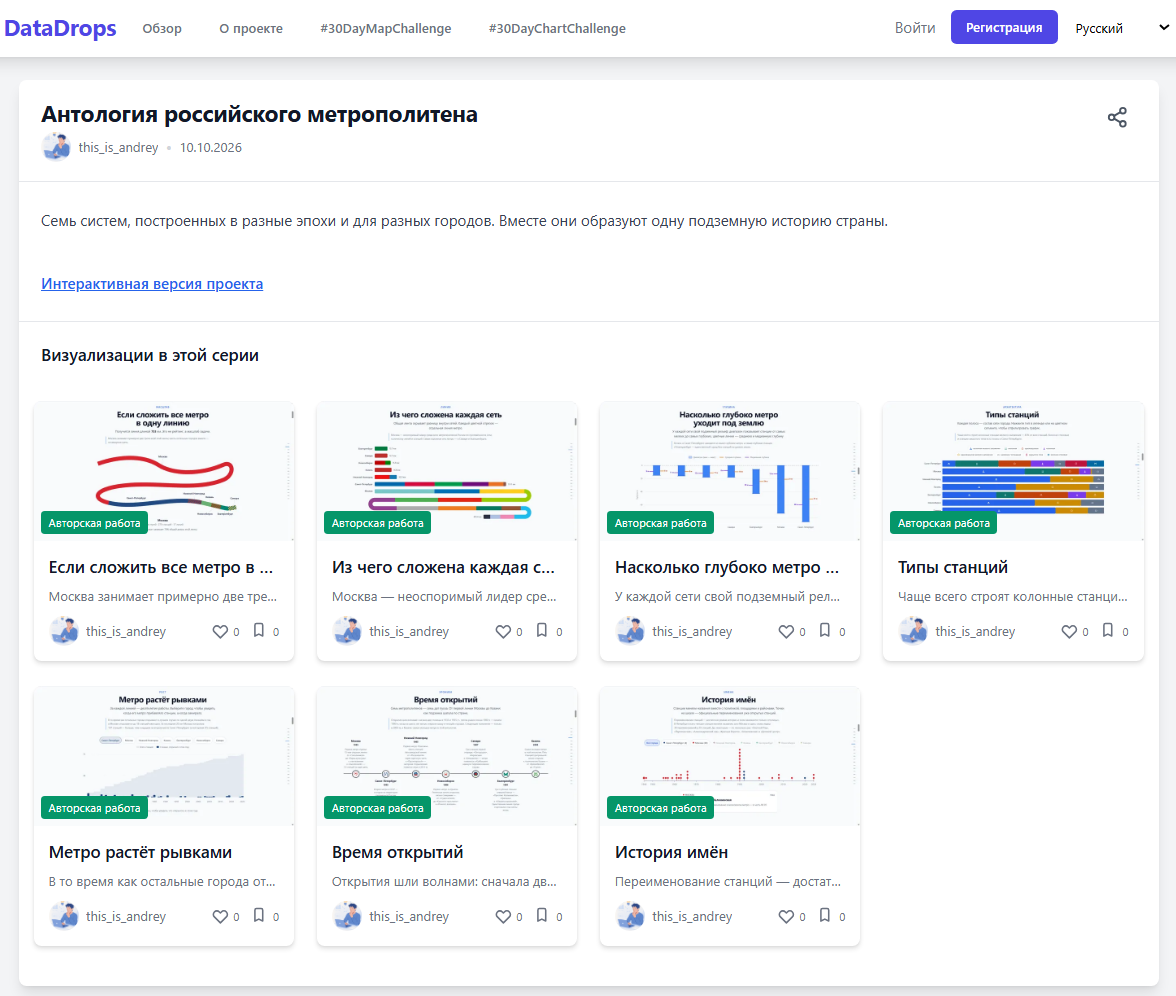
А потом наступил ноябрь, и я решил ещё добавить отдельную страницу для #30DayMapChallenge. В том челлендже я участвовал впервые и сделал все 30 карт, так что делал её в каком-то смысле для себя :)
Почему пришлось многое пересобрать
Потом наступила долгая пауза длиной почти в год. Отчасти из-за работы над другими проектами, отчасти из-за того, что я так и не научился продавать то, что делаю.
А когда этой осенью я вернулся к DataDrops и посмотрел на него свежим взглядом, стало понятно, что многое надо переделывать: лента выглядела довольно олдскульно: работы подписывались на разных языках, и половина ленты превращалась в красивые картинки с непонятными подписями (а ведь сайт-то мультиязычный!); а главное, галерею нужно было наполнять, и делать это только руками у меня не всегда получалось. В итоге за сентябрь и октябрь я пересобрал почти всё.
Для кого это всё
Я делал проект для аналитиков и дата-сайентистов, дизайнеров визуализаций, дата-журналистов, студентов и всех, кто участвует в #30DayMapChallenge или #TidyTuesday. В общем, для всех, кто делает графики и карты или просто любит на них смотреть. Проект полностью бесплатный и таким останется (до тех пор, пока у меня будут деньги его поддерживать).
Что вообще такое DataDrops
Если коротко, это галерея визуализаций данных:
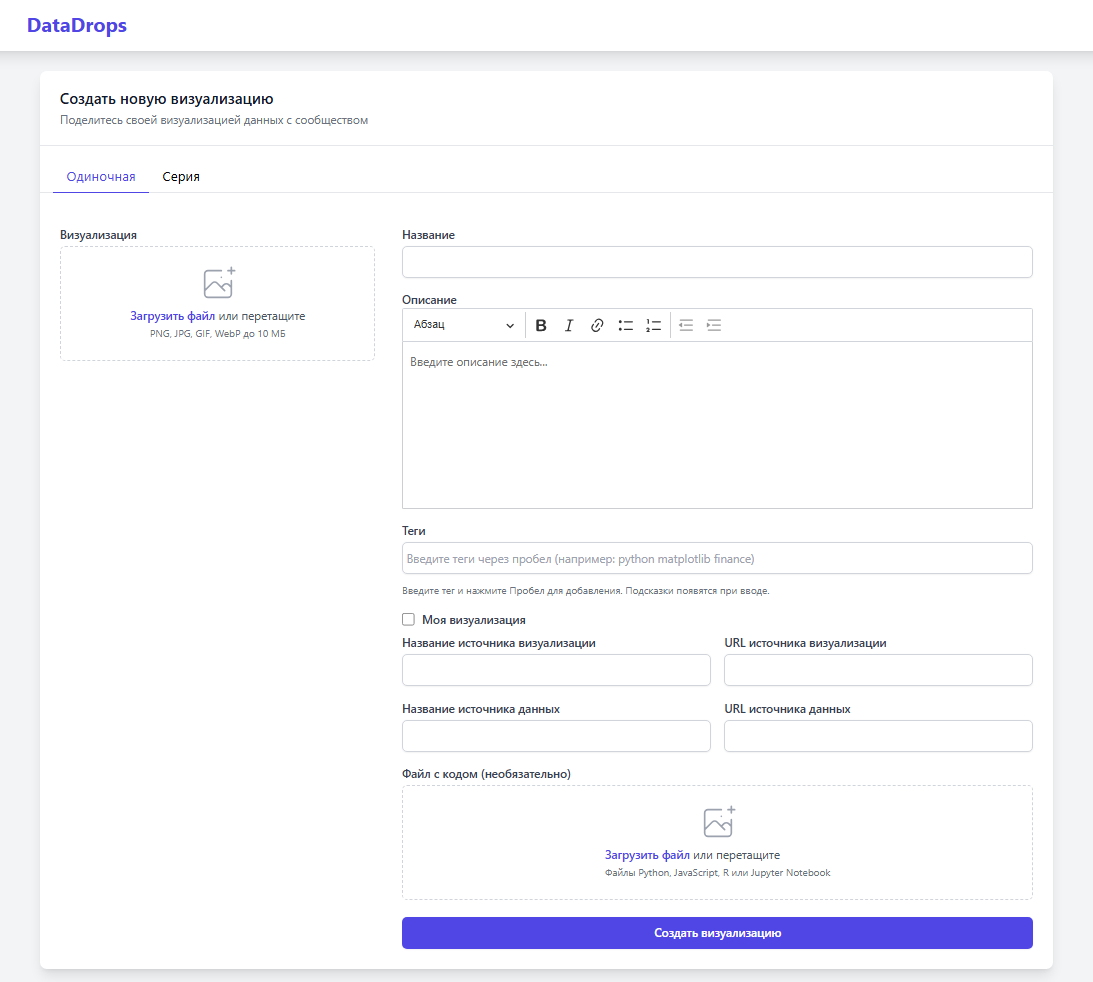
выложить можно картинку, а к ней по желанию ещё и файл с кодом (.py, .R, .js, .ipynb), а также добавить источник данных и описание;
можно выложить одну работу или целую серию;
можно и чужую, если указать автора и ссылку, а свои помечаются бейджем "Оригинал";
есть лайки, сохранения, комментарии и подписки на авторов, а профиль работает как портфолио;
есть отдельные страницы для #30DayMapChallenge и #30DayChartChallenge.
Стек довольно базовый, но это был осознанный выбор: Python, Django, PostgreSQL, Redis, JS и Tailwind. Картинки лежат в Backblaze B2 и раздаются через свой домен. Один сервер, gunicorn и nginx. Кажется, оптимальное сочетание для пет-проекта.
Проблема пустой галереи
У любой новой галереи одна и та же болезнь: в ней пусто. Никто не хочет выкладываться туда, где ничего нет, а без публикаций ничего и не появится. Классическая проблема курицы и яйца.
Сначала я, конечно, собирал хорошие работы руками. Вытаскивал работы из своих закладок и сохранёнок, загружал свои визуализации. Это работает, но съедает несколько часов в неделю. Поэтому этой осенью я сделал скаута — ИИ-агента, который ищет визуализации за меня, а мне остаётся роль редактора: определить, хочу ли я поделиться этой визуализацией.
Как он устроен. Это агент с инструментами, работает через OpenRouter. Инструменты простые: поиск в интернете, открыть страницу, посмотреть на картинку (модель мультимодальная), уточнить детали, предложить кандидата и отметить ссылку как неудачную. Поиск отдан модели подешевле (GPT 6 Luna), а основная думает и разглядывает графики (Claude Haiku 4.5).
Где ищет. Reddit r/dataisbeautiful (через RSS и только авторские посты с тегом [OC]), Our World in Data, Bluesky по тегам #30DayMapChallenge, #30DayChartChallenge и #TidyTuesday, Visual Capitalist, Eurostat, Всемирный банк, избранные карты Wikimedia Commons, FlowingData, Datawrapper, The Pudding, Information is Beautiful, Nightingale, Observable и Tableau Public. Из русскоязычных — "Если быть точным".
Правила. Они написаны обычным текстом в markdown-файле, как инструкция для нового сотрудника, а не зашиты в код. Работа должна что-то сообщать, а не просто быть красивой. У неё должны быть известны автор и источник данных, а лицензия — позволять показ. Поэтому издания с жёсткой политикой перепечатки (NYT, FT, Economist, Reuters, Bloomberg) скаут пропускает. Сгенерированные ИИ картинки, рекламу и мемы отклоняет. Да, ИИ-агент, которому запрещено приносить картинки, сгенерированные ИИ, — это немного иронично
Интересные статьи
Интересные статьи