DVT — open-source платформа визуального ETL: пайплайн собирается из нод (чтение → преобразования → запись) и выполняется на воркерах поверх Dask. Я разрабатываю бэкенд DVT, в статье — устройство одного из его компонентов.
Нода чтения из БД должна одинаково работать на таблице в 10 тыс. и в 100 млн строк, на шести СУБД (PostgreSQL, MySQL/MariaDB, MS SQL, Oracle, SQLite, ClickHouse), в воркере с ограниченной памятью и без избыточной нагрузки на источник.
Ниже — устройство планировщика чтения core/db/read_v3: оценка размера строки, расчёт числа партиций, построение границ range и hash, стоимость разметки для источника и интеграция с Dask.
Почему не SELECT *, chunksize или OFFSET
Самый очевидный вариант — pd.read_sql("SELECT * FROM orders", engine). На 10 млн строк по 400 байт это около 4 ГБ сырых данных, а в pandas с object-колонками легко выходит в полтора-два раза больше. Воркер завершается по OOM.
Дальше обычно вспоминают про chunksize или серверный курсор. Память это спасает, но остаётся проблема: чтение идёт одним соединением, последовательно, кусок за куском. Распараллелить его нельзя — следующий кусок не существует, пока не прочитан предыдущий. Для ETL, где основное время уходит на ожидание сети и базы, это медленно.
Пагинация через LIMIT ... OFFSET даёт независимые куски, но каждый следующий запрос дороже предыдущего: базе нужно пройти и выбросить все строки до OFFSET. Keyset-пагинация (WHERE id > :last_id) быстрая, но снова последовательная: границу следующего куска знаешь только после чтения текущего.
Требования к чтению:
Каждый кусок — независимый запрос с
WHERE-условием, который можно выполнить в любом порядке и параллельно.Кусок помещается в память с запасом, а их число не взрывает планировщик.
Границы кусков известны заранее, до чтения данных. Это нужно Dask: если он знает
divisions(диапазоны индекса по партициям), он может эффективно делать join, сортировку и выборку по индексу.Одно и то же чтение одной и той же таблицы даёт одни и те же куски — это упрощает отладку и кэширование.
Всё это работает на шести СУБД с разными диалектами.
Ответ на это — партиционирование: таблица делится на сегменты, каждый описывается SQL-предикатом. Осталось решить два вопроса: сколько сегментов и где проводить границы.
Расчёт размера партиции
Если пользователь не задал число партиций руками, планировщик считает его сам. Для этого нужно знать две вещи: сколько строк в таблице и сколько весит одна строка.
Сколько весит строка
Считать SELECT * ради оценки нельзя, поэтому мы идём по каскаду от дешёвого к дорогому и останавливаемся на первом источнике, который дал ответ:
Статистика СУБД по колонкам. В PostgreSQL это
avg_widthизpg_stats, в ClickHouse —system.parts_columns, в Oracle —AVG_COL_LEN. Запрос к системному каталогу почти бесплатный, и он сразу учитывает только выбранные колонки.Размер таблицы целиком, поделённый на число строк и пропорционально урезанный под выбранные колонки.
Выборка из 1000 строк и
df.memory_usage(deep=True). Это уже честный размер в pandas, а не на диске.Эвристика по типам, если всё остальное упало:
int— 8 байт,uuid— 16,json— 128,varchar(n)— n/4, но не больше 256.
К результату добавляется запас: коэффициент 1,2 и 24 байта накладных расходов на строку. Оценка сознательно пессимистичная — лучше лишняя партиция, чем OOM.
Число строк тоже берём там, где дешевле. В PostgreSQL это reltuples из pg_class, то есть оценка планировщика, а не COUNT(*). На таблице в сотни миллионов строк разница между мгновенным ответом и полным сканированием ощутима. Для MS SQL и Oracle сейчас честный COUNT(*) — тут есть что улучшать.
Сколько строк в куске
Расчёт (упрощённо):
target_bytes = TARGET_PARTITION_MEM_MB * 1024**2 * OVERHEAD_COEF  # 16 МБ × 1.8 ≈ 29 МБ

rows_by_mem = target_bytes // bytes_per_row
rows_ceiling = max(MIN_ROWS_PER_PART, 2 * DIALECT_BATCH_ROWS[dialect])  # PG: 80 000
rows_per_part = max(MIN_ROWS_PER_PART, min(rows_ceiling, rows_by_mem))  # не меньше 10 000

nparts_by_rows = ceil(total_rows / rows_per_part)
nparts_by_bytes = ceil(total_rows * bytes_per_row / target_bytes)
npartitions = min(max(nparts_by_rows, nparts_by_bytes), MAX_PARTITIONS)  # не больше 5000
Откуда эти числа:
16 МБ × 1,8. Целевой размер куска в памяти. Коэффициент 1,8 — поправка на то, что после чтения pandas создаёт копии при преобразованиях. Оба значения вынесены в переменные окружения.
Нижняя граница 10 000 строк. Мелкие куски увеличивают накладные расходы: на каждый — отдельный запрос, отдельная задача Dask, отдельные накладные расходы.
Верхняя граница по диалекту. Для PostgreSQL это 80 000 строк, для MySQL 100 000, для ClickHouse 2 млн. Это эмпирика под каждую СУБД: колоночный ClickHouse спокойно отдаёт миллионы строк за запрос, строчным базам лучше давать куски поменьше.
Не больше 5000 партиций. Граф Dask на десятки тысяч задач сам по себе становится проблемой для планировщика.
Пример. Таблица заказов в PostgreSQL, 10 млн строк, оценка — 400 байт на строку. По памяти в кусок влезает около 75 000 строк, это ниже потолка в 80 000. Получается примерно 130 партиций по ~75 000 строк.
Построение границ
Число кусков есть, теперь нужно превратить его в набор WHERE-условий. Для этого нужна колонка разбиения. В режиме чтения таблицы это колонка, указанная пользователем, а если её нет — первичный ключ, но только если он состоит из одной колонки. В режиме произвольного SQL-запроса колонку нужно указать обязательно: ключ из произвольного запроса не выводится.
Дальше есть две стратегии, и выбирается одна из них автоматически.
Range: равные по числу строк диапазоны
Если в колонке нет NULL и её можно упорядочить (число, дата, строка), строим диапазоны. Наивный вариант — поделить отрезок [min, max] на N равных частей. На реальных данных он не работает: id с дырами после удалений, даты, где за последний месяц строк больше, чем за предыдущие пять лет. Куски получаются разного размера, а нам нужна предсказуемая память.
Поэтому мы режем по количеству строк, а не по значениям. Сначала один запрос собирает статистику:
SELECT MIN(id) AS min_v, MAX(id) AS max_v,
       COUNT(*) AS total_rows, COUNT(id) AS non_null_rows
FROM orders
Потом для каждой будущей границы находим значение ключа на нужной позиции. Если строк 10 млн, а кусков 130, нужна каждая ~77 000-я строка:
SELECT id AS boundary_value
FROM orders
WHERE id IS NOT NULL
ORDER BY id ASC
LIMIT 1 OFFSET 76924  -- 0, 76924, 153848, ...
По сути это квантили, посчитанные «в лоб». Из найденных значений собираются сегменты:
-- сегмент 0
WHERE id >= 1 AND id < 76925
-- ...
-- последний сегмент: правая граница включительно
WHERE id >= 9923197 AND id <= 10000000
Границы, совпавшие после дедупликации, схлопываются. Если у колонки мало разных значений, например статус заказа, все строки с одинаковым значением попадут в один сегмент, и он может оказаться огромным. Range не умеет разрезать одно значение пополам.
Hash: когда порядка нет или есть NULL
Если в колонке встречаются NULL или её нельзя упорядочить, используется разбиение по хэшу. Для PostgreSQL выражение выглядит так:
WHERE mod(abs(hashtext(coalesce((customer_id)::text, '__NULL__'))), 130) = 17
Каждая партиция — это «строки, у которых хэш ключа даёт остаток N». Никаких предварительных запросов за границами не нужно, а NULL-значения через coalesce уходят в свою корзину и не теряются.
Каждый сегмент — это полный проход по таблице с вычислением хэша, индекс по ключу тут не поможет. И, как и в range, одинаковые значения ключа всегда попадают в одну корзину, так что перекос по ключу никуда не девается.
Страховка от перекоса
Оба способа в худшем случае дают один гигантский сегмент. Чтобы это не превратилось в тихий OOM, у ноды есть параметр max_rows_per_partition. Каждый сегмент читается с LIMIT max_rows + 1, и если пришла лишняя строка, чтение падает с понятной ошибкой:
capped_sql = dialect.cap_rows_sql(sql, max_rows + 1)
df = read_sql(capped_sql)
if len(df) > max_rows:
    raise ReadV3ExecutionError(
        f"Segment exceeded max_rows_per_partition={max_rows}; rows_read={len(df)}"
    )
Это не автоматическое доразбиение, а именно предохранитель: чтение падает раньше, чем сегмент исчерпает память воркера, и ошибка указывает на неудачный ключ. Если стандартные стратегии не подходят, разбиение можно задать вручную: по периодам дат, по префиксу строки или явным списком значений.
Стоимость разметки для источника
Разметка выполняется до чтения данных, и её стоимость ложится на источник. Запросы планировщика до чтения первой строки при range-разбиении на 130 кусков:
Что делаем | Запросов | Насколько дорого |
|---|---|---|
Структура таблицы, типы, ключ | несколько | дёшево, системный каталог |
Оценка размера строки и числа строк | 1–3 | дёшево, если есть статистика; выборка 1000 строк, если нет |
| 1 | полный проход, если нет индекса |
Поиск границ через | 130 | зависит от индекса — см. ниже |
Последняя строка — главная. С индексом по ключу база не сортирует таблицу, а идёт по индексу, но всё равно проходит k записей, чтобы выкинуть их и вернуть одну. Смещения растут: 0, 77 тыс., 154 тыс. и так далее. В сумме это порядка page_size × N² / 2 прочитанных записей индекса — для нашего примера несколько сотен миллионов. Без индекса каждый из 130 запросов превращается в сортировку всей таблицы.
Это известное ограничение текущей реализации. Её преимущество — один и тот же SQL для всех шести диалектов. Варианты лучше есть, но они специфичны для СУБД: percentile_disc или ntile одним запросом в PostgreSQL, quantiles в ClickHouse, проход по ключу с шагом через keyset. Это кандидат на следующую итерацию.
Read Query: ваш SQL выполнится много раз
Пользовательский SQL оборачивается как подзапрос, и каждый служебный запрос выполняет его заново: выборка для оценки размера, статистика, каждая граница. Потом он же выполняется ещё раз на каждый сегмент с дополнительным WHERE. Если ваш запрос — тяжёлый join на минуту, планирование растянется надолго, а источник получит соответствующую нагрузку.
Что из этого следует на практике
Колонка разбиения должна быть проиндексирована. Это влияет и на разметку, и на чтение каждого сегмента. Лучше всего подходит числовой первичный ключ: уникальный, без NULL, с индексом.
Hash — не бесплатная альтернатива. Разметка дешёвая, но каждый сегмент сканирует таблицу целиком.
Для Read Query сначала оптимизируйте сам запрос или материализуйте его результат в таблицу.
Для маленьких таблиц ставьте одну партицию руками. На 5 000 строк накладные расходы разметки не окупаются.
Как куски превращаются в конвейер
План готов: список сегментов, у каждого свой WHERE и известные границы. Нода чтения превращает его в Dask DataFrame, но сами данные при этом не читает:
delayed_parts = [
    delayed(executor.load_partition)(plan, segment)
    for segment in plan.segments
]
return dd.from_delayed(delayed_parts, meta=meta, divisions=divisions)
Каждая партиция — отложенный вызов «выполни SQL этого сегмента». Ноды фильтрации и преобразования дописывают свои шаги в тот же граф. Данные начинают двигаться, только когда очередь доходит до ноды записи.
Нода записи запускает несколько потоков. Каждый берёт очередной сегмент и проводит его через весь путь: прочитать из источника, преобразовать, записать в приёмник. Освободившийся поток сразу берёт следующий сегмент. Пока одни куски ещё читаются, другие уже пишутся, и в памяти никогда не лежит вся таблица.
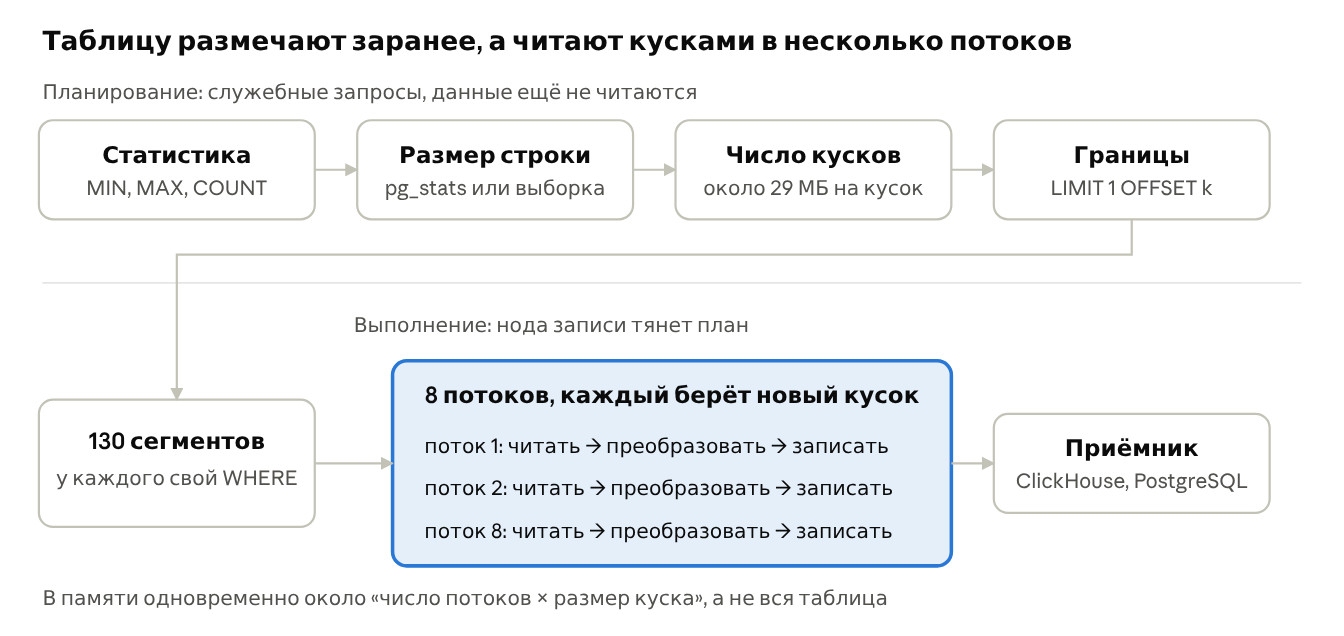
Отсюда простая оценка памяти задачи: примерно число потоков × размер куска, плюс копии, которые создают преобразования. Размер таблицы в этой формуле не участвует.
Несколько чисел из настроек:
потоков по умолчанию 8, максимум 32, задаётся в настройках проекта;
у каждой SQL-ноды пул не больше 15 соединений, поэтому больше 15 потоков для SQL-баз почти ничего не дают — лишние ждут свободное соединение, а через 30 секунд ожидания нода падает;
для ClickHouse число соединений при записи равно числу потоков.
На нашем примере: 130 кусков, 8 потоков. Если кусок читается, обрабатывается и пишется за 2 секунды, вся таблица уйдёт примерно за 130 × 2 / 8 ≈ 33 секунды. В один поток — за 4–5 минут. Цифры условные, они показывают порядок, а не результат замера.
При этом 8 потоков — это 8 одновременных запросов к источнику. Если источник — рабочая база, число потоков стоит согласовать с её администраторами.
Типичные проблемы
Ключ с малым числом значений. Разбиение по статусу или по дате без времени даёт пару гигантских сегментов и кучу пустых. Range не режет одно значение пополам, hash тоже. Лечится выбором другого ключа или ручной группировкой.
Нет индекса на ключе. Разметка превращается в серию полных сортировок, и нода чтения «висит» ещё до начала выгрузки.
Тяжёлый Read Query. Запрос выполняется на каждую границу и каждый сегмент. Если он медленный сам по себе, партиционирование это только умножит.
Сортировка, установка индекса и pivot читают источник дважды. Им нужно заранее знать распределение значений, поэтому на своём шаге они делают полный предварительный проход по данным, а потом источник читается ещё раз при записи.
Ошибки в данных всплывают на ноде записи. Ноды чтения и фильтрации только строят план, поэтому сравнение строки с числом упадёт там, где данные реально пошли.
Итого
Выводы:
Память задачи должна зависеть от числа потоков и размера куска, а не от размера таблицы.
Резать стоит по количеству строк, а не по диапазону значений: реальные данные почти никогда не распределены равномерно.
У разметки есть своя цена, и платит её источник. Индекс на колонке разбиения — не рекомендация, а обязательное условие.
Код, о котором шла речь, лежит в открытом репозитории DVT: github.com/Denvic-Tech/dvt, каталог core/db/read_v3.
Открытый вопрос — построение границ без OFFSET с одинаковым поведением на всех диалектах. Если решали похожую задачу, интересно сравнить подходы в комментариях.