Применение искусственного интеллекта в окружающей нас действительности стремительно растет — международная консалтинговая компания McKinsey подсчитала, что среднее количество возможностей ИИ, используемых в организациях, удвоилась за последние четыре года. Занимаясь автоматизацией бизнес-процессов, мы также начали исследования в этой области для упрощения и ускорения решения корпоративных задач. Мы уже писали ранее о первом опыте работы над автоматической генерацией протоколов совещаний. А в данной статье расскажем, как применили нейросетевые технологии для абстрактивной суммаризации, требующей минимальной доработки человеком.
Предыстория
Нашим первым решением с применением ИИ, реализованным у клиентов, стал модуль системы электронного документооборота (СЭД) для автоматизации работы с обращениями. Использование технологий машинного обучения позволило сократить рутинные процедуры. В частности, модуль осуществляет маршрутизацию обращений, и этот функционал уже внедрен и активно используется заказчиками государственного сектора.
Видя большой потенциал в разработках систем автоматизации с применением ИИ, мы поставили перед собой цель преобразовать процесс составления протокола совещаний, превратив его из тяжелого бремени для ответственного сотрудника в лёгкую и быструю процедуру.
Решать задачу было намечено несколькими способами:
Экстрактивное резюмирование — нейросетевая модель обучается выделять ключевые высказывания в стенограмме и переносить их в протокол;
Гибридный подход — используется экстрактивное резюмирование, а прямая речь заменяется на косвенную;
Абстрактивное резюмирование — с нуля генерируется протокол встречи от третьего лица.
Также мы решили добавить реакции системы на голосовые команды, которые бы она выделяла из стенограммы совещания.
Первый шаг: экстрактивный подход
Мы разработали систему автопротоколирования SumMeet со следующим принципом работы:
Запись встречи в ВКС или при помощи оборудования.
Распознавание речи в аудиозаписи и формирование транскрипта (предпочтительна многоканальная запись с разделением по спикерам).
Составление на основе стенограммы совещания резюме по экстрактивному принципу. Т. е. присвоение озвученной на встрече информации приоритетов для автоматической генерации протокола с точными формулировками.
Для составления системой резюме мы создали собственную нейросетевую модель с использованием открытой архитектуры, собрали набор данных (датасет) и научили нейросеть решать нашу задачу по классификации текста стенограммы и составлению протокола.
Читайте в предыдущей статье, как мы проводили сбор корпуса данных для экстрактивной модели, анализ и тестирование нейросетей, взятых за основу.
Обученная нами нейросеть начала формировать протокол с точными формулировками, озвученными на совещании, как в примере ниже:

Мы понимали, что это первый шаг, и планировали совершенствовать решение. Как повысить качество и связность резюме встречи? Научить нейросеть не только выделять из озвученного на совещании ключевые слова и информационные блоки, но и генерировать новый текст, суммирующий идеи участников? На выходе мы хотели получить протокол, не уступающий тексту, написанному человеком. Для достижения цели наша команда приступила к использованию гибридной суммаризации и обучению нейросети создавать резюме по абстрактивному принципу.
«Разумный» автоматический протокол: гибридный и абстрактивный подходы
Преимуществом абстрактивного подхода при создании резюме с помощью ИИ является высокое качество текста. Оно максимально близко тому, что мог бы создать человек. Но реализовать этот принцип сложнее, требуются значительные трудозатраты и дополнительные исследования для обучения нейросети.
Мы приступили к обновлению системы SumMeet 2.0 и начали сбор данных для обучения модели пересказывать содержание текста. Как и в прошлый раз, использовались разные подходы. Мы собирали примеры резюме: составляли протоколы совещаний, проходящих в компании, и предоставляли их нейронной сети. Датасет для русскоязычного автореферирования включил 29 совещаний, содержащих больше одного примера протокола, и 47 совещаний, каждому из которых сопоставлен только один вручную написанный протокол. Мы просили аннотаторов писать резюме в хронологическом порядке, основываясь на стенограмме и с минимальным перефразированием.
Параллельно мы брали информацию из иностранных баз данных. Например, мы автоматическим образом перевели на русский язык англоязычный корпус, содержащий более 16 000 примеров бесед в стиле сообщений в мессенджерах, а также их резюме в форме пересказа. В итоге собранный нами набор данных позволяет использовать как гибридный (экстрактивная суммаризация с переписыванием фраз от третьего лица), так и абстрактивный подход при составлении протоколов совещаний.
За основу мы брали модель от sberbank-ai и обучали ее нашим данным. Использовали библиотеки HuggingFace Transformers, DeepPavlov и PyTorch.
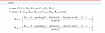
Для проверки результата мы применили основную метрику оценки качества автоматического реферирования ROUGE, которая вычисляет количество совпадающих n-грамм между предсказанным текстом и истинными.

Здесь:
 — набор истинных последовательностей,
 — количество n-грамм, встречающихся и в предсказанном, и в истинном тексте,
 — количество n‑грамм, встречающихся только в истинном тексте.
А также метрику ROUGE-L, основанную на самой длинной общей подпоследовательности между предсказанным и истинным текстом.


Здесь:
 — предложение из истинного текста,
 — предложение из предсказанного текста,
 — длина наибольшей общей подпоследовательности между X и Y,
 — длина X,
 — длина Y.
Гибридный подход показал следующее качество реферирования: лучший из предложенных экстрактивных методов достигает значения метрик ROUGE-1 = 0.406, ROUGE-2 = 0.237, ROUGE-L = 0.383, лучший из предложенных гибридных методов достигает значения автоматических метрик ROUGE-1 = 0.296, ROUGE-2 = 0.12, ROUGE-L = 0.287.
Абстрактивный метод дал следующие результаты: ROUGE-1 = 0.273, ROUGE-2 = 0.109, ROUGE-L = 0.263.
Для оценки абстрактивного автопротоколирования мы также использовали метрики, полученные в ходе опросов респондентов. В подобных случаях, как правило, применяется психометрическая шкала Ликерта со значениями от 1 до 5 (где 1 — худшее значение, а 5 — лучшее). Мы опрашивали респондентов по следующим основным параметрам:
adequacy — включение в автореферат основных моментов, обсуждённых на встрече и зафиксированных в стенограмме;
fluency — лёгкость чтения и связанность предложений;
grammaticality — грамматическая правильность.
Пример разработанного нами web-приложения для оценки респондентами автоматически сгенерированных протоколов:

Мы получили следующие субъективные метрики, которые были подтверждены в ходе апробации SumMeet 2.0 в компаниях, представляющих целевую аудиторию решения:
grammaticality: 4.3125,
fluency: 3.875,
adequacy: 3.9375.
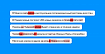
Ниже приведен результат обучения и пример сформированного нейросетевой моделью протокола по абстрактивной модели:

Таким образом, у нас получилось прийти к поставленной цели и добиться автоматического формирования системой содержательного и связного протокола встречи. Ответственному за подведение итогов обсуждения пользователю уже не требуется существенно переписывать извлеченные из стенограммы реплики. Его трудозатраты в основном сводятся к финальной вычитке.
В отдельных случаях, когда нейросетевая модель сталкивается с трудностями передачи смыслов при абстрактивном резюмировании (приводим ниже пару забавных примеров), удобно свериться со стенограммой совещания и внести нужные точечные правки:

Голосовой помощник: поиск ключевых слов и команд в тексте стенограммы
Для расширения возможностей системы мы дополнили SumMeet 2.0 функцией голосового помощника, которая анализирует текст стенограммы — участник совещания может напрямую обратиться к системе и дать голосом команду внести в протокол задачу, указать ответственного, добавить важную информацию. Решения передаются в резюме встречи дословно, когда это необходимо, задача вносится в протокол, даже если она ранее не была напрямую озвучена на совещании, а только подразумевалась.
При работе с голосовым помощником мы также применили нейросетевой подход: использовали библиотеки HuggingFace Transformers, DeepPavlov и PyTorch и интегрировали в SumMeet 2.0 модель Rubert-base-cased-conversational (DeepPavlov), показавшую лучший результат.
Мы собрали аудиозаписи собраний у партнеров, получили стенограммы посредством систем автоматического распознавания речи (ASR), подавляющее число которых распознано Microsoft Azure Cognitive Services, потому что она показала хорошее качество распознавания по сравнению с другими системами, а также предоставляет функциональность дообучения под узкоспециализированную речь, что очень важно для задачи извлечения именованных сущностей. Участников собраний мы просили произносить команды вида «Саммит, запиши…» и «Саммит, поставь задачу…на персону… на дату…», опционально добавляя в конце длинных фраз «… спасибо, Саммит».
После этого мы приступили к аннотированию совещаний. В систему разметки (Label Studio) переносились высказывания, содержащие команды. Аннотаторам следовало разметить голосовые команды (начало, содержание, окончание). Внутри содержания каждой из команд также размечались сущности персон и дат.
Примеры высказываний и размечаемые классы меток:

Tasks — «Саммит, поставь задачу», Summeet Assistant — «Саммит, запиши». Размечается только тело команды, без фраз «Саммит, поставь задачу», «внести в протокол», «спасибо, Саммит».
WCOMMAND и TCOMMAND — начальные фразы команд: «Саммит, запиши» и «Саммит, поставь задачу» в той форме, как они были произнесены на встрече.
ECOMMAND – опциональная фраза окончания команды «спасибо, Саммит».
Ошибки ASR в именах не правились, размечались как BNAME.
Местоимения, по которым можно понять на кого поставлена задача (“я”, “на себя”, “себе”, “мне”), относили в класс PRONOUN.
Date — одна дата, INTERVAL — период времени.
Отличным решением для наращивания объема и разнообразия корпуса данных команд для обучения нейросети стало не только их проговаривание голосом, но и их экспорт из системы отслеживания проектов и задач компании. К настоящему моменту мы подготовили набор данных, насчитывающий около 300 примеров сгенерированных команд.
Пример внесения системой в протокол задач и заметок на основании анализа голосовых команд:

Преимущества автоматического протоколирования
Для обеспечения максимальной гибкости работы SumMeet 2.0 позволяет использовать все три функции о которых шла речь: экстрактивное и абстрактивное резюме и реакции на команды.
При этом система применима в любых обстоятельствах: на официальном совещании, во время планерки в офисе или неформальной встречи, когда появилась необходимость зафиксировать достигнутые договоренности. SumMeet 2.0 позволяет облегчить работу секретарей, проектных менеджеров и руководителей. Подходит для проведения очных и онлайн-встреч, а также совещаний в гибридном формате.
Решение предоставляет инструменты автоматического создания стенограммы, краткого итогового протокола, отправки поручений в системы отслеживания задач (JIRA, СЭД, корпоративная почта).
Преимуществом SumMeet 2.0 является возможность дополнительного обучения лексике, принятой в отрасли или организации, где предполагается ее использование. Также могут быть учтены речевые особенности конкретных спикеров, что позволит еще лучше передавать смыслы в автоматически генерируемом тексте.