Всё началось с простого вопроса: почему малый бизнес теряет клиентов ночью?
Клиент заходит на сайт в 23:00, пишет в чат — и уходит. Потому что менеджер спит. Утром менеджер видит сообщение, перезванивает — а клиент уже купил у конкурента.
Стандартное решение — чат-бот. Но обычный чат-бот либо ограничен заранее заданными сценариями, либо требует интеграции с крупными облачными LLM. (отвечает по скриптам), либо слишком дорогой (GPT-4 за десятки тысяч в месяц), либо хранит данные за рубежом, что не всегда удобно для российского бизнеса.
Я решил сделать иначе.
Проблема переключения между ИИ и оператором
Главная сложность оказалась не в интеграции с моделью, а в сохранении непрерывности диалога. После передачи клиента оператору необходимо было сохранить единый контекст разговора, не меняя интерфейс для пользователя. Для этого relay-сервер хранит состояние сессии и динамически маршрутизирует сообщения либо в vLLM, либо в MAX, в зависимости от текущего режима обработки.
Что в итоге получилось
ИИ-консультант на базе Qwen3 30B отвечает клиентам на сайте. Когда клиент хочет поговорить с живым человеком — оператор получает уведомление в MAX с кратким резюме всего диалога. Отвечает прямо из мессенджера. Клиент видит один непрерывный разговор и не знает что канал переключился.
Вся установка — один тег перед </body>:
<script src="https://llmcod.ru/widget/ВАШ_ID.js"></script>
Как это работает технически
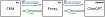
Архитектура состоит из трёх частей:
1. Виджет на сайте — обычный JS чат, подключается через WebSocket к relay-серверу. Никаких iframe, никаких внешних зависимостей.
2. Relay-сервер (FastAPI + WebSocket) — центральный компонент. Держит сессию пользователя, проксирует сообщения в vLLM или в MAX в зависимости от режима. Хранит историю диалога и маппинг session_id ↔ MAX chat_id.
Ещё одна проблема возникла при переключении между режимами. Если оператор подключается слишком рано, ИИ не успевает собрать достаточный контекст. Если слишком поздно — клиент может уйти. Поэтому порог эскалации сделан настраиваемым и определяется количеством сообщений в диалоге.
3. MAX бот — получает уведомления об эскалации. Оператор видит резюме диалога и отвечает прямо в мессенджере.
Схема передачи сообщений:
Клиент → WebSocket → Relay → vLLM (AI режим)
                           ↓ (при эскалации)
                     MAX webhook ← MAX бот ← Оператор
При эскалации relay вызывает vLLM для суммаризации истории диалога и отправляет оператору готовое резюме. Оператор не читает весь чат — видит только суть.
Почему MAX, а не Telegram
Несколько причин:
MAX — российский мессенджер, данные хранятся в РФ
API MAX позволяет получать webhook и отвечать от имени бота
MAX предоставляет API для ботов и webhook-механизм, достаточный для реализации сценария передачи диалога оператору.
Ключевой момент — резюме диалога
Это главное отличие от обычного "перевода на оператора". Когда клиент нажимает кнопку — оператор получает не просто уведомление, а готовый контекст:
Интересные статьи
Интересные статьи