У подписки на Claude Code два лимита: пятичасовая сессия и недельное окно. Codex и Kimi Code считают похоже, но окна у них свои: у Kimi бывает месячное, а недельного у новых планов нет. Посмотреть остаток можно командой /usage, но только внутри открытой сессии и только для того аккаунта, под которым она запущена.
А меня обычно интересует другое: хватит ли до сброса. 60% к среде — это много или нормально? Если я и дальше буду работать в том же темпе, упрусь ли я в лимит в пятницу вечером?
Для этого я сделал claude-limits: маленький локальный сервер, который раз в несколько минут спрашивает лимиты всех найденных логинов и показывает их на одной странице. Главное в ней — прогнозы. Статья о них и о том, как утилита написана на Nova, языке, который я делаю.
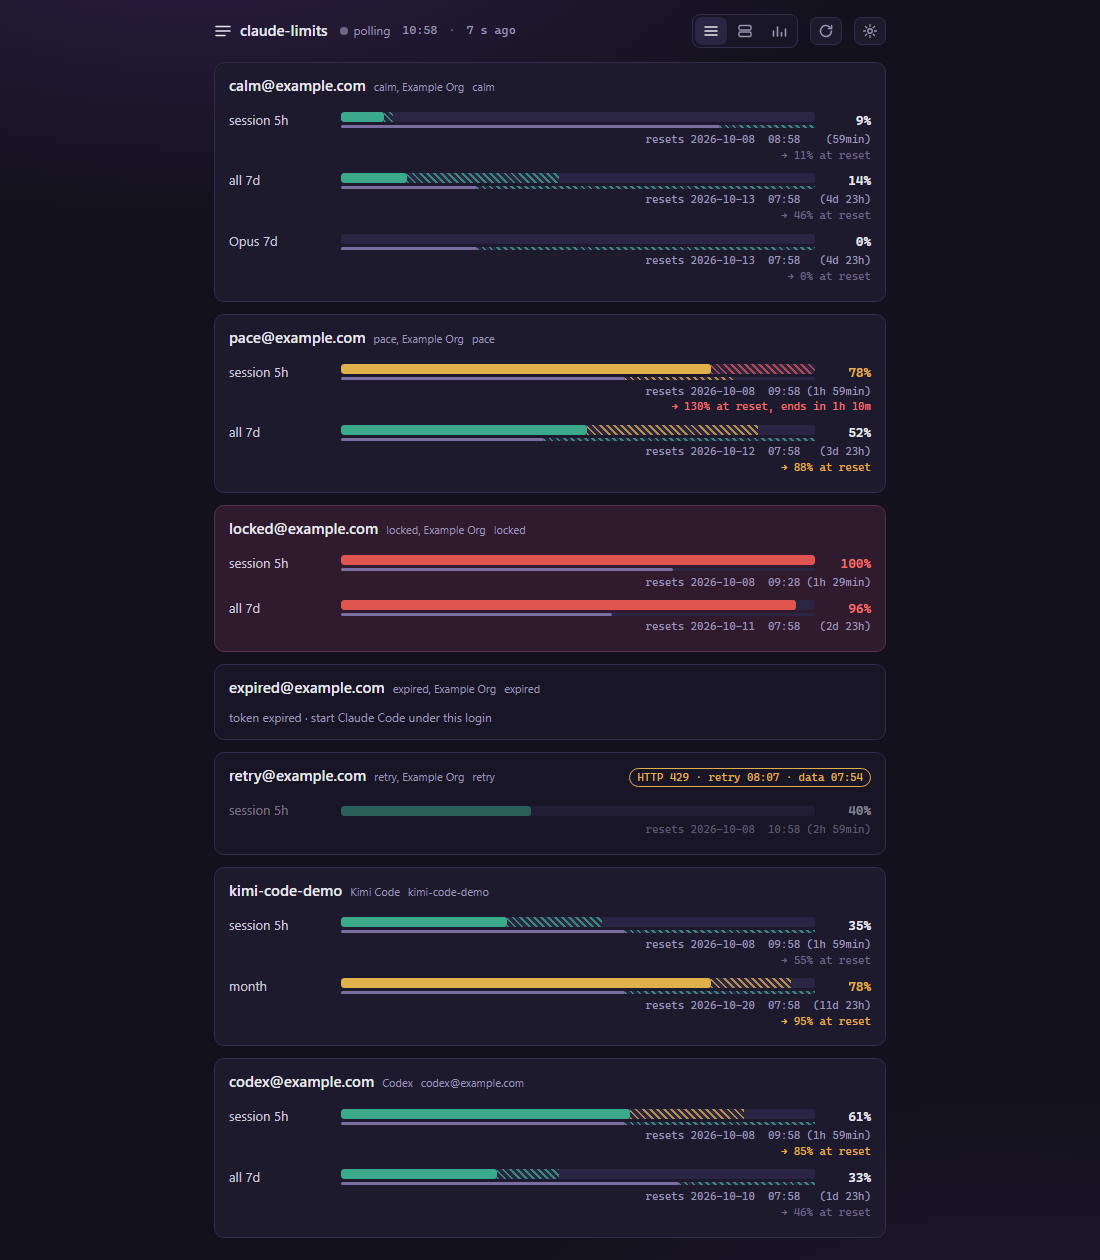
Что видно на странице
Каждая карточка — один логин, каждая строка — одно окно лимита. Толстая полоса показывает, сколько уже потрачено: зелёная, с 70% жёлтая, с 90% красная. Под ней тонкая линия: какая доля окна уже прошла. Если полоса обгоняет линию, вы тратите быстрее, чем идёт время.
Поверх этого два прогноза, оба штриховкой.
На толстой полосе: где окажется расход к моменту сброса, если темп не изменится. Подпись:
→ 46% at reset.На тонкой линии: до какой доли окна хватит квоты. Если до самого сброса, штриховка зелёная до конца.
Первый отвечает на вопрос «сколько останется», второй — «когда кончится». Дальше о том, как они считаются и где я ошибался.
Прогноз первый: процент к сбросу
Самое простое, что можно сделать, — линейная экстраполяция: взять скорость расхода и продолжить её до сброса. Вопрос только в том, какую скорость брать.
Если брать среднюю за всё окно, прогноз будет помнить, что в понедельник вы почти не работали, и врать в четверг. Поэтому скорость считается по свежей истории: для сессии за последний час, для недели и месяца за последние три дня. Скорость — это темп работы, а не свойство окна, так что если окно сбросилось внутри этих трёх дней, хвост прошлого окна тоже идёт в расчёт. Отрезается только участок, где лимит был исчерпан и расход стоял на месте. Сам сброс утилита замечает по резкому падению процента.
Дальше арифметика (src/model/forecast.nv):
    ro rate_x1e6 = (used_percent * 1000000) / window_min

    // `rate <= 0` means the spend did not grow over the window: the honest forecast is
    // "it stays where it is", not a fall (§2.7).
    if rate_x1e6 <= 0 {
        return { available: true, percent_at_reset: percent_now, runs_out_in_min: -1,
                 rate_per_hour_x100: 0, basis, warning: false }
    }

    ro at_reset = percent_now + (rate_x1e6 * remaining_min) / 1000000
    ro left = 100 - percent_now
    ro runs_out = if at_reset < 100 { -1 } else { (left * 1000000) / rate_x1e6 }
Скорость хранится целым числом, в миллионных долях процента за минуту. Почему не f64: у утилиты есть эталонная реализация на Python, и обе версии должны выдавать одну и ту же подпись до последней цифры. Плавающая точка добавила бы ещё один способ разойтись в последнем знаке. Сначала точность была в сотых, и на одном примере 2,06% в час превращались в 1,80%: при делении 7400 на 2160 целое даёт 3. На десятитысячных момент исчерпания всё равно отставал от эталона на 46 минут. На миллионных расхождение исчезло.
Ещё два правила. Прогноз никогда не обещает, что расход упадёт: если за интервал он не вырос, честный ответ — «останется как есть». И если к сбросу выходит больше 100%, считается момент, когда лимит кончится. Подпись тогда становится длиннее: → 103% at reset, ends Fri ~18:40 (14h 58min).
Цвет штриховки зависит от прогноза к сбросу: от 80% жёлтый, от 95% красный. Поэтому бывает зелёная полоса на 40% с красной штриховкой до 95%. Так и задумано: сейчас всё хорошо, а к пятнице будет плохо.
Когда прогнозу верить рано
Первой версии хватало получаса истории. После первого часа работы с 1% недельного лимита она уверенно рисовала красное: если тратить так всю неделю, лимит кончится через четыре дня. Арифметика верная, но один час работы ничего не говорит о неделе.
Теперь прогноз появляется, только когда история покрывает хотя бы 5% окна, но не меньше получаса:
    ro span_ms = now_ms - first.at_ms
    ro min_span_ms = MIN_SPAN_MS.max(((l.window_sec + 19) / 20) * 1000)
    if span_ms < min_span_ms { return None }
Для сессии это 30 минут, для недели 8 часов 24 минуты, для месячного окна Kimi 36 часов. До этого на странице нет штриховки, а у процента подсказка forecast later. В спецификации это правило прямо названо эвристикой достаточности истории, а не обещанием точности.
Прогноз не считается и тогда, когда цифрам нельзя доверять: аккаунт заблокирован, токен просрочен или сервер ответил 429.
Прогноз второй: на какую долю окна хватит
Когда лимит кончается раньше сброса, процент к сбросу говорит мало. Важнее, сколько ещё можно работать. Для этого тонкая линия под полосой тоже получает штриховку: от точки «сейчас» до момента, когда при текущем темпе кончится квота. Если она не кончится до сброса, штриховка идёт до конца окна и остаётся зелёной. Если кончится раньше, чем пройдёт 95% окна, она жёлтая, раньше 80% — красная.
Здесь нашлась ошибка, которую поймал тест. Длину окна сначала брали из ответа сервера, а прогресс — из типа окна (5 часов, 7 дней, 30 дней). Штриховка и заливка мерились разными линейками и расходились на краях. Теперь обе считаются от одного и того же окна.
Есть и нерешённый вопрос, он записан в docs/open-questions.md. Две штриховки одной строки красятся по разным шкалам: верхняя по проценту к сбросу (80/95), нижняя по доле окна (80/95 от окна). При прогнозе 97% верхняя уже красная, а нижняя ещё зелёная: лимит кончится, но за считанные минуты до сброса. Обе правы, но рядом это выглядит как противоречие. Пока оставил как есть.
Ночь и выходные
Линейный прогноз не знает, что ночью вы спите. В пятницу вечером он смотрит на темп рабочего дня и обещает, что к понедельнику лимит кончится. В спецификации так и сказано: без графика прогноз в пятницу вечером всегда «не хватит».
Поэтому есть ручной график работы: рабочие дни, часы и доля темпа вне их. Минута внутри графика весит полностью, минута вне его — меньше. Скорость считается по таким «эффективным» минутам, и момент исчерпания тоже ищется проходом вперёд с весами. По умолчанию график выключен: я не хочу, чтобы утилита гадала о чужом расписании.
У этого подхода есть слабое место. Если вся свежая история записана ночью, при включённом графике эффективных минут получается ноль. Раньше в таком случае выходил ровный выдуманный прогноз, теперь честное «пока нет данных».
У меня ритм задаётся вручную. Учиться ему автоматически — следующий шаг.
Откуда берутся цифры
Цифры утилита берёт те же, что показывает /usage: у Claude это OAuth-эндпоинт использования, у Kimi Code и Codex свои. Все три не документированы, и это главное ограничение: любое обновление может их сломать. Об этом сказано в README и в описании релиза.
Какие логины читать, утилита не угадывает: каталоги с кредами задаются в настройках, как это сделать — в конце статьи. Список перечитывается каждый раунд, так что новый логин появляется без перезапуска.
Файлы Claude утилита только читает. Если токен просрочен, она обновляет его запуском самого Claude Code под нужным каталогом и ничего не пишет в его файлы. Токен Kimi обновляется напрямую, а Codex не обновляется совсем.
Живые запросы принесли сюрпризы, которых не было в тестах:
без заголовка
anthropic-beta: oauth-2025-04-20эндпоинт Claude отклоняет запрос, а моки этого, конечно, не знали;ответ приходит кусками (
Transfer-Encoding: chunked), тело начиналось с9fc, и разбор JSON падал, пришлось написать свой разбор;при ответе 429 первая версия стирала цифры с экрана, ровно когда они нужнее всего. Теперь последний удачный снимок остаётся на месте, приглушённый, с пометкой
429 · retry HH:MM · data HH:MM: когда будет повтор и от какого времени цифры.
Почему на Nova
claude-limits — первая настоящая программа на Nova: около 17 тысяч строк кода и почти столько же тестов, HTTP-клиент с TLS, веб-сервер на Polaris, веб-фреймворке, который тоже написан на Nova, история в DuckDB. DuckDB — встраиваемая база, как SQLite, только с упором на аналитические запросы. Она собрана прямо в исполняемый файл, ставить отдельно ничего не нужно.
Три возможности языка здесь пригодились больше всего.
Эффекты в сигнатуре. Функция, которая собирает данные по всем аккаунтам, объявляет, с чем работает: fn collect_round(rounds Rounds) Http Dirs Creds Time -> Round. Dirs и Creds — свои эффекты для каталогов и токенов, и у них нет операций записи. Записать в файлы Claude такой код не может: соответствующую операцию просто нечем вызвать.
Тесты без мок-фреймворка. Сеть и время подменяются обработчиком прямо в тесте:
fn poll_against(raw str) -> AccountState {
    mut state = AccountState.Unknown
    with Http = effect Http {
        send(host, port, secure, request) -> Result[str, HttpError] { Ok(raw) }
    } {
        state = fetch("api.example.com", 443, true, "/v1/usage", "t").outcome.state
    }
    state
}
Функция fetch та же, что в боевом коде, только сеть отвечает заранее заданной строкой. Так проверяются и 429, и разбор кусков, и истёкшие токены.
Токен как ресурс. Тип Secret объявлен consume: его нельзя скопировать, а при отладочной печати он выводит Secret(hidden). Токен нельзя случайно положить в лог или передать в два места.
Было и трудное: язык молодой, в компиляторе пока есть ошибки. Несколько типов пришлось переименовать: Outcome столкнулся с другим именем в сгенерированном C, Token — с одноимённым типом из стандартной библиотеки JSON, а Forecast путал проверку типов с типом настроек config.Forecast. Был дефект, из-за которого все моменты времени читались как полночь. Эти ошибки чинились в компиляторе, а утилита работала тестом для них.
Чем это отличается от аналогов
Прогнозировать расход умеют и другие утилиты.
ccusage в режиме
blocks --liveпоказывает скорость и прогноз на пятичасовое окно. Он считает по локальным логам и сравнивает с лимитом, который вы задаёте сами.claumon берёт те же официальные цифры и даёт прогноз к сбросу с интервалом.
Claude Code Usage Monitor и ReserveGauge тоже прогнозируют, второй помнит несколько аккаунтов.
Claude Tuner считает скорость по активным часам и сам учитывает недельный ритм пользователя. По данным автора, переоценка днём от этого упала на 63%.
Что есть в claude-limits:
все логины на одной странице, причём сразу трёх сервисов: Claude Code, Codex и Kimi Code;
официальные цифры
/usage, те же, что в самом Claude Code;два прогноза на каждое окно: процент к сбросу и доля окна, на которую хватит;
рабочие дни и часы задаются в настройках, и ночь с выходными не раздувают прогноз; история с сохранением; уведомления в браузере на 70% и 90%.
Ограничения
Эндпоинты не документированы и могут сломаться.
Прогноз — линейная экстраполяция по двум точкам, без сглаживания. Ритм дня учитывается только через ручной график.
Готовая сборка есть для Windows x64. На Linux пока работает эталонная реализация на Python из того же репозитория, а на macOS токены лежат в Keychain, и это вне рамок.
После ответа 429 утилита пока не делает паузу для отдельного аккаунта: все аккаунты опрашиваются с общим интервалом, по умолчанию раз в 5 минут.
Как попробовать
Скачайте
claude-limits-0.1.1-windows-x64.zipсо страницы релизов и распакуйте.Запустите
claude-limits --serveи откройте в браузереhttp://127.0.0.1:7391.Сначала страница пустая: логины утилита сама не ищет. Откройте настройки (кнопка вверху страницы), в разделе Login folders вставьте путь к каталогу, где лежат креды, нажмите Check, затем Save:
Claude Code — каталог с
.credentials.json, обычно%USERPROFILE%\.claude. Можно указать и папку, в которой лежат несколько таких каталогов, тогда подхватятся все логины сразу;Kimi Code —
~/.kimi-code;Codex —
~/.codex, где лежитauth.json.
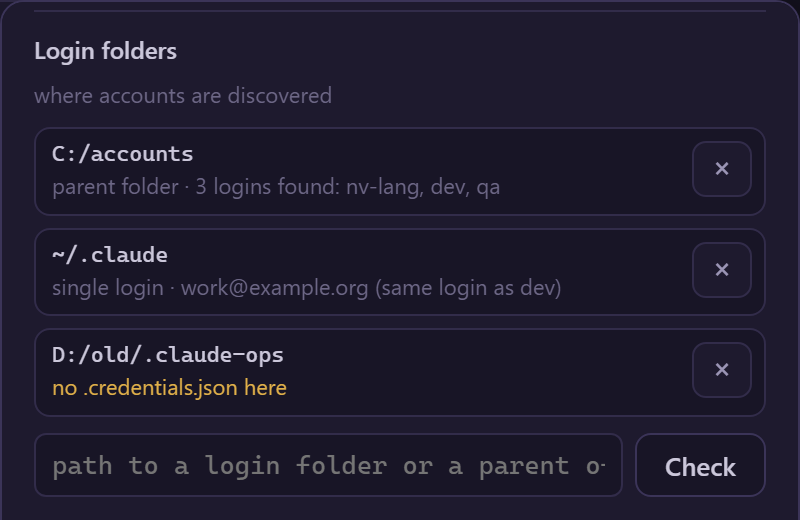
Аккаунты появятся со следующего раунда опроса. Те же пути можно прописать вручную в claude-limits.toml в разделах [[folders]].
А как вы следите за лимитами? Хватает ли вам /usage, или тоже упирались в лимит в самый неудобный момент?