Старый добрый Proxmox с его контейнерами и виртуалками - по-прежнему рабочая лошадка многих компаний. И если нарезать много-много мелких контейнеров, то может случиться, что память куда-то девается со временем, а контейнеры падают в OOM без очевидной причины. Причем не все. Причем иногда. И зачастую проще перезапустить и ехать дальше чем разбираться. А причина есть, и она оказалось довольно проста.
Так уж получилось, что у меня в ведении небольшая серверная ферма из пяти серверов, на которой крутится два с половиной десятка контейнеров и полтора десятка виртуалок, все вместе образующие ни много ни мало как оператора связи - с 2G и 4G сотовой связью, публичным вайфаем, проводными клиентами, биллингом, порталами и прочим обвесом. Все как у больших, просто крошечное, соразмерное острову с двадцатью тысячами населения посреди океана.
С 2017 года там используется Proxmox, сперва 6, потом 7, теперь уже 8. И все эти годы я наблюдал и без особого энтузиазма исследовал один эффект: куда-то медленно но верно утекает память. Время от времени некоторые контейнеры без видимой причины падают, одни и те же, в трудно предсказуемые моменты.
Нельзя сказать что я не искал совсем причину, но в Очень Маленькой Компании всегда задач и проблем больше, чем рук и мозгов. Поэтому решение нашлось только после апгрейда на восьмую версию, обострившего проблему.
До "восьмерки" проблема выглядела так:
На всех серверах медленно-медленно уменьшается количество свободной памяти. Процесс неспешен и неотвратим. Куда девается - не очень понятно, грешил на ZFS, и ограничение ее аппетитов действительно помогло, но количественно, а не качественно.
Избранные контейнеры иногда падают, просто падают и все. Никаких следов проблем в мониторинге, на момент падения память свободная есть и ее немало. Мистика!
Но поскольку всяко уж раз в несколько месяцев обновление серверов делается и они перегружаются - то жить это сильно не мешало. Это все же маленький, но оператор связи, все критическое зарезервировано вдвое и втрое, поэтому проще пнуть остановившийся контейнер руками, благо мониторинг на месте.
Начиная с "восьмерки" ситуация поменялась:
На самих серверах исчезла "утечка", да и вообще суммарное потребление памяти внезапно сильно уменьшилось.
Зато мониторинг контейнеров начал показывать непрерывное падение available вплоть до нуля, ну и в итоге OOM и падение. Причем коснулось оно большего числа контейнеров, чем раньше.
А вот скорость этой потери на разных контейнерах очень разная - от почти нулевой до весьма впечатляющей.
И вот это уже что-то с чем можно работать.
Гипотеза об утечке памяти в приложениях была и раньше, и еще раз опровергнута. Используются в основном весьма "старые" приложения, устаканившиеся, без детских болезней. Идея, что freeradius или kannel могут "потечь" на смешных нагрузках - она сама по себе странная. Поэтому все пляски с top/htop оказались безрезультатны.
Тем временем стало понятно, что вся память уходит в shared. Который растет, растет, растет - пока не сожрет все свободное. И... пропустив нудный процесс дознания с пристрастием прямо переходим к обвинительному заключению, логика утечки оказалась весьма забавной:
LXC, как все вы конечно знаете, это обычный образ linux rootfs без ядра, запущенный в chroot, с отдельными неймспейсами и ограниченный по ресурсам с помощью cgroups. Соответственно и размер памяти, что мы задаем контейнеру - это просто лимит в cgroups.
А внутре у ней
неонкаобычный systemd. Который начинает с того, что монтирует tmpfs в/run. Причем делает это с размером по умолчанию.А tmpfs, как все вы конечно знаете, размещается в памяти. И его размер по умолчанию, если не указан явно, равен половине размера физической памяти.
Ядро при создании tmpfs с размером по умолчанию не принимает во внимание никакие ограничения cgroups. И потому нарежет размер в половину физической памяти.
Таким вот образом мы получаем tmpfs размером 63GB смонтированный в
/run. Но при этом все, что будет туда записано - должно все же помещаться в пределы, определенные в cgroups, и да, командойfreeоно показывается именно как shared.journald, как все вы конечно знаете, использует
/run/log/journalсперва чтобы писать лог во время загрузки, а вот дальше все интереснее. По умолчанию стоит опцияStorage=auto, что означает следующее: если каталог/var/log/journalприсутствует на диске, то пишем в него, а если нет - то продолжаем писать в/run/log/journal.journald совсем не хочет делать нам проблемы, поэтому по умолчанию устанавливает лимит на использование
/runв 10% от размера файловой системы. Т.е. в моем случае это примерно 6.3GB. При том что на контейнер выделяется от 1 до 2 GB, там очень экономные приложения живут.Собственно, здесь и встречаются несколько факторов, которые в зависимости от конкретного образа контейнера могут выстрелить или не выстрелить. И в худшем (моем) случае journald пишет в
/run(читай - в память), будучи уверенным, что писать можно аж до 6GB, пока не упирается в лимиты cgroups (1..2GB), после чего OOM киллер расстреливает всех по очереди до самого systemd включительно. Приехали!
Просто звезды дефолты сошлись в неудачное сочетание, всего-то!
Когда причина найдена, возникает вопрос: почему это не было видно в мониторинге состояния контейнеров до апгрейда на восьмерку? К счастью, остался и один старый хост, проверив на котором выяснил следующее:
Команда free внутри LXC в PVE7 показывает available memory без учета shared. И по этому по мере заполнения tmpfs она не убывает. Но очевидно уходит память на самих физических серверах. И к тому же похоже что лимиты cgrouop срабатывают не всегда. Не знаю почему так и не хочу разбираться.
А вот в PVE8 available показывает с учетом, и она постепенно стремится к нулю.
Ну и когда проблема ясна, становится ясно и как с этим бороться, вариантов масса:
Можно перемонтировать
/runна сообразный размер путем добавления в/etc/fstabчего-то вродеnone /run none remount,size=128M 0 0. Но при этом надо понимать, что это не единственный tmpfs в системе, и все они будут огромного размера. И непонятно что делать с остальными. И надо ли.Можно не забыть создать каталог
/var/log/journal, и тогда journald не будет выжигать память даже при дефолтных настройкахМожно настроить journald через опции в
/etc/systemd/journald.conf:Storage=persistent, и тогда tmpfs будет использован только при загрузке, а затем все будет сброшено на диск, необходимые каталоги он создаст самRuntimeMaxUse=128M, и тем ограничить предел использования tmpfs
А можно все перечисленное сразу, это уже дело вкуса.
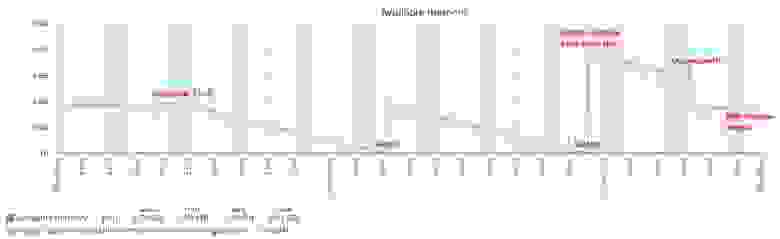
На этом для меня многолетняя "сказка о потерянной памяти" закончилась, все ровно и стабильно, ничего никуда не девается. А вся история в графике мониторинга выглядит примерно вот так:
Ну вот и хорошо, можно заняться и другими проблемами, которых в любом хозяйстве - не перерешать...