Вы когда-нибудь задумывались о том, что у человеческого мозга есть ограниченная емкость и вы можете выучить этот чертов английский просто потому что в детстве запомнили слишком много покемонов? Или почему обучение с учителем гораздо эффективнее, чем самостоятельное?
Эти вопросы вполне применимы и в области машинного обучения. Для обучения модели диффузии требуется много данных и вычислительной мощности, а затем для создания изображений требуется значительное количество вычислений и серьезное оборудование. Исследователи (у которых обычно нет денег и на доширкак) задали очень хороший вопрос - можно ли достичь тех же результатов с меньшими усилиями?
Ответ - да. Есть простой трюк, который мы можем использовать - дистилляция модели.
Чтобы понять, как это работает, давайте сначала посмотрим на обычный процесс обучения модели.
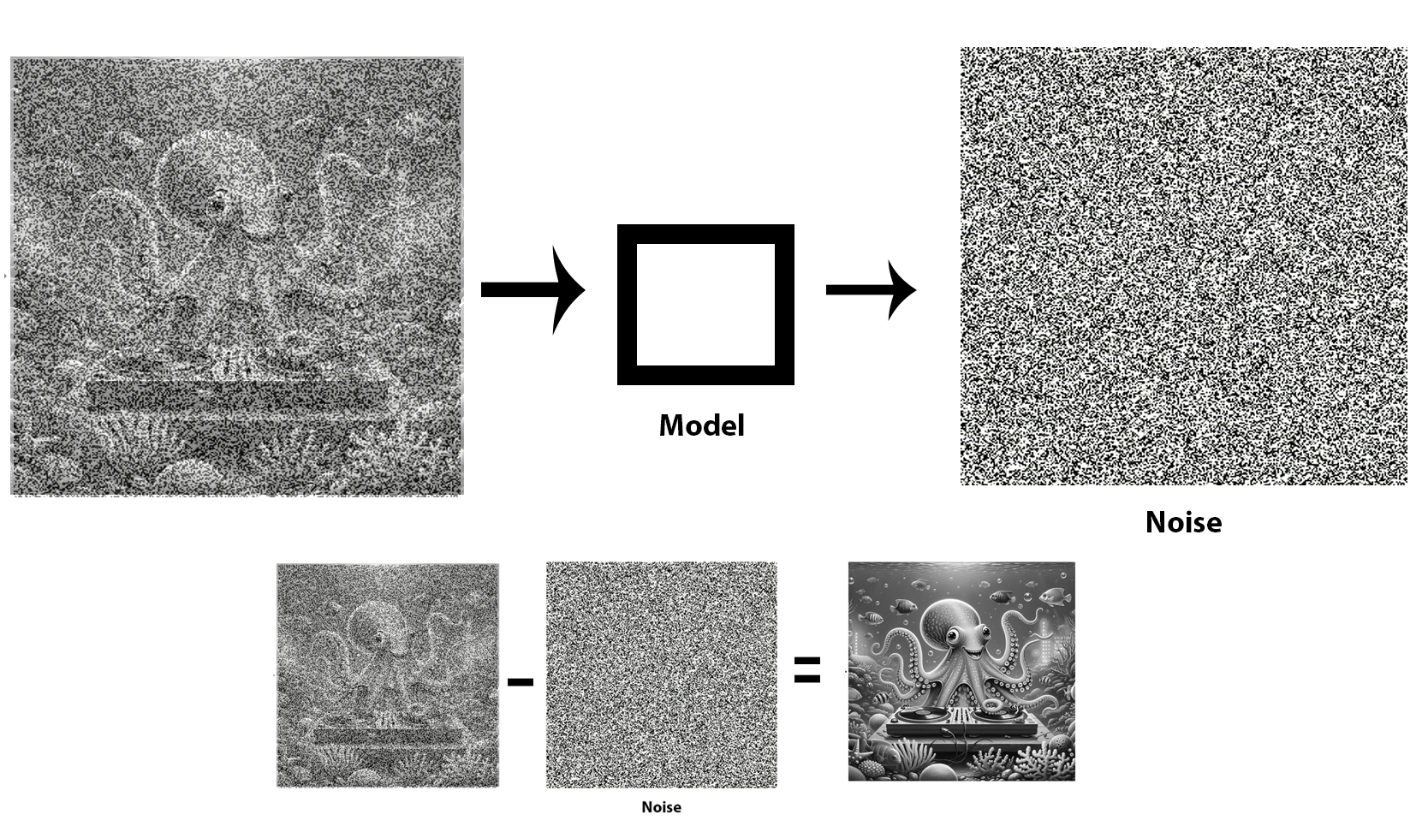
Модели диффузии учатся генерировать данные, обращая процесс диффузии вспять, т.е. модель учится превращать случайный шум в согласованное изображение (обычно соотвествующее заданному промпту).
Обычно происходит что-то вроде этого:
мы берем кучу маркированных изображений и постепенно добавляем к ним шум в соответствии с графиком шума
затем мы обучаем модель предсказывать добавленный нами шум.
Во время вывода:
мы генерируем начальное изображение с чистым случайным шумом
модель предсказывает шум
мы постепенно удаляем предсказанный шум из начального случайного зашумленного изображения, используя данный запрос, и таким образом создаем конечное изображение.
Более подробное описание можно найти здесь.
Визуально это выглядит следующим образом:
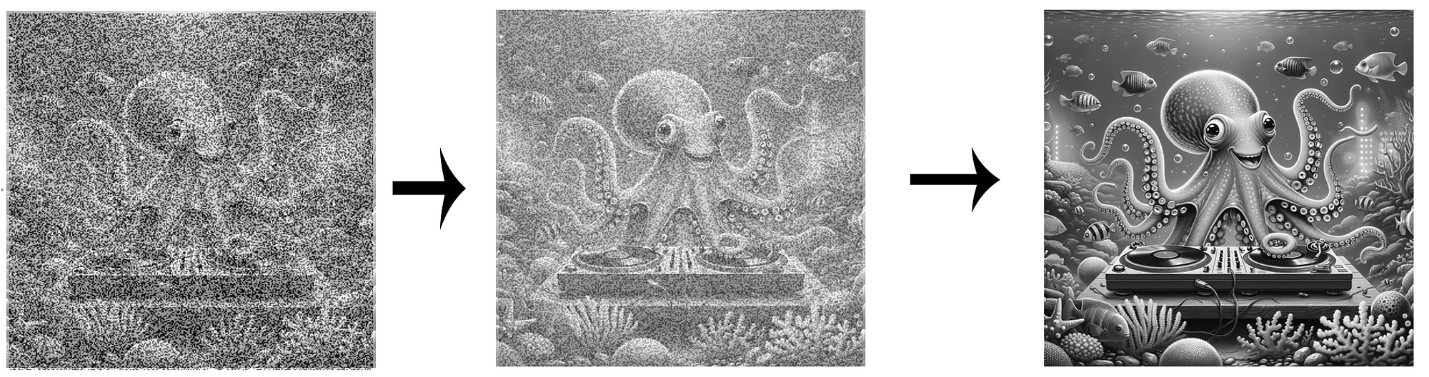
Проблема здесь в слове постепенно. Это требует сотен шагов, и каждый из них требует большого количества вычислений.
Почему мы делаем это таким образом? Ну, мы не можем просто перейти от шума к согласованному изображению, это привело бы к абстрактным сюрреалистическим результатам. Шум случаен и не содержит изображение как таковое (как правило). Постепенное удаление шума позволяет раскрыть общий контур изображения, который затем может быть детализирован шаг за шагом, используя предыдущие шаги в качестве базы. То же самое с людьми – вы не можете написать целое приложение на Python за один раз – обычно вы пишете код по частям, и он как бы эволюционирует.
Но почему нам нужно так много шагов? По-видимому, это больше результат начального математического описания проблемы, чем что-либо еще. Это напоминает мне, как часто формулировка проблемы и используемый язык диктуют решение.
Вот как это было постулировано:
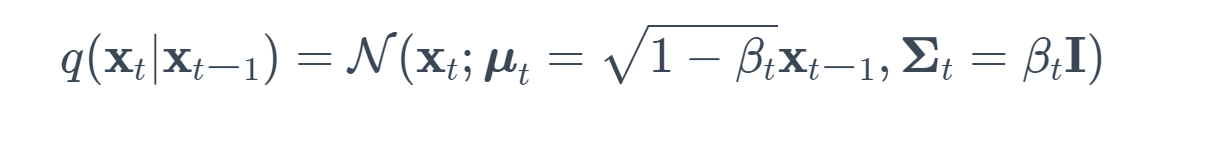
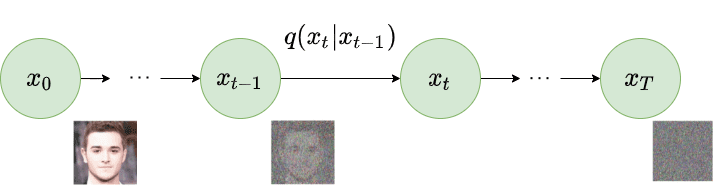
Изображение из статьи Denoising Diffusion Probabilistic Models.
Прямой процесс или процесс диффузии фиксируется в Марковской цепи, которая постепенно добавляет гауссовский шум к данным в соответствии с графиком дисперсии β1,...,βT. Учитывая точку данных x0, выбранную из реального распределения данных q(x) (x0∼q(x)), мы можем определить прямой процесс диффузии, добавляя шум. Конкретно, на каждом шаге мы добавляем гауссовский шум с дисперсией βt к xt−1, создавая новую скрытую переменную xt с распределением q(xt∣xt−1). Этот процесс диффузии может быть сформулирован следующим образом:
Этот процесс требует множества шагов для работы.
Вот и трюк. Мы берем предварительно обученную модель, которая была обучена старым способом, используя миллионы долларов, и используем ее как учителя для обучения другой модели, которую мы называем учеником, и эта модель будет обучаться предсказывать не шум на изображении. Мы обучаем ее предсказывать следующий шаг родительской модели, используя среднеквадратичное отклонение между их результатами в качестве функции потерь и градиентного спуска. Эта модель все еще не так эффективна, потому что мы все равно собираемся предсказывать то же количество шагов, что и родительская модель, и она собирается использовать то же количество вычислительной мощности. Так как мы можем оптимизировать это?
Идея здесь в том, что мы не делаем это вышеописанным способом. Если подумать , а зачам нам нужно предсказывать каждый шаг выборки
Интересные статьи
Интересные статьи