


Дано
- Монорепозиторий на базе Lerna и Yarn workspaces.
- Десяток приложений, и десятки общих пакетов на TypeScript, Angular, NodeJS.
- Высокое покрытие тестами самых разных мастей (модульные, интеграционные, e2e).
- и Atlassian Bamboo CI/CD.
Задача
Ускорить имеющиеся пайплайны в 2 раза (до, хотя бы, получаса). Попутно повысив стабильность до 90%.
Забегая вперед, скажу что требуемые показатели были достигнуты.
Было
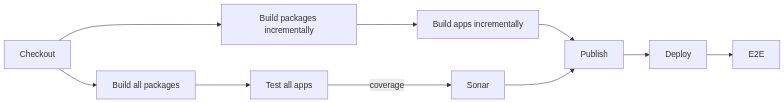
Для инкрементальной сборки lerna filter options:
lerna run build:packages --since --include-merged-tags --include-dependenciesЧтобы попасть в инкремент пакеты должны проходить фазу lerna publish в артифакторий (JFrog):
# Master
lerna publish patch --yes
# Feature
lerna publish prepatch --yes --no-push --preid "${PREID}"
При такой организации pipeline, возможно только вертикальное масштабирование путём увеличения мощностей elastic агентов.
Этот подход крайне ограничен. И с ростом числа пакетов средняя длительность постепенно росла (~1ч).
Надо заметить, что в силу короткого релизного цикла (сутки), стабильность JFrog и, как следствие, всего pipeline была низка (~70%).
Идея
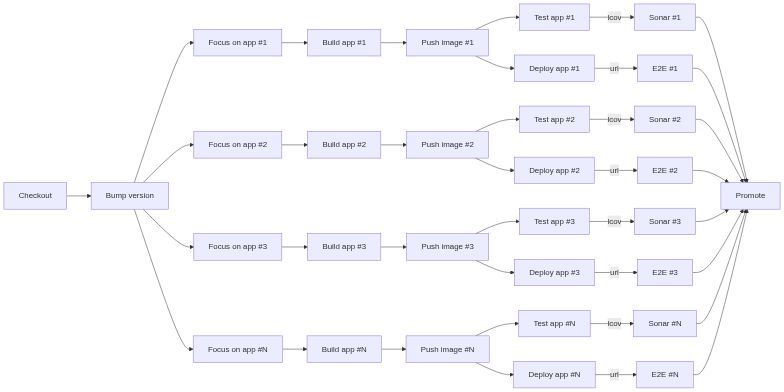
Собирать каждое приложение независимо от остальных.
На входе — монорепозиторий
На выходе — production image приложения.
Тестировать тоже независимо от остальных.
На входе — production image (зависимости устанвлены, все пакеты собраны)
На выходе — отчеты о тестировании и покрытии.
Это позволит собирать и тестировать в параллельном режиме, масштабируясь горизонтально по мере развития линейки продуктов.
Но в таком случае размер node_modules составил бы ~1.5Gb (суммарные зависимости всех пакетов монорепозитория). Что негативно отразилось бы на размере image, времени его загрузки в AWS ECR, и времени развертывания.
Фокусировка
Чтобы "урезать" ("сфокусировать") монорепозиторий для сборки, тестирования и развертывания одного конкретного приложения, достаточно найти подмножество пакетов в общем графе пакетов и переписать декларацию workspaces в корневом package.json непосредственно перед сборкой на CI.
#!/usr/bin/env node

const { spawnSync } = require('child_process');
const { existsSync, promises: { readFile, writeFile } } = require('fs');
const { join, dirname, relative, normalize } = require('path');

const PACK_JSON_PATH = './package.json';

(async (apps) => {
    const packJSON = JSON.parse((await readFile(PACK_JSON_PATH)).toString());

    await spawnSync('yarn', ['global', 'add', 'lerna'], { shell: true });

    const locations = await listPackages(apps);

    const [someLocation] = locations;
    const basePath = findBasePath(someLocation);

    // All paths should be relative to monorepo root
    const workspaces = locations.map((loc) => normalize(relative(basePath, loc)));

    packJSON.workspaces.packages = workspaces;

    const packJSONStr = JSON.stringify(packJSON, undefined, 2);
    await writeFile(PACK_JSON_PATH, `${packJSONStr}\n`);
})(
    process.argv.slice(2),
);

async function listPackages(apps = []) {
    const filterOptions = apps.flatMap((app) => ['--scope', app]);
    const { stdout } = await spawnSync(
        'lerna',
        ['ls', '-pa', '--include-dependencies', ...filterOptions],
        { shell: true },
    );
    return String(stdout).split(/[\r\n]+/).filter(Boolean);
}

function findBasePath(packageLocation) {
    return existsSync(join(packageLocation, 'lerna.json'))
        ? packageLocation
        : findBasePath(dirname(packageLocation));
}
После "фокусировки" все команды (в том числе и changed) будут относится лишь к подмножетсву пакетов конкретного приложения.
Размер node_modules удалось снизить в среднем в 3 раза.
Fixed mode
Lerna fixed mode, отказ от lerna publish и артифактория позволили повысить стабильность и упростить логику pipeline.
Но как же быть с инкрементальностью сборок?
Инкремент
Для инкремента достаточно отслеживать изменения через команду lerna changed
lerna changed -a --include-merged-tagsЕсли изменений не обнаружено, то можно переиспользовать latest image приложения для развертывания и тестирования:
#!/usr/bin/env bash

APP=$1

lerna-focus.js "${APP}"

function nothing_changed() {
    [[ -z "$(lerna changed -a --include-merged-tags || true)" ]]
}

function pull_latest_image() {...}
function push_latest_image() {...}
function tag_latest_with_version() {...}

pull_latest_image

if nothing_changed; then
    tag_latest_with_version
    exit
fi

build-app.sh "${APP}"

if is-master.sh; then
    push_latest_image
fi
Стало
Что дальше?
Сейчас активно набирают обороты такие решения как Nx: Extensible Dev Tools for Monorepos. Это предмет следующих разборов.
Если эта статья окажется полезной, то в следующей расскажу о горизонтальном масштабировании "на коленке" модульных тестов (Angular, Jest, ElasticSearch, Bamboo CI).


