Модельно-ориентированный метод (MDE) широко применяется во многих сферах современной инженерии; в программировании он позволяет разделить деятельность, направленную на создание универсального описания продукта, от деятельности по написанию кода, который бы эту модель воплощал в реальность. На практике, в мире Java эти деятельности по-сути совмещены воедино языком программирования, так как мы определяем интерфейсы на том же языке, на котором потом и пишем реализацию, поэтому грань между моделью и кодом может быть не так очевидна. Однако, она отчетливо проявляется, когда требуется интегрировать нашу программу в работу более сложных систем: например, я бы хотел запускать мою CLI утилиту как сервис, доступ к которому можно было бы получить через любой язык программирования по сокетам, сохранив при этом хороший Dev-X с автозаполнением полей и описанием опций. Сделаем это в 3 этапа под катом: во-первых, сконвертируем существующий Java-класс, который описывает флаги, в модельно-ориентированный XML, затем из него сгенерируем protobuf файлы для бинарного обмена данными и в завершение скомпилируем их для JavaScript и Java, обернув в приличный JSDoc. В конце обсудим все преимущества работы "на модель" и будущее роли дизайна при разработке ПО.
Вступление: пациент
В качества примера будет выступать программа под названием Google Closure Stylsheets, которую я форкнул и выпускаю как Exposure Stylsheets (более подробно про нее написано тут: Компилирование «железного» бинарника Java-программы Google Closure Stylesheets с GraalVM). В двух словах, это компилятор CSS с такими фичами как миксины, функции и переменные. В предыдущем материале я привел бенчмарк, на котором видно, что при каждом запуске только на развертывание виртуальной машины JVM уходит около 2х секунд, что не есть очень хороший показатель, когда часто редактируешь CSS код и ожидаешь, что он сразу обновится в браузере. Поэтому еще пару лет назад я добавил функцию сокет-сервера, чтобы держать процесс открытым: то есть вместо получения аргументов из коммандной строки, вывода результатов и закрытия, программа теперь запускается 1 раз и может принимать сколько бы то ни было запросов на компиляцию CSS, не тратя 2с на загрузку классов. Это особенно подходит мне, так как остальная архитектура стека базируется на JavaScript, и написав клиент на Node.js, я могу пользоваться этим чудом техники из другого языка программирования.
Однако я такой человек, для которого все должно быть красиво и идеально, а идеал по созданию любой JavaScript библиотеки это, конечно, JSDoc, который дает доступ к автокомплиту во время ввода данных и максимально ускоряет процесс разработки, так как можно сразу прочитать про все опции и выбрать нужную:

При этом принцип красивости идет нога в ногу с принципом неповторяемости (DRY - don't repeat yourself, "не повторяй себя"). Дело в том, что все опции уже описаны в Java коде, напр.,
@Option(name = "--allow-def-propagation", usage = "Allows @defs and @mixins"
+ " from one file to propagate to other files.")
private boolean allowDefPropagation = true;

@Option(name = "--allow-unrecognized-functions", usage =
"Allow unrecognized functions.")
private boolean allowUnrecognizedFunctions = false;
Так не буду же я копировать вручную каждую опцию и переносить в JavaScript? В модельно-ориентированной парадигме всегда есть только один источник правды, на который мы можем накладывать трансформации, чтобы получить определенную цель: сегодня это JavaScript, завтра -- Ruby, и т.д. Как только вы находите себя в ситуации, когда у вас уже есть какая-то истина, которую можно переиспользовать, вам нужно добавить ее в модель, сгенерировать цели в виде интерфейсов / стабов и потом наложить реализацию. Проблема сегодня в том, что библиотек под разные языки просто куча, а вот ходовых инженерных решений для поддержания модели и написанию плагинов по ее трансформации -- мало (хоть у нас и есть UML, он не очень гибок в использовании). Так как же мы можем вынести всю истину опций из Джавовского класса в модель и переиспользовать ее?
Часть I: конвертация
Самый оптимальный вариант держания модели программы для меня -- это старый-добрый XML: интерфейсы и рекорды имеют древо-образную структуру, поэтому в качестве контейнера правды я и выбрал этот формат. Наша задача на данном этапе -- это просканировать ClosureCommandLineCompiler.java и достать из него все доступные флаги, которые были аннотированы тегом @Option, а так же их типы, описания, алиасы и значения по умолчанию:
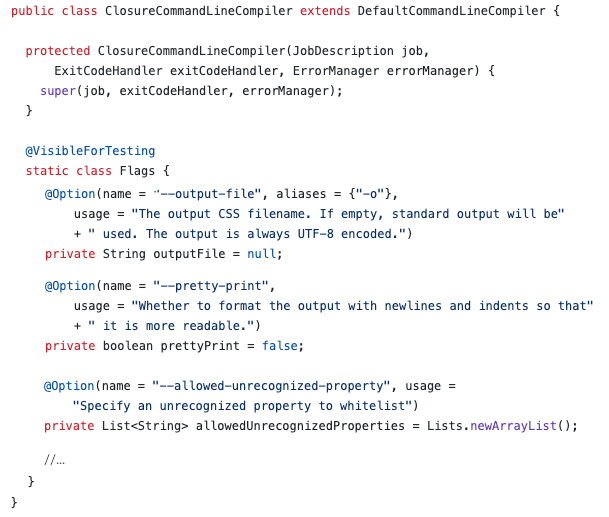
ClosureCommandLineCompiler через @Option аннотациюТут, конечно, можно пойти 4 путями:
используя парсер Java-кода, составить AST для класса (про);
запустить Java программу, и с помощью
магиирефлексии вытащить аннотации (нотбэд).используя регулярку, извлечь нужные данные (оптимум);
руками вытащить все данные путем копирования-вставки (изи).
Я примерно прикинул, что чтобы достать около 15 опций, мне скорее всего придется потратить столько же времени на написании регулярки, сколько я потрачу на копи-пейст, поэтому не будем выпендриваться и прибегнем к этому народному методу. А так как все опции из Java класса я потом все равно уберу и буду генерировать их из модели, это не противоречит DRY принципу. С другой стороны, если бы оригинальный проект активно поддерживался Гугл, а я вел форк, я бы все-таки написал регулярку, чтобы автоматически синхронизировать мой проект с источником.
Итак, как же будет выглядеть наш XML? Примерно вот так:
<types namespace="tools.exposure.stylesheets">
 <record name="Options">
   <string name="outputFile" proto="1">
     <java-type>String</java-type>
     <java-default>null</java-default>
     <opt-alias>-o</opt-alias>
     The path to the file where to save compiled output CSS. If not passed, the
     compiler will print output to the stdout. UTF-8 encoding will always be
     used.
   </string>
   <bool name="prettyPrint" proto="4">
     <java-type>boolean</java-type>
     <java-default>false</java-default>
     Use indentation, newlines and whitespace to produce human-readable output.
   </bool>
   <string name="vendor" proto="23">
     <choice val="NO_VENDOR" proto="0"/>
     <choice val="WEBKIT" proto="1"/>
     <choice val="MOZILLA" proto="2"/>
     <choice val="MICROSOFT" proto="3"/>
     <java-type>Vendor</java-type>
     <java-default>null</java-default>
     <example>../../doc/options/vendor.js</example>
     A vendor-specific version of the result stylesheet will be generated when
     this option is passed with rules that apply only for that browser.
   </string>
   <prop type="!Array<string>" name="excludedClassesFromRenaming" proto="24">
     <java-type>java.util.List</java-type>
     <java-default>new ArrayList()</java-default>
     These classes will not be renamed.
   </prop>
   <!-- other options .... -->
   Options for the stylesheets.
 </record>
</types>
Из листинга выше видно, что я выделил каждую опцию в отдельный тег, вставил их описания, а также ввел значения по-умолчанию для Джавы. Дополнительно, некоторые опции вроде vendor должны быть выбраны из списка готовых значений, поэтому я добавил теги <choice>. Еще можно видеть, что я обозначил proto аттрибьют, который нужен для генерации protobuf файлов (об этом в след части). По своей сути, это самый минимальный XML, в котором описана вся инфа по аргументам, однако теперь мы вовсе не завязаны на использовании аннотации @Option из библиотеки, специализирующейся на CLI аргументах (arg4j), и можем получать опции откуда угодно.
Часть II: генерация
Как только XML файл готов, мы можем удалить все, что связано с опциями, из класса и приступить к генерации кода. Генерация кода в модельном программировании -- это неотъемлемая часть процесса. Для этого нам потребуется шаблон, в котором поставим небольшой коммент // OPTIONS в то место, куда будут генерироваться опции:
package com.google.common.css.compiler.commandline;

import java.util.ArrayList;
import java.util.Set;

import org.kohsuke.args4j.Argument;
import org.kohsuke.args4j.Option;

import com.google.common.css.OutputRenamingMapFormat;
import com.google.common.css.Vendor;
import com.google.common.css.JobDescription.InputOrientation;

class Options {
  // OPTIONS
  /** The rest are input stylesheets. */
  @Argument public List<String> arguments=new ArrayList<String>();
}
Еще нужен интрумент, который я называю "дизайн компилятор", потому что наш XML файл нужно прочитать, составить по нему TOM (type object model, древо вроде DOMа), потом пройтись по ТОМу и трансформировать его. Это ведь получается такой же компилятор с пассами как и все остальные, только работать с ним гораздо легче, потому что мы оперируем высокоуровневыми концептами вроде классов, свойств, методов, аргументов и др.
Я использую самописный компилятор дизайна, который нужен для более продвинутых юз-кейсов, таких как адекватная JSDoc генерация, но для такой простой цели как в нашем сценарии, в принципе подойдет любой XML парсер. Напишем скрипт, который прочитает XML, пройдется по каждому полю из типа Options и выведет его репрезентацию в Java в таком же виде, в котором изначально мы и нашли их:
const registry=createRegistry({},{
 Plugins:{
   'Java':JavaPlugin,
 },
})

registry.readXMLSync('types/design/Options.xml')

const opts=registry.getProtype('tools.exposure.stylesheets.Options')
const TEMPLATE=readFileSync('types/java-options/template.java')+''

let s=''
for(const field of opts.fields) {
 const flag=field.flag?field.flag:field.name.replace(/[A-Z]/g,m=>{
  return`${field.javaOptUnderscore?'_':'-'}${m.toLowerCase()}`
})
if(field.javaComment) {
  s+=field.javaComment.replace(/(^|\n)/g, '$1// ') // dedent
  s+='\n'
}
s+=`@Option(
name="--${flag}",`
if (field.javaAliases.length) {
  s+=`
aliases={${field.javaAliases.map((a) => `"${a}"`).join(',')}},`
}
s+=`
usage="${field.description.replace(/\n/g, '"\n  + " ')}")`
s+=`
protected ${field.javaType} ${field.javaField||field.name}=${field.javaDefault};

`
s=s.replace(/(^|\n)/g,'$1  ').trimRight()
const out=TEMPLATE.replace('// OPTIONS',s)

writeFileSync('src/com/google/common/css/compiler/commandline/Options.java',out)
Скрипт найдет каждую из опций и трансформирует ее в строку, затем соединит все строки воедино и обновит шаблон в месте, где мы оставили // OPTIONS. Такой метод генерации называется пассивным, так как нам нужно использовать шаблон. Это может быть не очень удобно, когда нужно написать какой-то код в самом файле, поэтому стараемся не помещать ничего лишнего в такие сгенерированые файлы.
Вот таким образом мы вернулись к тому, что изначально имели, то есть описанию опций в классе, однако теперь у нас появилось огромное преимущество: единый источник правды в языко-независимом XML. Между делом, аннотации вроде @Option это и есть дизайн, однако он "встроен" в Java файлы и содержит много "шума" вроде самого программирования в классах. Опять же, если вы пишете небольшие программки только на Джава и используете ее как RAD платформу, возможно аннотоаций и достаточно, но когда вы начинаете интегрировать продукт с другими системами, я бы советовал прибегнуть с компилятору дизайна.
После того, как мы регенерировали опции из модели для Java, нужно сделать тоже самое, но для JavaScript. Тут трансформации немного более серьезные, так как содержат JsDoc. Мой движок заточен под JS и смысла приводить весь алгоритм работы не вижу, поэтому я просто покажу результат:

При грамотно-составленном JSDoc'е, пользователи вашей программы получат моментальный доступ к подсказкам при вызове метода. Это работает для других ЯП тоже, например, Python с его PyDoc, главное, чтобы IDE поддерживала. Интересно, что в XML можно добавить примеры через тег <example>, и компилятор дизайна прочитает эти файлы и встроит их в JSDoc. Он также может исполнить JS код, чтобы показать вывод. Но об этом в другой раз. Главное, что у нас теперь есть оболочка для двух систем, Java и JavaScript, и нам нужно совместить их вместе, чем мы и займемся далее.
Часть III: пайпинг
Пайпинг (от слова pipe, труба), это стадия написания программы, когда вам нужно совместить несколько компонентов вместе, чтобы по ним могли свободно течь данные (играли когда-нибудь в игру, где нужно собирать трубы?). В нашем случае, у нас есть сервер на Java и клиент на JavaScript. Как же сделать так, чтобы программа на Java могла спокойно обмениваться данными с клиентами? Ну, тут, наверное, каждый знает, что легче всего поднять REST API и получать какой-нибудь JSON от клиентов и затем парсить его. Однако, это не единственный вариант.
Второй, более инженерный, вариант, это использовать бинарный протокол сериализации вроде Google Protobufs. Так как вся структура данных уже описана и доступны все типы полей, мы можем сделать так, чтобы объект Options из JavaScript был преобразован в двоичный код, то есть вместо прямого {prettyPrint:true}, мы отправим что-то вроде g%1. Одно из преимуществ такого подхода, это более хорошее сжатие (ведь полные имена полей убраны), а так же защита от прослушки наших "труб" кулхацкерами, у которых уже совсем скоро начнутся осенние каникулы: увидев g%1 в сетевых запросах, они просто не поймут, как написать кулсцкрипты, чтобы манипулировать вашей системой не через пользовательский интерфейс.
Генерация протобаф пайпов проходит в два этапа: сначала, мы создадим .proto файлы, используя дизайн компилятор:
syntax = "proto3";

package tools.exposure.stylesheets;
option java_package = "tools.exposure.stylesheets.proto";

message Options {
  // The path to the file where to save compiled output CSS.
  optional string outputFile = 1;

  enum InputOrientationChoices {
    InputOrientation_LTR = 0;
    InputOrientation_RTL = 1;
  }

  // The display orientation of the input stylesheets.
  optional InputOrientationChoices inputOrientation = 2;

  enum OutputOrientationChoices {
    OutputOrientation_NOCHANGE = 0;
    OutputOrientation_LTR = 1;
    OutputOrientation_RTL = 2;
  }

  // ... more options

  // The data for the input map passed directly without reading the file.
  map<string, string> inputRenamingMap = 35;

  // The map containing data about how variables should be renamed.
  map<string, string> varRenameMap = 36;
}
Листинг выше был добыт таким же скриптом, как и когда генерировали опции для Java до этого: просто проходимся по каждой из опций и выводим ее специфическое представления для целевой системы (тут protobuf). Но это еще не все. Сами файлы .protobuf нужно прогнать через protoc, то есть гораздо более серьезный генератор, который выпустит код под Java и JavaScript, сериализирующий / десериализирующий данные (такой код еще называют стабами).
#java
protoc --java_out=target/generated-sources types/proto/compiled/*
--experimental_allow_proto3_optional -I=types/proto/compiled
#js
protoc --js_out=src/js/eco/artd/proto types/proto/compiled/*
--experimental_allow_proto3_optional -I=types/proto/compiled
Нужно помнить, что эти сгенерированные классы поддерживают работу с данными на низком уровне, то есть чтение / запись по битам, и для комфортной, рутинной работы на абстрактном уровне не подходят. Стабы должны быть спрятаны от глаз в папочке target/generated-classes. Еще есть такой концепт как protobuf сервисы, которые поддерживают вызовы методов с стиле RPC, но это тема для другой статьи: в этой мы сами поднимем сервер, сериализуем объект Options из JavaScript, отправим его по сокету Джаве, затем десериализуем его там, выполним программу и вернем результат.
Правда в том, что хоть код и генерируется, можно видеть, как много телодвижений нужно совершить для пайпинга. Поэтому лучший пайпинг -- это тот, который за тебя делает framework. По идее, в хорошем RPC фреймфорке программисту будут предоставлены все прекрасные свойства бинарного формата без какой-либо дополнительной работы. Он/она так же сможет выбрать между форматами, например, заменить protobuf на amf3, или же даже JSON для дебага сетевых запросов. Ведь когда есть модель и инструменты работы с нею, мы можем фокусироваться на более важных вещах, чем бойлерплейт сердеза (serialisation/deseralisation = serdes).
Часть IV: Сервер
Сам сервер сделаем очень простым, я бы не назвал это продакшн вариантом, но для локального сервера сойдет. Из кода убрал неинтересные места, если что-то не выглядит не совсем так, не удивляйтесь.
public class ExposureSocketServer {

 public void startServer(int port) {
   var serverSocket = new ServerSocket(port);
   while (true) {
     Socket s = null;
     System.out.println("Accepting connections on "+ss.getLocalPort());
     s = serverSocket.accept();
     System.out.println("Client has connected:" + s.getPort());

     InputStreamReader isr = new InputStreamReader(s.getInputStream());
     DataOutputStream dout = new DataOutputStream(s.getOutputStream());
     Thread t = new ClientHandler(s, isr, dout);
     t.start();
   }
 }
}
При старте начинаем слушать на заданном порту через while (true), а при запросе создаем новый поток-стейт-машину, который читает все входящие данные:
class ClientHandler extends Thread {
  private String command="COMPILE";
  private ArrayList<String> argsArr = new ArrayList<String>();

  @Override
  public void run() {
   OptionsOuterClass.Options msg = null;

    byte[] binary=this.readBinary();
    if(command.equals("PING")) {
     writeResponse("PONG");

     dout.flush();
     return;
    }

    msg = OptionsOuterClass.Options.parseFrom(binary);

    Return ret = null;
    String[] arrr = {""};
    String[] arr = argsArr.toArray(arrr);

    ExposureStylesheets es = new ExposureStylesheets();
    Options opts = Options.fromMessage(msg);

    ret=es.compileFiles(Arrays.asList(arr),opts);

    System.out.println("Compilation complete!");

    var resultMap = es.makeHashMap(ret);
    writeResponse(resultMap);
    dout.flush();
  }
}
После того, как данные запроса поступили, распарсим их через OptionsOuterClass.Options.parseFrom(msg), который для нас сгенерировал protoc. На данном этапе класс с аннотациями @Option уже не нужен, так как мы расшифровали опции из запроса, однако так как некоторые части программы все еще завязаны на нем, нам потребуется конвертировать стаб OptionsOuterClass.Options, который является по сути просто контейнером данных, в "настоящий" класс Options, с которым уже работает сама программа:
public class Options extends AbstractOptions {
  @SuppressWarnings("incomplete-switch")
  public static Options fromMessage(OptionsOuterClass.Options msg) {
    Options opts = new Options();
    /*  1 */ opts.outputFile = msg.getOutputFile();
    /*  2 */ switch (msg.getInputOrientation()) {
      case InputOrientation_LTR: opts.inputOrientation = InputOrientationChoices.LTR; break;
      case InputOrientation_RTL: opts.inputOrientation = InputOrientationChoices.RTL; break;
    }
    // ...
  }
}
Метод fromMessage выше был сгенерирован дизайн-копилятором: он читает простые поля из OptionsOuterClass.Options протобаф стаба и создает настоящие поля для опций. Такой класс называют wrapper, потому что он обертывает логику сериализации. В нашем примере нету вложенных структур данных, но если бы, например, одно из полей было массивом, элементами которого являлся бы другой тип, наш wrapper должен был бы сначала извлечь стабы из массива, а затем обернуть их в тип самого элемента.
Часть V: Клиент
Клиент написан на Node.js и использует метод connect из пакета net, чтобы инициализировать подключение к серверу и отправить данные.
import {connect, Socket} from 'net'

/**
 * @param {number} port
 * @param {!Array<string>} args
 * @param {!OptionsWrapper|string} optsWrapper
 */
async function sendBySocket(port,args,optsWrapper) {
  let bu = Buffer.alloc(0)
  /** @type {!Socket} */
  const s=await new Promise((r, j)=>{
    try {
      const socket=connect(/** @type {!net.NetConnectOpts}*/ ({
        port:port,
        host:'127.0.0.1',
        'onread':{
          // Reuses a 4KiB Buffer for every read from the socket.
          buffer: Buffer.alloc(4*1024),
          'callback'(nread,buf) {
            bu=Buffer.concat([bu,buf],bu.length+nread)
          },
        },
      }),()=>{
        socket.removeListener('error', errHandler)
        r(socket)
      })
      socket.on('error', j)
    }catch (err) {
      j(err)
    }
  })
  if(args.length) {
    s.write('ARGS\n')
    for(const arg of args) {
      s.write(arg,'utf8')
      s.write('\n')
    }
  }
  s.write('BINARY\n')
  const binary=optsWrapper.toBinary()
  const str=String.fromCharCode.apply(null,binary)
  s.write(str)
  s.write('\n')
  s.write(new Uint8Array([125,125,125]))

  const pr=await new Promise((r, j)=>{
    s.on('close',r)
    s.on('error',j)
  })
  const OBJ=JSON.parse(bu.toString())

  return OBJ
}
Тут видно, что протокол у нас, конечно, немного гибридный: хоть опции и приходят через объект, сами файлы для компиляции оптравляются через сокет как аргументы с новой строки. Данные, которые нужно отправить, должны, конечно, быть в бинарном формате protobuf, поэтому нам нужно их сперва сериализировать:
import {OptionsWrapper} from '../../../../../compile/proto/node'

export default class {
 async ping() {
  const{port:port}=this
  const bu=await getSocket(port,[],'PING')
  let res=bu.toString()
  res=JSON.parse(res)
  if(res!='PONG') {
   // Why waste time say lot word when few word do trick
   throw new Error('Server not pong correct')
  }
 }
 async compileFiles(args,stylesheetsOptions={}) {
  const optsWrapper=OptionsWrapper.fromObject(stylesheetsOptions)

  const bu=await getSocket(this.port,args,optsWrapper)

  const dd=bu.toString()
  if(!dd) throw new Error('No response from the server.')
  const res=JSON.parse(dd)

  return res
 }
}
Для этого нужно импортировать OptionsWrapper и вызвать метод .fromObject. Это создаст Uint8Array, который мы и отправим серверу:

Вроде бы все понятно и очевидно, но тут настал именно тот переломный момент, когда вам следует добавить статью в избранное, потому что то, что я покажу дальше, вы не увидите больше нигде. В интернете буквально нету материалов, которые проделывают этот трюк.
Часть VI: Секретный соус
Дело в том, что для того, чтобы использовать protobuf с JavaScript, нам потребуется google-protobuf рантайм:

Однако это неидеально, поскольку сам рантайм весит 230KB (без компрессии) -- если для Node.js это и неважно, то тащить этого гиганта на фронт это такое. К тому же, гугл при генерации стабов использует свою модульную систему, из-за чего могут вознукнуть проблемы, так как стандартные import/export не поддерживаются. Ну и конечно остается факт того, что protoc сгенерировал stub, а нам еще нужно создать wrapper:

Тут, мы сами пропишем goog.require('proto.tools.exposure.stylesheets.Options') (это стаб), который сделает доступным этот класс в нашем модуле. Затем экспортируем класс через module.exports и соберем при помощи Google Closure Compiler:
java -jar /Volumes/Lab/node_modules/@exposure/compiler/compiler.jar
 --compilation_level ADVANCED  \
 --language_out ECMASCRIPT_2019 \
 --package_json_entry_names module,main \
 --entry_point src/js/options-wrapper.js \
 --module_resolution NODE \
 --hide_warnings_for types/typedefs \
 --js node_modules/google-closure-library/closure/**.js \
 --js src/js/eco/artd/proto/**.js \
 --dependency_mode=PRUNE \
 --js_output_file compile/proto/compile/proto.js
Магический фокус в том, чтобы передать компилятору флаг --js с google-closure-library, часть которой использует пакет google-protobuf. Так как компилятор от гугл умеет делать tree shake (то есть убирать неиспользованный код) в ADVANCED режиме, весь рантайм просто уйдет, оставив нам самый "прожиточный минимум" кода для сериализации:

На выходе получим файл в 18КБ, внутри которого уже встроена бинарная сериализация! Враппер был экспортирован через module.exports, что позволяет встроить его в другие модули через бандлеры. То есть нам совсем не нужно бандлить все 250КБ рантайма для фронта, а на беке мы можем не выставлять google-protobuf как зависимость.
Вот таким интересным образом, работая с полным набором инструментов от Гугл (closure compiler / closure library / protobuf), мы получили бинарную сериализацю на фронте без тяжелого рантайма. Стоит отметить, что процесс компиляции не моментален, и при разработки наверное стоит все-таки использовать рантайм. Как это дело наладить - в след. раз
Интересные статьи
Интересные статьи