Всем привет. В граффических приложениях есть своего рода сердце - этой граффики. Это математика, от того как исполнена математика, зависит общий отклик приложения, есть некоторые подходы, при помощи которых не сразу, но можно войти в начальное понимание, как и что ускорять.
В этой статье хочу показать как я в двое ускорил граффику при помощи математики.
Особенности
Воспользуюсь FreeBSD 14.2-Release, clang15.
если воспользоваться коммандой
find / | grep "immintrin.h"одним из найденных файлов будет
/usr/local/llvm15/lib/clang/15.0.7/include/immintrin.hиз этого файла мне понадобится
#include <xmmintrin.h> //ключевой файл
#include <wmmintrin.h> //
#include <smmintrin.h> //
#include <nmmintrin.h> //
#include <immintrin.h> //общий файл в файле /usr/local/llvm15/lib/clang/15.0.7/include/module.modulemap указаны минимальные ориентиры что где распологается и для каких версий ускорений
буду так же пользоваться калькулятором для отстройки*, так же понадобятся 3 матрицы, над которыми будут производится тесты, 3 вектора, так же будет производится простейший замер времени над матрицами 2 раза - 1 прогон исходный вариант без ускорения, и второй вариант с ускорением по принципу - 1,10,100,1000,10000,100000,1000000
Скрытый текст
#pragma GCC optimize("Ofast,unroll-loops,-ffast-math")
#pragma GCC target("sse")
#include <xmmintrin.h>
#include <wmmintrin.h>
#include <smmintrin.h>
#include <nmmintrin.h>
#include <immintrin.h>
#include <stdio.h>
#include <unistd.h>
#include <time.h>
#include <errno.h>
#include <string.h>
typedef float f32;

struct vec4_t
{
    f32 x;
    f32 y;
    f32 z;
    f32 w;
};
typedef struct vec4_t vec4;

struct mat4_t
{
    f32 v[16];
};
typedef struct mat4_t mat4;

void mulm4VVV(const float *result, const float *a, const float *b)
{
    __m128 row0 = _mm_loadu_ps(&b[0]);
    __m128 row1 = _mm_loadu_ps(&b[4]);
    __m128 row2 = _mm_loadu_ps(&b[8]);
    __m128 row3 = _mm_loadu_ps(&b[12]);

    __m128 newRow0 = _mm_mul_ps(row0,                   _mm_set1_ps(a[0]));
    newRow0 = _mm_add_ps(newRow0, _mm_mul_ps(row1, _mm_set1_ps(a[1])));
    newRow0 = _mm_add_ps(newRow0, _mm_mul_ps(row2, _mm_set1_ps(a[2])));
    newRow0 = _mm_add_ps(newRow0, _mm_mul_ps(row3, _mm_set1_ps(a[3])));

    __m128 newRow1 = _mm_mul_ps(row0,                   _mm_set1_ps(a[4]));
    newRow1 = _mm_add_ps(newRow1, _mm_mul_ps(row1, _mm_set1_ps(a[5])));
    newRow1 = _mm_add_ps(newRow1, _mm_mul_ps(row2, _mm_set1_ps(a[6])));
    newRow1 = _mm_add_ps(newRow1, _mm_mul_ps(row3, _mm_set1_ps(a[7])));

    __m128 newRow2 = _mm_mul_ps(row0,                   _mm_set1_ps(a[8]));
    newRow2 = _mm_add_ps(newRow2, _mm_mul_ps(row1, _mm_set1_ps(a[9])));
    newRow2 = _mm_add_ps(newRow2, _mm_mul_ps(row2, _mm_set1_ps(a[10])));
    newRow2 = _mm_add_ps(newRow2, _mm_mul_ps(row3, _mm_set1_ps(a[11])));

    __m128 newRow3 = _mm_mul_ps(row0,                  _mm_set1_ps(a[12]));
    newRow3 = _mm_add_ps(newRow3, _mm_mul_ps(row1, _mm_set1_ps(a[13])));
    newRow3 = _mm_add_ps(newRow3, _mm_mul_ps(row2, _mm_set1_ps(a[14])));
    newRow3 = _mm_add_ps(newRow3, _mm_mul_ps(row3, _mm_set1_ps(a[15])));

    _mm_storeu_ps(&result[0], newRow0);
    _mm_storeu_ps(&result[4], newRow1);
    _mm_storeu_ps(&result[8], newRow2);
    _mm_storeu_ps(&result[12], newRow3);
}

void DotProduct4VVV(float *a,float *b,float *c)
{
    __m128 a0 = _mm_loadu_ps(&a[0]);
    __m128 b0 = _mm_loadu_ps(&b[0]);

    _mm_storeu_ps(&c[0], _mm_dp_ps(a0,b0,0xFF));
}

mat4 Mulm4(const mat4 a, const mat4 b)
{
    mat4 result;

    result.v[0] = a.v[0] * b.v[0] + a.v[4] * b.v[1] + a.v[8] * b.v[2] + a.v[12] * b.v[3];
    result.v[1] = a.v[1] * b.v[0] + a.v[5] * b.v[1] + a.v[9] * b.v[2] + a.v[13] * b.v[3];
    result.v[2] = a.v[2] * b.v[0] + a.v[6] * b.v[1] + a.v[10] * b.v[2] + a.v[14] * b.v[3];
    result.v[3] = a.v[3] * b.v[0] + a.v[7] * b.v[1] + a.v[11] * b.v[2] + a.v[15] * b.v[3];

    result.v[4] = a.v[0] * b.v[4] + a.v[4] * b.v[5] + a.v[8] * b.v[6] + a.v[12] * b.v[7];
    result.v[5] = a.v[1] * b.v[4] + a.v[5] * b.v[5] + a.v[9] * b.v[6] + a.v[13] * b.v[7];
    result.v[6] = a.v[2] * b.v[4] + a.v[6] * b.v[5] + a.v[10] * b.v[6] + a.v[14] * b.v[7];
    result.v[7] = a.v[3] * b.v[4] + a.v[7] * b.v[5] + a.v[11] * b.v[6] + a.v[15] * b.v[7];

    result.v[8] = a.v[0] * b.v[8] + a.v[4] * b.v[9] + a.v[8] * b.v[10] + a.v[12] * b.v[11];
    result.v[9] = a.v[1] * b.v[8] + a.v[5] * b.v[9] + a.v[9] * b.v[10] + a.v[13] * b.v[11];
    result.v[10] = a.v[2] * b.v[8] + a.v[6] * b.v[9] + a.v[10] * b.v[10] + a.v[14] * b.v[11];
    result.v[11] = a.v[3] * b.v[8] + a.v[7] * b.v[9] + a.v[11] * b.v[10] + a.v[15] * b.v[11];

    result.v[12] = a.v[0] * b.v[12] + a.v[4] * b.v[13] + a.v[8] * b.v[14] + a.v[12] * b.v[15];
    result.v[13] = a.v[1] * b.v[12] + a.v[5] * b.v[13] + a.v[9] * b.v[14] + a.v[13] * b.v[15];
    result.v[14] = a.v[2] * b.v[12] + a.v[6] * b.v[13] + a.v[10] * b.v[14] + a.v[14] * b.v[15];
    result.v[15] = a.v[3] * b.v[12] + a.v[7] * b.v[13] + a.v[11] * b.v[14] + a.v[15] * b.v[15];

    return result;
}

float Dotv4(const vec4 a, const vec4 b)
{
    return a.x * b.x + a.y * b.y + a.z * b.z + a.w * b.w;
}

void stopW(clock_t start)
{
  clock_t end = clock();
  float seconds = (float)(end - start) / CLOCKS_PER_SEC;

  printf("Elapsed: %.12f seconds\n", seconds);
}

int getN()
{
  return rand()%100;
}

void wIntr()
{
  mat4 a=(mat4){
    2,9,40,5,
    8,6,5,6,
    8,9,7,4,
    7,5,3,10
  };

  mat4 b=(mat4){
    50,30,88,70,
    85,100,0,10,
    89,65,50,60,
    99,45,14,80
  };

  mat4 c;
  mulm4VVV(c.v,a.v,b.v);

  printf(
	 "%f %f %f %f \n%f %f %f %f \n%f %f %f %f \n%f %f %f %f \n",
	 c.v[0],  c.v[1],  c.v[2],  c.v[3],
	 c.v[4],  c.v[5],  c.v[6],  c.v[7],
	 c.v[8],  c.v[9],  c.v[10], c.v[11],
	 c.v[12], c.v[13], c.v[14], c.v[15]
	 );
  for(int i=0;i<1;i++)
    {
      c=Mulm4(a,b);

    }
  for(int i=0;i<10;i++)
    {
      mat4 a=(mat4){
	getN(),getN(),getN(),getN(),
	getN(),getN(),getN(),getN(),
	getN(),getN(),getN(),getN(),
	getN(),getN(),getN()
      };

      mat4 b=(mat4){
	getN(),getN(),getN(),getN(),
	getN(),getN(),getN(),getN(),
	getN(),getN(),getN(),getN(),
	getN(),getN(),getN()
      };

      c=Mulm4(a,b);
    }
  for(int i=0;i<100;i++)
    {
      c=Mulm4(a,b);
    }
  for(int i=0;i<1000;i++)
    {
      c=Mulm4(a,b);
    }
  for(int i=0;i<10000;i++)
    {
      c=Mulm4(a,b);
    }
  for(int i=0;i<100000;i++)
    {
      c=Mulm4(a,b);
    }
  for(int i=0;i<1000000;i++)
    {
      c=Mulm4(a,b);
    }
}


void Intr()
{
  mat4 a=(mat4){
    2,9,40,5,
    8,6,5,6,
    8,9,7,4,
    7,5,3,10
  };

  mat4 b=(mat4){
    50,30,88,70,
    85,100,0,10,
    89,65,50,60,
    99,45,14,80
  };

  mat4 c;
  mulm4VVV(&c.v[0],a.v,b.v);

  printf(
	 "%f %f %f %f \n%f %f %f %f \n%f %f %f %f \n%f %f %f %f \n",
	 c.v[0],  c.v[1],  c.v[2],  c.v[3],
	 c.v[4],  c.v[5],  c.v[6],  c.v[7],
	 c.v[8],  c.v[9],  c.v[10], c.v[11],
	 c.v[12], c.v[13], c.v[14], c.v[15]
	 );
  for(int i=0;i<1;i++)
    {
      mulm4VVV(c.v,a.v,b.v);
    }
  for(int i=0;i<10;i++)
    {
      mulm4VVV(c.v,a.v,b.v);
    }
  for(int i=0;i<100;i++)
    {
      mulm4VVV(c.v,a.v,b.v);
    }
  for(int i=0;i<1000;i++)
    {
      mulm4VVV(c.v,a.v,b.v);
    }
  for(int i=0;i<10000;i++)
    {
      mulm4VVV(c.v,a.v,b.v);
    }
  for(int i=0;i<100000;i++)
    {
      mulm4VVV(c.v,a.v,b.v);
    }
  for(int i=0;i<1000000;i++)
    {
      mulm4VVV(c.v,a.v,b.v);
    }
}


int main()
{
  struct timespec Ta,Tb;

  float GlobalTime=0;
  float localTime=0;

  clock_gettime(CLOCK_MONOTONIC,&Ta);
  wIntr();
  clock_gettime(CLOCK_MONOTONIC,&Tb);
  localTime=(double) (Tb.tv_nsec - Ta.tv_nsec) / 1000000 +
            (double) (Tb.tv_sec - Ta.tv_sec);

  printf("%f\n",localTime);

  clock_gettime(CLOCK_MONOTONIC,&Ta);
  Intr();
  clock_gettime(CLOCK_MONOTONIC,&Tb);
  localTime=(double) (Tb.tv_nsec - Ta.tv_nsec) / 1000000 +
            (double) (Tb.tv_sec - Ta.tv_sec);

  printf("%f\n",localTime);

  vec4 ACC={9,2,7,0};
  vec4 BCC={4,8,10,0};
  vec4 CCC;

  DotProduct4VVV((float*)&ACC,(float*)&BCC,(float*)&CCC);
  printf("%f \n",CCC.x);
  return 0;
}

Более точную информацию с описанием функций можно найти в выше приведенных файлах.
при помощи mmloadu_ps = происходит инициализация регистра
при помощи mmstoreu_ps = происходит запись результата в переменную
при помощи mmset1_ps = установка значением
при помощи mmadd_ps = сложение
при помощи mmmul_ps = перемножение
при помощи mmdp_ps = происходит dotProduct
регистры 128 битные [4xfloat]
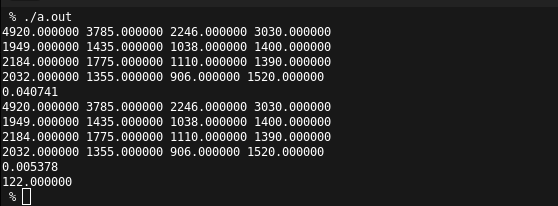
как видим прирост почти в 10 раз
Ресурсы
*https://www.mathsisfun.com/algebra/vectors-dot-product.html https://www.mathsisfun.com/algebra/matrix-calculator.html
**https://en.wikipedia.org/wiki/Single_instruction,_multiple_data
http://www.club155.ru/x86cmdsimd/MOVUPS