Мы получили больше 250 тестовых на 25 мест в первую Школу аналитиков hh. Многие решения были сделаны с нейросетью, и это нормально — аналитики в работе тоже пользуются LLM-инструментами. Вопрос был в другом: как за аккуратным текстом от LLM разглядеть кандидата с пониманием того, что он делает.
Я — Валя Борисов, тимлид команды аналитики Trust&Safety в hh.ru, и параллельно организатор процесса отбора в Школу аналитиков. По долгу основной работы стараюсь сделать так, чтобы все стороны найма обладали достоверной информацией друг о друге. Тестовое в эру нейрослопа ставит ту же задачу: понять, стоит ли за красивым результатом сам человек.
Для начала немного контекста. В сентябре 2026 года hh запустил первую Школу аналитиков. Основная цель — обучить ребят-студентов, которые заряжены получить практический опыт в аналитике, а потом взять их на стажировки в команды. Концепция школ для нас не новая: на данный момент прошло 3 Школы продактов и 16(!!!) Школ программистов. Школу программистов прошло более 375 человек, из которых 110+ попали в технический департамент hh.
Общая рамка отбора
Перед любым отбором возникает вопрос, а кого мы вообще хотим видеть как целевого студента школы? В Школе аналитиков мы делаем акцент на практических навыках. Поэтому фокус хотелось сделать на ребятах, кто умеет интерпретировать данные и давать применимые к жизни рекомендации. Это приводит к первой проблеме — уход от рамки академических задач усложняет проверку и повышает уязвимость к нейрослопу.
Рядом есть вторая проблема — «аналитика данных» ещё не прижилась как полноценная дисциплина в большинстве университетских программ. Python, SQL, Matlab, R, Excel - все владеют разным инструментарием. Мы решили, что лучший вариант — не требовать знание конкретных языков, а дать выбрать самый удобный вариант. Спойлер: 85+% всё равно выбрали Python)
Практические проблемы
Окей, нам нужны практико-ориентированные задачи, которые не привязаны к конкретному ЯП и доступны студентам разных курсов. А как сделать задачи, которые позволят ранжировать кандидатов по уровню? В эпоху ИИ-агентов стопроцентный слоп в тестовом может выглядеть убедительнее реального решения. С другой стороны, использование современных инструментов позволяет быстрее и эффективнее делать работу, поэтому штрафовать за сам факт использования нецелесообразно. Хотелось придумать задачи, где максимальный балл получат работы, рождённые из кооперации с LLM-кой.
Слоп для нас — это когда кандидат берёт ответ модели как есть, не проверяя и не понимая, что там написано. Чтобы отделить разумное использование моделей от слопа, в задачи добавили несколько «ловушек», которые должны показать использование ИИ без достаточной валидации. Например, избыточно сложные вопросы или просьба написать комментарий. Причем ловушки были двух типов:
«Штрафные» стоили баллов — грязь в данных, рекомендация без учёта контекста задачи и т.п.
«Сигнальные» (те самые сложные вопросы и комментарий) на балл не влияли, а просто помогали отловить работы, которым надо уделить больше внимания на ручной проверке и интервью.
Ещё один челлендж — оптимизация ресурсов на отбор. Детальная ручная проверка самый точный вариант, но при потоке из 250+ сданных тестовых на это уйдёт 100+ человеко-часов сотрудников. К тому же нам не обязательно иметь точное ранжирование кандидатов, достаточно классифицировать на прошедших порог и нет. Для этой цели отлично подошли передовые ИИ-модели с автоматизированной проверкой по машинно-адаптированным маркингам и выборочным контролем со стороны проверяющего. Но об этом чуть позже)
В финальной итерации решили остановиться на двух задачах:
Анализ датасета
Теория вероятностей и статистика — критический разбор поста в соцсети
Каждая задача делилась на четыре смысловых блока:
Посчитать
Найти подвох в распределении или в логике
Интерпретировать
Дать рекомендацию
Давайте разберём подробнее задачи, подходы к решению и слоп-ловушки.
Задача 1. Анализ датасета с зарплатами
Условие задачи 1: анализ зарплат
Вася — студент последнего курса, уже имеет год опыта работы продуктовым аналитиком, но планирует менять место работы. Прежде чем рассылать резюме, он хочет разобраться в рынке: понять, как зарплаты зависят от опыта, насколько они предсказуемы и на что вообще ему рассчитывать.
Вася выгрузил с hh.ru 100000 вакансий аналитика данных и просит тебя помочь ему разобраться в этих данных.
Датасет: vacancies.csv, 100000 строк.
Колонка | Тип | Описание |
|---|---|---|
| int | Идентификатор вакансии |
| float | Нижняя граница зарплатной вилки, ₽ (может отсутствовать) |
| float | Верхняя граница зарплатной вилки, ₽ (может отсутствовать) |
| str | Требуемый опыт: Нет опыта / От 1 года до 3 лет / От 3 до 6 лет / Более 6 лет |
| str | Город вакансии |
| str | Тип занятости: Полная занятость / Частичная занятость / Стажировка / Удалённая работа |
Зарплата может быть указана как полной вилкой (salary_from и salary_to), так и одной границей, либо отсутствовать. Как корректно работать с этим — твоё методологическое решение, опиши его в ответе. Так как Вася выгружал всё самостоятельно, он не ручается, что нет ошибок парсинга.
Блок A. Технический
A1. Посчитай основные описательные статистики зарплат отдельно по каждому уровню опыта: среднее, медиану, стандартное отклонение, 25-й и 75-й перцентили. Представь результат в виде таблицы.
A2. Сравни значения среднего и медианы внутри каждой группы. Что ты замечаешь? Опиши наблюдение в одном-двух предложениях.
A3. Построй гистограммы распределения зарплат для каждого уровня опыта. Размести их так, чтобы группы можно было визуально сопоставить друг с другом.
Блок B. Аналитический
B1. Посчитай коэффициент асимметрии (skewness) для распределения зарплат в каждой группе опыта. В каких группах распределение скошено сильнее всего? В какую сторону? Чем это может объясняться?
B2. Объясни, почему в результатах из A2 среднее и медиана расходятся именно таким образом. Как это расхождение связано со скошенностью, которую ты посчитал в B1?
B3. В какой группе разброс зарплат наибольший? Посчитай его, используя нужные метрики. Что это означает для кандидата, который хочет предсказать свою будущую зарплату, ориентируясь на эти данные?
Блок C. Интерпретация
C1. Какую метрику (среднее, медиану или может что-то третье) правильнее использовать для описания «типичной» зарплаты в каждой группе? Обоснуй выбор, опираясь на форму распределения, которую ты обнаружил в блоках A и B.
C2. Вася нашёл в интернете статью, где написано: «средняя зарплата аналитика данных с опытом 1–3 года — N рублей». Должен ли он доверять этой цифре? Какие методологические оговорки стоит сделать?
C3. Можно ли по имеющимся данным утверждать, что зарплаты аналитиков с опытом «От 3 до 6 лет» значимо выше, чем у аналитиков с опытом «От 1 года до 3 лет»? Если да, то на каком основании. Если нет, то каких данных или инструментов не хватает, чтобы ответить на этот вопрос строго?
Блок D. Рекомендация
D1. Вася собирается на собеседование и хочет назвать «среднюю зарплату по рынку» при обсуждении оффера. Какую именно цифру ему использовать и как её корректно интерпретировать с учётом того, что ты узнал о форме распределения зарплат? Дай конкретную рекомендацию и обоснуй её.
D2. Глядя на разброс зарплат внутри грейдов: насколько предсказуема зарплата Васи, если он выйдет на рынок прямо сейчас? Где неопределённость выше, где ниже? Что это означает для его стратегии поиска работы?
D3. Сформулируй 2–3 конкретных вывода для Васи в виде коротких тезисов: что ему делать с этой аналитикой на практике.
Блок A
Датасет был синтетическим, и в него зашили некоторые аномалии:
перевёрнутые вилки
нереалистичные зарплаты
строки без зарплат
бимодальность в группах и тп
Полностью справились с очисткой и описанием методологии всего 13% кандидатов.
Кажется, что передовые нейросети должны хорошо справляться с этой задачей, но делают они это с характерными слоп-паттернами: нереалистичные зарплаты нормируют (делят на 100 или умножают на 100), перевернутые вилки переворачивают без дополнительных комментариев, методологически безупречно чистят выбросы без привязки к бизнес-смыслу.
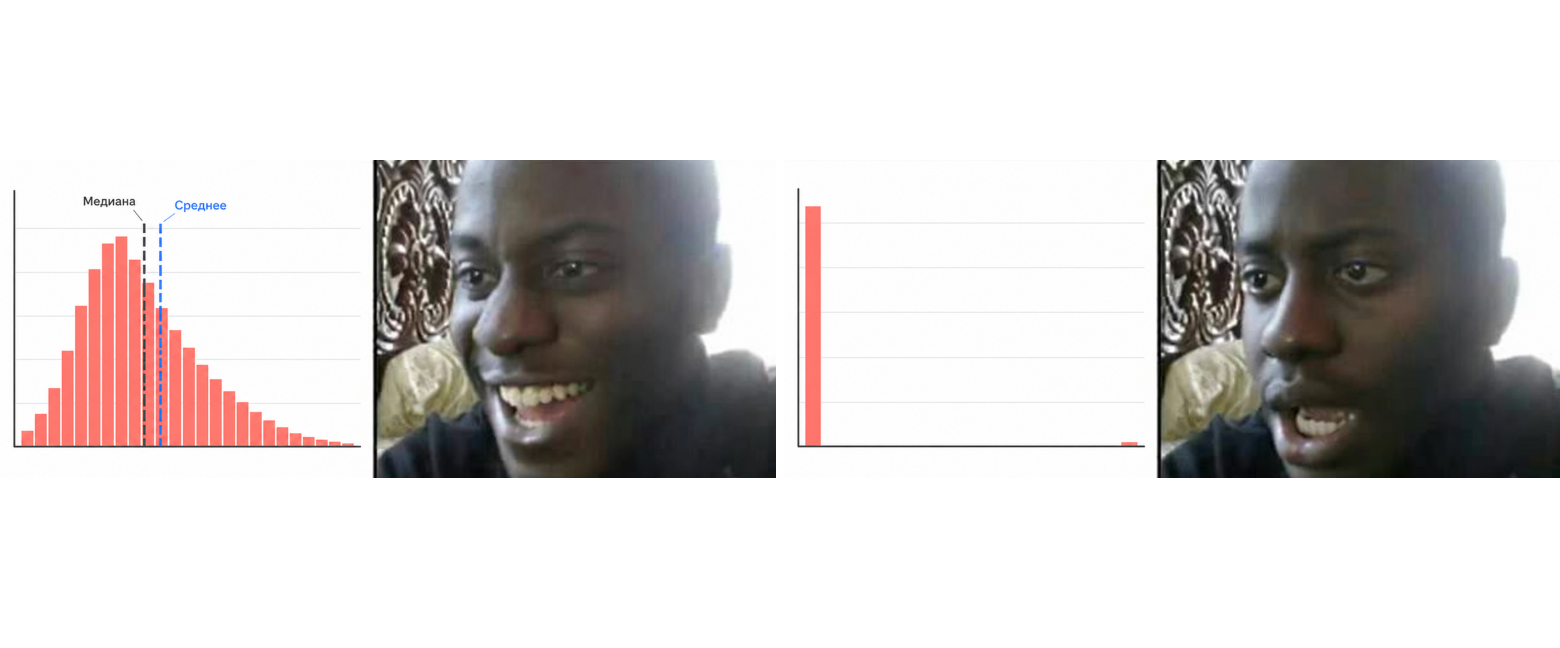
Машинно-сделанные гистограммы зачастую имели нулевую интерпретируемость. При некорректно выбранном способе очистки столбики схлопывались или группа с выбросами перекрывала все остальные.
Блок B
Блок начинается с расчёта skewness. Как показала практика, большинство кандидатов не знали, что это, и ожидалось, что они (возможно, при помощи нейросетей) узнают, что это. На этапе проверки тестового это невозможно оценить, но на этапе интервью понимание скошенности было одним из основных детекторов слопа.
Сильные кандидаты рассуждали про то, что в ИТ группа 1-3 года самая нестабильная по зарплатам из-за так называемых «скрытых мидлов». Это люди с небольшим опытом, которые быстро прогрессируют и начинают быстро получать мидловскую зарплату. Но помимо этого есть и фактор географии: в крупных городах зарплаты могут быть выше, чем в регионах, что тоже влияет на скошенность и форму распределения в целом.
Блок C
В C1 большинство кандидатов корректно решили использовать медиану в качестве основной метрики для сравнения зарплат. Особо сильные работы рассуждали про то, что медиану надо считать в рамках своего города или учитывать свой потенциал. Если Вася чувствует, что обладает хардами и софтами выше среднего, можно целиться в более высокий перцентиль по уровню зарплаты.
C3 — основная слоп-ловушка секции. Для ИИ очевидно, что надо проводить статистический тест, и цепочка рассуждений у него типовая: основная метрика — медиана, значит нужна непараметрика, значит тест Манна-Уитни. Кстати, строго говоря, медианы этот тест не сравнивает, он проверяет сдвиг распределений, и это отличный вопрос на защиту. Чтобы студент самостоятельно пришёл к такой идее и осознанно провёл его, надо понимать большую пачку побочных теоретических вопросов: что такое p-value, чем параметрический тест отличается от непараметрического, предпосылки каждого теста, ЦПТ и т.д.
Повторюсь, что нет ничего плохого, если работа делается при помощи LLM — плохо, когда используются методы, про которые кандидат вообще ничего не понимает. Официальный маркинг вообще не обязывал проводить тест Манна-Уитни, равно как и любой другой статтест.
Блок D
Любые рекомендации — самая сложная часть для LLM-моделей. Они начинают фиксироваться на цифрах и не учитывают общий контекст задачи: что Вася студент, но с опытом работы (где?), его мотивацию, формат занятости, университет и программу и т.п.
Отдельным кандидатам без LLM это тоже свойственно, но там хотя бы удаётся избежать явно нереалистичных вариантов. Итог в цифрах: полный балл за рекомендацию получили всего 6% кандидатов — меньше, чем за любой другой пункт задачи.
Задача 2. Критический разбор поста в соцсети
Условие задачи 2: пост коуча в соцсети
Вова — студент последнего курса прикладной математики, готовится искать первую работу в ИТ и хочет подойти к этому осознанно. Перед тем как откликаться на hh.ru, он решил собрать информацию о рынке и наткнулся в соцсети на пост карьерного коуча с эффектными статистиками о поиске работы.
Вова собирается использовать этот пост как основу для своей стратегии откликов, но он умный парень и хочет сначала разобраться, насколько утверждениям из поста вообще можно доверять.
Твоя задача: помочь Вове критически разобрать пост и построить адекватную стратегию.
Пост в соцсети
Интересные статьи
Интересные статьи