Привет! Меня зовут Кирилл Трибунский, я ведущий разработчик отдела архитектуры и разработки “Северсталь Диджитал”. Сегодня я расскажу про нашу библиотеку Typed Blocks, задача которой — снизить порог входа в разработку с машинным обучением и избавить дата-сайентистов от рутины при переносе проектов в продуктив. Библиотека появилась на свет, как водится, через боль команд «Северсталь Диджитал» от решения однотипных задач при выводе кода в продакшен. Она позволяет разбивать код на независимые блоки и вести однотипную разработку вне зависимости от типа используемого транспорта. Статья, как и сама Typed Blocks, будет интересна дата-сайентистам, которые не хотят много кодить. А также программистам, неравнодушным к опциональной статической типизации в Python, которую вовсю использует Typed Blocks. Автор идеи и создатель библиотеки — Даниил Зубакин, за что ему большое спасибо!
Как типичные CV-модели триггернули команду разработки на создание библиотеки Typed Blocks
В ML-разработке «Северсталь Диджитал» можно выделить две большие среды: исследовательскую, в которой работают дата-сайентисты (DS) и среду разработки, где работают программисты.
В исследовательской среде DS проверяют гипотезы, занимаются экспериментом и прототипированием. Они вдумчиво и последовательно работают с холодными данными «один на один» и мало вникают в будущую архитектуру решения, в то, как приходят потоковые данные, как разделять ответственность в коде. Ведь гипотезы могут не подтвердиться, и тогда проект «не сложится». Для решения прикладной задачи с применением ML-алгоритмов DS сами пишут код: это может происходить на любом железе компании от рабочего ноутбука до мощного сервера с топовой GPU. Часто код невозможно сразу перенести в продакшен. В Jupyter-ноутбуке можно разбить код на куски, выполнить их в произвольном порядке и сразу видеть результат выполнения таких фрагментов. В такой среде разработки прототип выглядит как набор разрозненных шагов по подготовке и обработке данных с анализом метрик качества алгоритмов, которые интересуют аналитиков. Чтобы запустить работающий код в продуктив может потребоваться связывание разных его частей между собой, а также смена источника данных (например, с холодного хранилища на стрим) и даже рефакторинг.
Связыванием кода вручную занималась команда разработки, поскольку у этих специалистов в силу их ежедневных профессиональных задач есть более глубокое понимание того, как должна работать система в динамике и как выводить код на прод. Программисты также занимались переключением на подготовленные data-инженерами источники данных, анализом возможных проблем с данными, наполнением данными модели машинного обучения. Такой способ работы плохо масштабировался — команда разработки становилась бутылочным горлышком в той стадии решения на пути к пилотированию, когда прототип был готов и проект решали запускать. Связывающий код (так называемые обёртки) писали сначала для простых рекомендательных моделей машинного обучения, затем для более сложных управляющих моделей с различными требованиями. Рутина с обёртками отнимала много времени, и расстраивала жаждущих сложных задач коллег.
Очередной проект с компьютерным зрением стал триггерным. Дело в том, что в нашем случае специфика CV-моделей заключалась в однотипности потока обработки данных. Во всех моделях был довольно прямолинейный пайплайн: есть картинка на вход, инференс, возможно постобработка — вот и всё. Именно здесь появилось непреодолимое желание автоматизировать рутину и было разработано простое решение по шаблонизации CV-моделей в виде фреймворка. Так, стоп. А чего бы это нам не сделать на его основе решение для обработки любых типов данных?
Первая версия библиотеки называлась Typed Reactors, поскольку всё строилось вокруг обработчиков, реагирующих на определенные события. В процессе создания команда разработки активно накидывала критику и корнер-кейсы с идеями «когда это не заработает». Чтобы не завязнуть в переборе вариантов реализации и поисках идеального и всеобъемлющего общего решения, сконцентрировались на выпуске MVP. Вначале попробовали пописать на нём сами, потом отдали дата-сайентистам, которые стали давать фидбэк и запрашивать новые фичи. Постепенно минималистичный движок обзавёлся несколькими коннекторами и готовыми обработчиками.
Так из CV-фреймворка выкристаллизовалась универсальная ML-библиотека, которая сейчас позволяет снизить издержки на изменение кода перед его переносом в продукционное окружение.
Почему мы не использовали готовые сервисы для ML-разработки
Да, похожие задачи решают DataSphere (Яндекс) и Акведук (Авито). Облачный DataSphere мы не использовали, так как у нас полностью своя инфраструктура. Некоторые решения управляют реальными агрегатами на производстве, а значит важна повышенная безопасность. У Акведука фокус на утилизации ресурсов, а не на DEV-экспириенсе. Есть еще фреймворки типа Event Sourcing, но для начинающего DS он сложен, ведь приходится сталкиваться с весьма забористым DSL.
Нам же нужна была простая, как палка, недорогая альтернатива, не требующая погружения и применения специальных знаний. Нам не удалось найти готовый оптимальный для себя инструмент и мы решили его сделать. Однако, тенденция (читайте, как мы делали MES, оптимизатор, платформу для управления VR-симуляциями).
Функциональность и преимущества Typed Blocks
Минималистичная в своём корне Python-библиотека Typed Blocks упрощает и унифицирует чтение данных из разных источников, их обработку и запись. В нашем окружении в основном используется при потоковой обработке данных, но может работать и с батчами. Основу библиотеки составляет обработчик, который выводит граф вычислений на основании аннотаций типов. Он довольно простой и хорош тем, что DS нет необходимости разбираться в нём — достаточно лишь понимать, какие данные должны быть представлены в программе и пользоваться готовыми коннекторами к брокерам сообщений (Kafka, Redis Streams и потенциально любые другие) или СУБД.

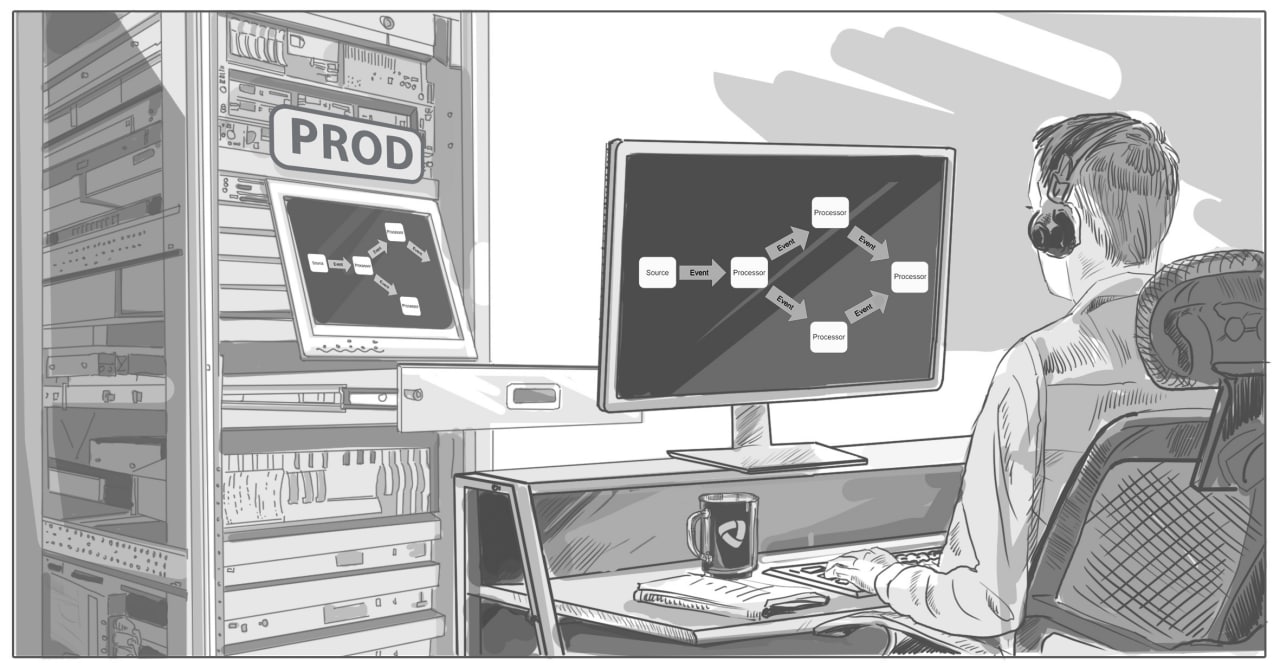
Typed Blocks представляет собой небольшую event-driven систему, построенную на концепции CEP (Complex Event Processing, обработка сложных событий). На основе типа ивента мы можем творить любую магию через селектор, в котором прописаны варианты действий. Именно этот подход позволил нам перейти от узкой функциональности CV-моделей к универсальным вычислениям, определяемым типовыми аннотациями. Программа напоминает машину Тьюринга: вместо бесконечной ленты — постоянно обновляемая очередь событий; вместо таблицы состояний — описание в виде событий процессоров, их входов и выходов.
Работает она так: при запуске программы собирается граф вычислений, соединяющий между собой источники событий и процессоры, которые эти события обрабатывают. Источником может быть что угодно — очередь сообщений, база данных, видеопоток, таймер. Как результат своей работы процессоры могут порождать новые события. Далее источники опрашиваются на предмет новых событий, которые затем кладутся во внутреннюю очередь, и для каждого события вызываются соответствующие ему процессоры для обработки. Весь код композируется на отдельные функции и поощряет думать о том, где и какие данные нужно передать, какие сущности есть в задаче. Сам связывающий код писать не надо. Если на этапе исследования код сразу пишется с оглядкой на типы данных, перенос кода в продукционное окружение получается практически бесшовным.

Хотя источники и процессоры похожи, они всё-таки явно разделены. Это позволяет легко подменять или имитировать источники или изолировать некоторые эффекты (например, запись во внешнюю систему). Явное выделение типов событий и обособленная их обработка позволяет создавать слабосвязанный код, с которым проще работать: если функционал или вычисления локальны, то и изменения вносить легче. Да, при желании можно всё написать в одном процессоре — будет, как обычно. Плюс абстрагированный граф вычислений позволяет вам писать коннекторы под потребности. За счет использования графа, состоящего из обособленных блоков, Typed Blocks помогает структурировать код прямо в процессе его написания. Благодаря этому, использование фреймворка ускоряет разработку продуктивных приложений.
Как еще можно использовать библиотеку в машинном обучении
Данные, подаваемые на вход Typed Blocks, могут быть любыми, поэтому библиотеку можно использовать при создании разнообразных проектов на Python как сотрудникам корпораций, так и индивидуальным исследователям в области машинного обучения и компьютерного зрения.
Если дата-сайентисту не нужны конкретные данные из внешних источников, он может просто поиграться с графом. Например, так наши DS создавали тестовые видеопотоки: брали файл mp4, читали его FFmpeg-ом, а потом загоняли в модель машинного обучения для компьютерного зрения. Кроме того, мы запускали данные из таблицы, которую взяли в Spark. Или можно построить свои потоки данных просто на файлах.
В реальной работе над несколькими продуктовыми решениями «Северстали» мы использовали библиотеку в ML-проекте для управления парком воздушных компрессоров и в системе видеоинспекции полосы для распознавания дефектов готовой металлопродукции. Typed Blocks упрощает работу с входными и выходными данными, что помогает подключать сотрудников к проекту быстро и без сложностей, снижая порог входа.
Преимущества библиотеки Typed Blocks:
абстрагированный граф вычислений;
удобство написания слабосвязанного кода;
единообразная работа как с потоковыми данными, так и с батчами;
минимальный порог входа;
единообразие кодовой базы;
возможность быстро перенести проект в прод.
Какие проблемы «Северсталь Диджитал» помогла решить Typed Blocks
Основной нашей проблемой был медленный запуск цифровых решений на основе анализа больших данных. Этому способствовала дистанция между этапом исследования и этапом проведения пилота. Причиной дистанции являлась не автоматизированная рутина при выводе кода в промышленную эксплуатацию, а также в отличиях источников исторических данных от потоковых. Typed Blocks позволяет быстрее создавать и запускать проекты, связанные с обработкой данных и даже сместить продуктовую разработку «влево» — ближе к аналитику и данным, с которыми он хорошо знаком.
В проектах «Северстали» Typed Blocks упрощает и унифицирует чтение данных из разных источников (Kafka, Redis Streams) и их запись. За счет использования графа, состоящего из обособленных блоков, Typed Blocks помогает структурировать код прямо в процессе его написания. Новый блок можно добавлять с минимальными изменениями в исходной структуре.
Стоит отдельно отметить, что инфраструктура для моделей наших ML-проектов находится в кластере K8s. Процессы CI/CD в Kubernetes организованы довольно единообразно. Постоянно копятся исторические данные и, несмотря на отличия в «динамике», по структуре они похожи на потоковые, на которых часто и работают наши программисты и DS. При таких вводных выигрыш от применения Typed Blocks стал существенным. Мы не будем утверждать, что он окажется таковым в менее гомогенных окружениях.
Библиотека Typed Blocks позволила:
Снизить издержки на изменение кода перед его переносом в продукционное окружение. Это хорошо подходит для прототипирования и проверки гипотез на реальном контуре.
Сократить time-to-market. В предельном случае с использованием Typed Blocks дата-сайентист даже без большого опыта программирования может перенести код со своего ноута в продакшен почти со скоростью копи-пасты.
Снизить порог входа в разработку soft-realtime-приложений по сравнению с традиционным развертыванием машинного обучения. С Typed Blocks вы можете брать абсолютно любые исходные данные и быстро выводить в пилот и в прод решения, основанные на их анализе.
Параллельно писать алгоритмы-процессоры для одной задачи, собирая их затем в нужной последовательности. Имея существующие процессоры и добавляя новые, можно собирать приложение, как конструктор.
Самостоятельно разрабатывать и выкатывать модели end-to-end дата-сайентистам. Благодаря тому, что владение кодом не теряется, граница ответственности в разработке обёртки и модели стала менее спорной, что повышает качество кода. Более того, DS теперь глубже погружены в доменную область и лучше видят пути для совершенствования и доработки продукта.
Бонусом у нас получился «великий уравнитель» с точки зрения написания кода.
Поддерживая тренд на развитие культуры обмена кодом мы выложили библиотеку в Open Source. Мы хотим, чтобы наша библиотека стала повседневным инструментом дата-сайентистов и разработчиков — как в крупных компаниях, так и в персональном использовании. Будем рады, если вы попробуете поработать с ней и поделитесь впечатлениями.