Считается, что G2/G3 (Arc Fitting on Orca) заставляет слабый MCU самостоятельно аппроксимировать дугу, следовательно, на 8-битном AVR arc fitting может оказаться медленнее заранее нарезанного G1.
А вот и проверим.
Откуда возник вопрос. Есть распространённое соображение: G2/G3 экономит G-code, но заставляет слабый AVR самому считать аппроксимацию дуги. Значит, Arc fitting может оказаться вреден на 8-битном контроллере. Звучит правдоподобно — но насколько это заметно на практике?
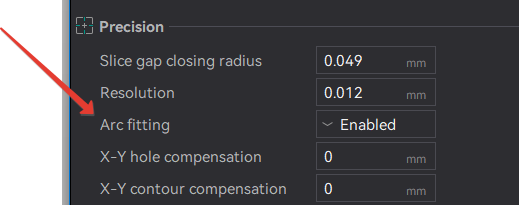
Опция активации в Orca Slicer Что будем проверять. Не загрузку CPU как таковую, а конечный результат всей цепочки: чтение команды → parser → arc interpolation → planner → stepper. Это важно, потому что именно такую производительность видит пользователь.
Испытуемый — заведомо неблагоприятный случай. ATmega1284P, 16 МГц, Marlin 2.1.x, причём не голый, а активировано почти все на нем возможное S-curve, Linear Advance, JD, в том числе и полезнейший : ZV Input Shaping (позволяющий в полтора раза увеличить скорость печати при сохранении качества). То есть если где и ждать проблем от вычисления G2/G3, то как раз, типа, тут и самое место.
Первый эксперимент — самое главное сравнение. Исследование прошивки Марлина показало, что при использовании арок он аппроксимирует их участками ~1.75мм, поэтому мы сгенерировали тестовый g-code так, чтобы на ислледованой окружности диаметром 40 мм варианты с G2/G3 и G1 дали 432 реально выполненных planner blocks. И тут же появляется первый интересный результат:
G1 — 9,328 с; G2 — 7,648 с.
То есть при одинаковом количестве итоговых блоков G1 оказался примерно на 22% медленнее.
Теперь начинаем дробить G1, уменьшая отрезки. 5 → 1 → 0,5 → 0,2 → 0,1 мм. При внешнем разбиении на 0.5-0.1 мм дуговые команды (G2) выполняли круги примерно в 2.2-6.8 раза быстрее с SD,сохраняя плавный ход. В то время как G1 выполнялись с замираниями и ощутимыми ударными нагрузками от перемещаемых масс стола и головки.
А что будет через UART на 250 000 бод? И тут эффект становится совсем наглядным: 7542 команды G1 занимают 70,029 с, шесть G2 — 7,656 с. Выйгрыш от арок почти 10-ти кратный! При этом, поток обмена с G1 переполнялся ошибками и повторами передачи, занятый работами CPU не успевал своевременно забрать из UART поступивший байт, контрольки команд не совпадали и требовался resend, что выливалось в значительные замирания и удары. Приходилось снижать скорость обмена, что уменьшало рывки, но опять же, за счет увеличения времени печати. В то время как при использовании G2, окружность описывалась плавно и за один раз.
Почему получилось именно так. Вот здесь уже объясняем главное заблуждение:
G-code command ≠ planner block.
Marlin действительно должен сам сегментировать G2/G3. Но компактная команда одновременно убирает огромное количество операций чтения G-code, разбора ASCII, dispatch команд, обмена ACK при UART и т. д. Эксперимент показывает суммарный результат этих противоположных факторов при печати, а не то, что вычисление дуги само по себе дешевле.
Полный отчет по условиям и результатам эксперимента можно взять тут на русским и тут на английском. Отчеты также направлены разработчикам Orca slicer wiki для рассмотрения и пересмотра, ничем не подтвержденного утверждения, что Arc Fitting на 8-bit CPU - "зло" :)