Сегментирование в стиле Hive применяется для оптимизации физического диска и более качественной компоновки данных, о чём подробнее рассказано в статье Organizing Data: Partition by Disk to Hive-style Partitioning. Но при работе с облачными объектными хранилищами сегментирование — не лучшая стратегия, и нам следует переосмыслить наш подход к организации данных. В этой статье обсудим, как путём пропуска данных (data skipping) и использования Z-порядка сократить объём тех данных, которые приходится просматривать. В результате можно значительно повысить производительность при обработке запросов и удешевить эти операции за счёт использования приёмов кластеризации.
Повышение производительности путём пропуска данных
Традиционно при запрашивании информации из озера данных движок запросов сначала выстраивает список релевантных файлов, а затем запрашивает их. В таких облачных объектных хранилищах как S3 подобное действие listFrom получается очень ресурсозатратным. Когда данные хранятся в форматах из категории «lakehouse», например, Delta Lake, удаётся совместить наилучшие черты озёр данных и хранилищ данных. Обеспечивается высокая надёжность данных, как в хранилище, и соответствие набору ACID, тогда как гибкость и масштабируемость при работе такая, как будто мы работаем с озером данных. В Delta Lake этого удаётся добиться благодаря использованию журнала транзакций, как показано на следующей схеме. Здесь клиент rust-lang запрашивает таблицу Delta.
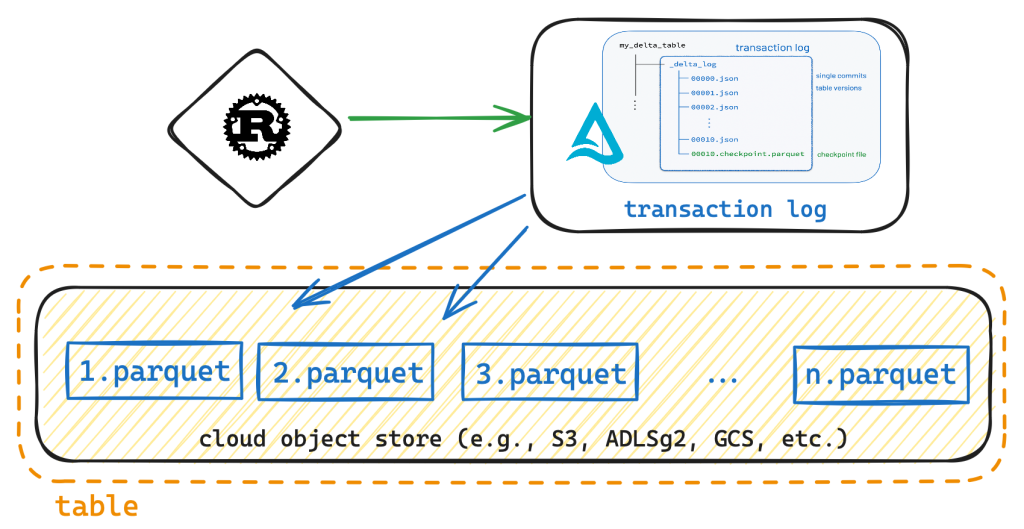
Delta Lake предоставляет движок для работы с запросами (напр., Rust Lang содержащийся в пакете delta-rs), прописывая точные пути к тем файлам, которые слагают таблицу. Следовательно, при работе с Delta Lake удаётся в значительной степени устранить проблемы с производительностью, возникающие при листинге файлов (напр., listFrom).
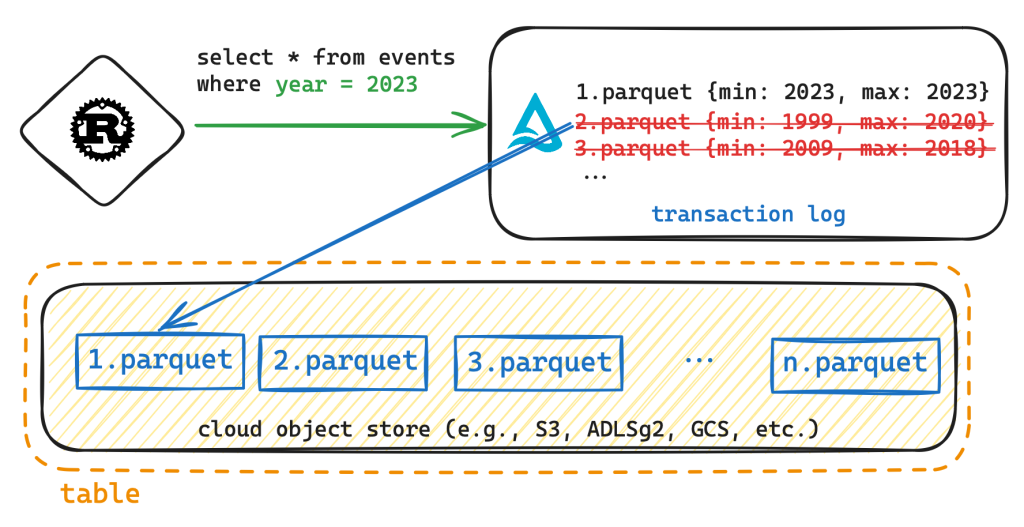
Обсудим, как Delta повышает производительность запросов путём пропуска данных, опираясь на статистику столбцов (минимальные и максимальные значения), сохранённую в журнале Delta. Например, движок запросов отсеет через фильтр все файлы данных, не относящиеся к 2023 году (*.parquet), исходя из максимальных и минимальных значений в журнале транзакций. Следовательно, пропуская данные таким образом, движок будет читать меньше информации, а значит — работать быстрее.
Свёртка многомерных точек до одномерных значений
Пропуск данных получается ещё эффективнее, если кластеризовать данные так, чтобы диапазоны значений min-max получались узкими и не пересекались. Например, вот какова структура файла данных, показанного на предыдущей картинке.
# Конфигурация кластеров в предыдущем файле
1.parquet {min: 2023, max: 2023}
2.parquet {min: 1999, max: 2020}
3.parquet {min: 2009, max: 2018}
Если в данном примере мы запросим данные за 2010 год, то нам потребуется прочитать как 2.parquet, так и 3.parquet. Напротив, было бы более оправданно выполнить конфигурацию по следующему принципу.
# Оптимальная конфигурация кластеров данных по годам
1.parquet {min: 2019, max: 2023}
2.parquet {min: 2014, max: 2018}
3.parquet {min: 2009, max: 2013}
Этот упрощённый пример отлично работает с одним столбцом. Но всё значительно усложняется, когда требуется выполнить кластеризацию по множеству столбцов. Такая проблема распространена при работе с реляционными базами данных, когда мы пытаемся присваивать одному файлу множество значений из столбцов, по которым обычно запрашиваются/фильтруются/группируются данные. С математической точки зрения мы хотим сохранить локальность данных, отображая многомерные точки на одномерные данные. Следовательно, хотим использовать поддерживающие такую локальность кривые Пеано. Наиболее распространенными из них являются кривые Мортона и кривые Гильберта.
Отличный пост с разбором этой темы написал Адриан Ионеску. Он называется Processing Petabytes of Data in Seconds with Databricks Delta.
Азы кластеризации на кривых Мортона
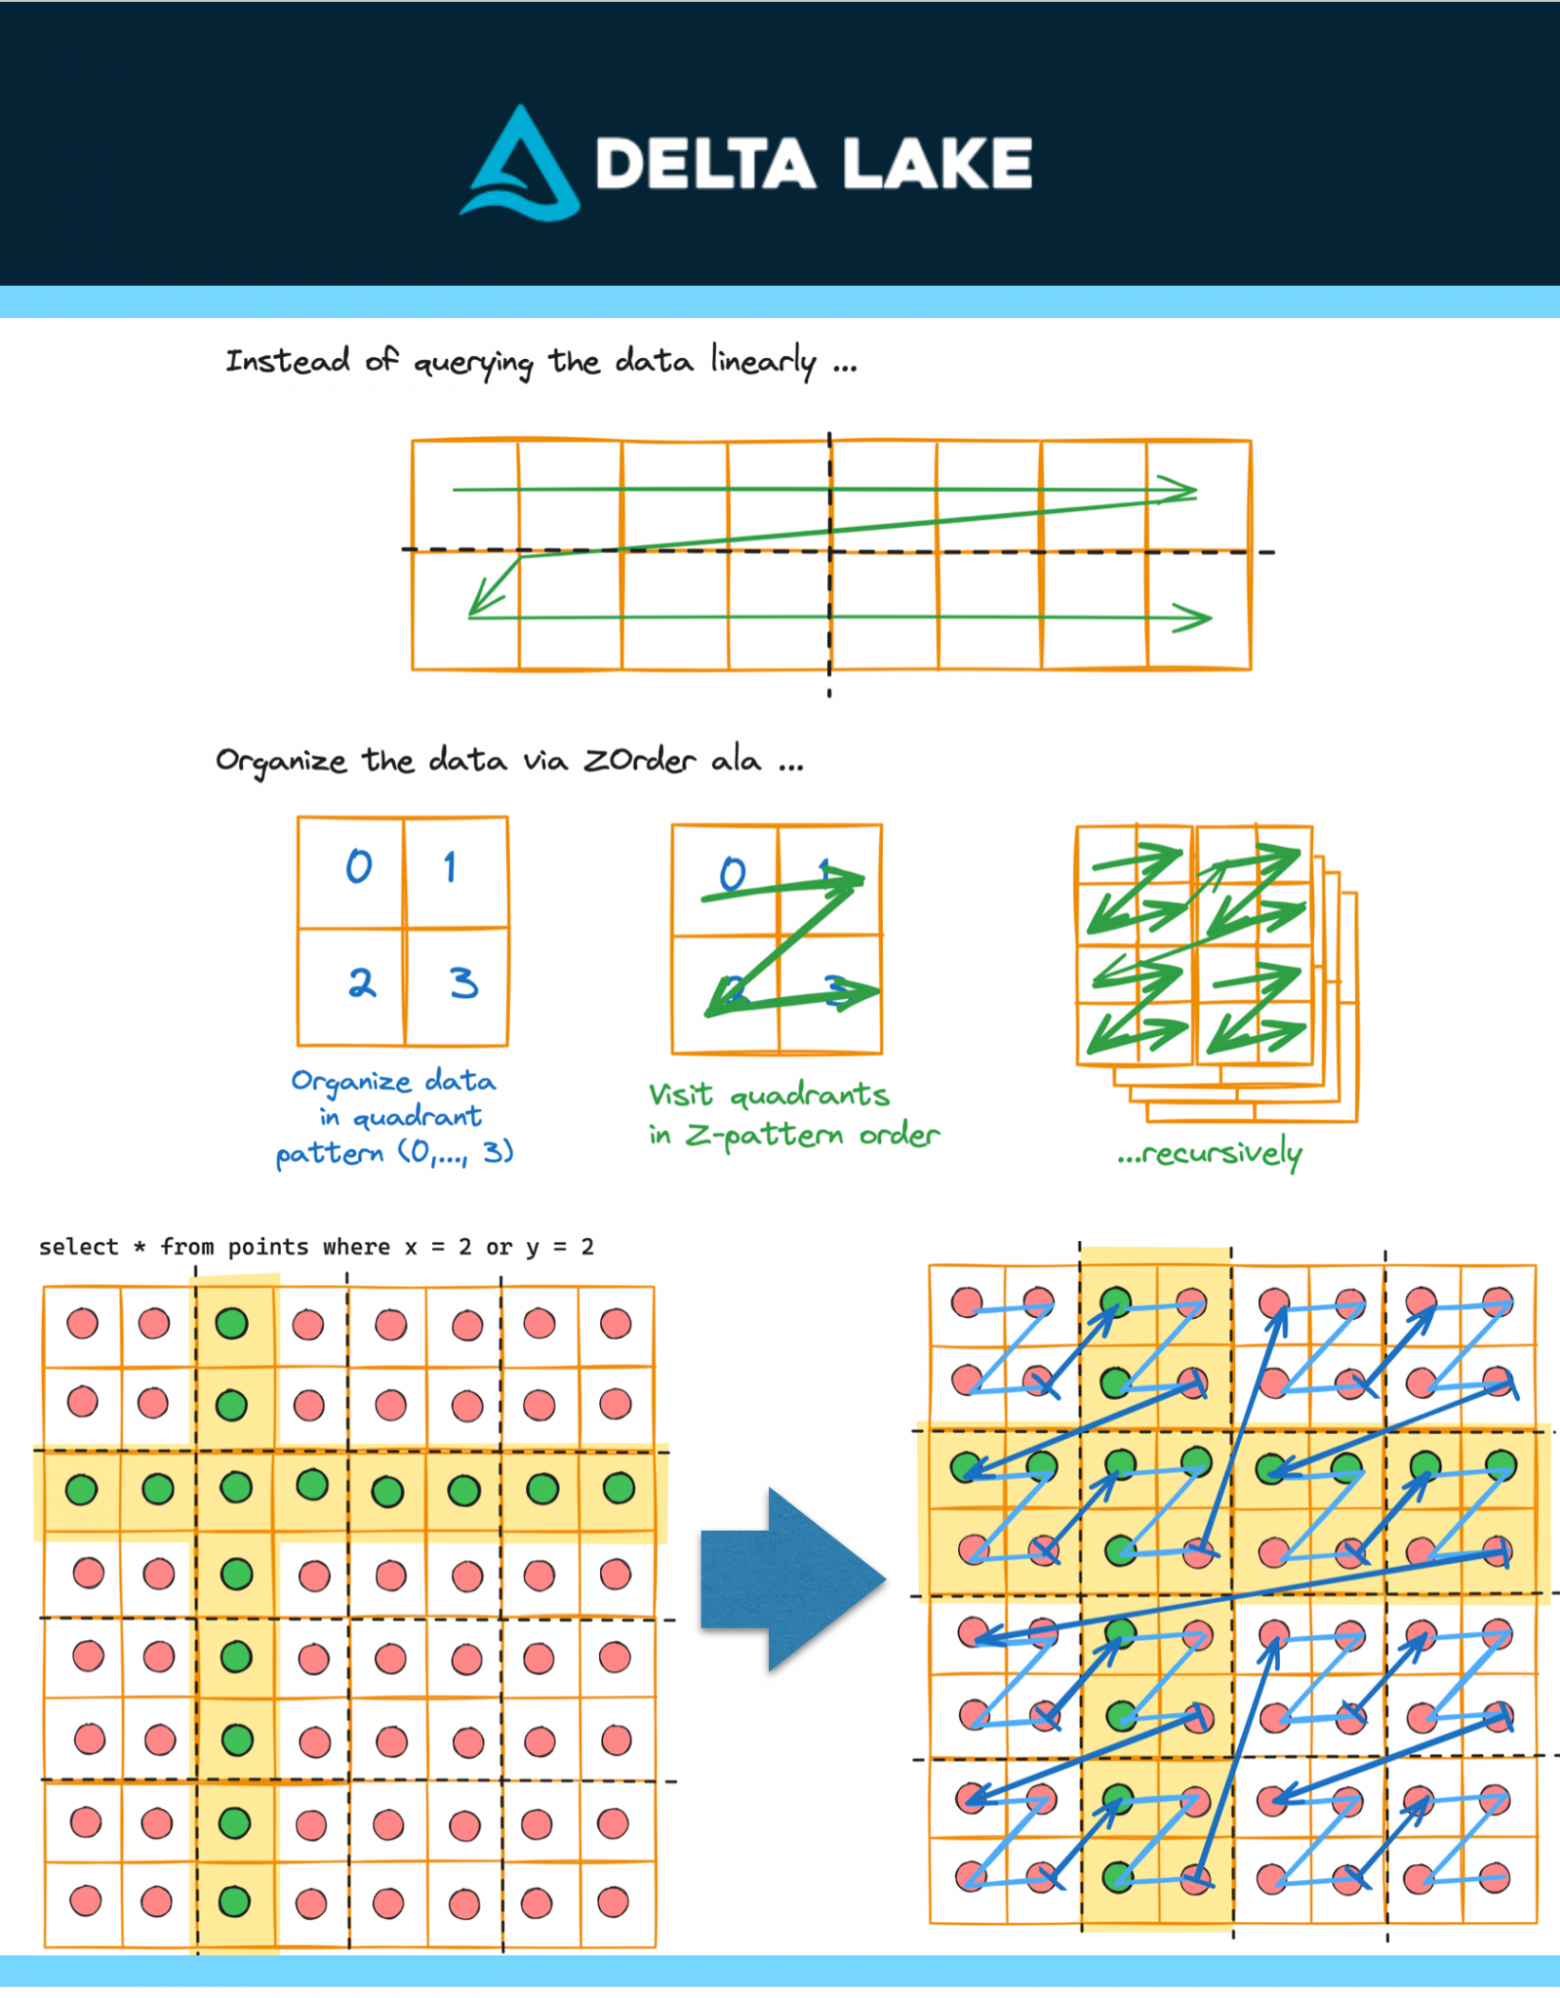
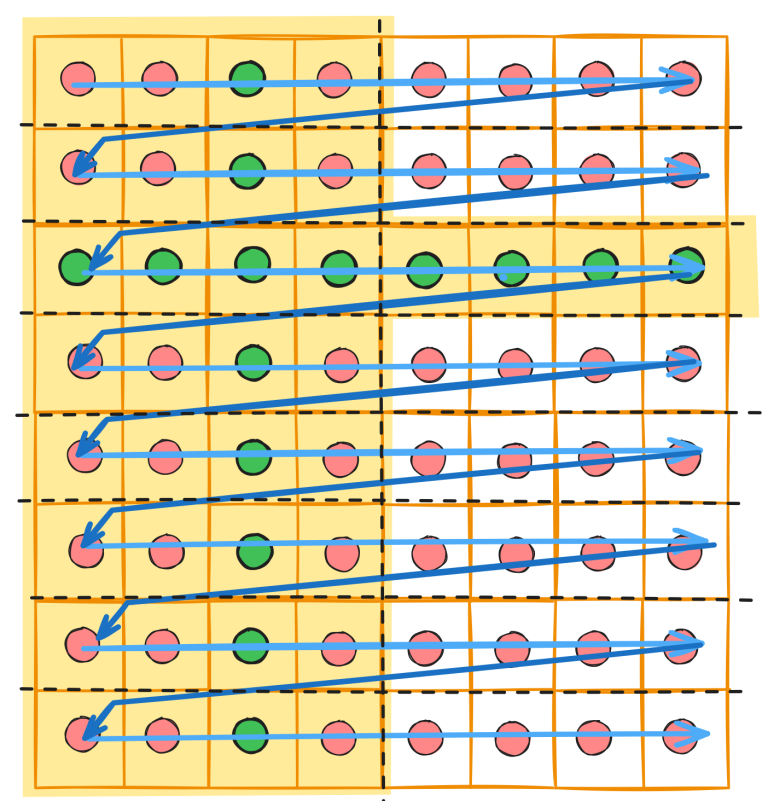
Кривая Мортона — это сохраняющая локальность разновидность кривых Пеано. Кривая Мортона позволяет, применяя фильтры, пропускать данные во множестве столбцов. Концепция такова: если любой прямоугольник размером 4×1 при запрашивании данных будет трактоваться как отдельный файл, то движок будет последовательно обрабатывать файл за файлом в процессе линейных проходов.
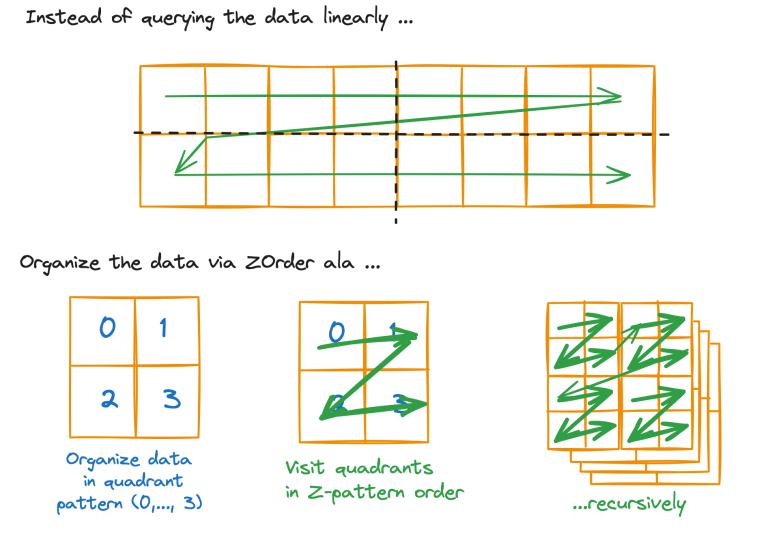
Но, если организовать данные в таком Z-порядке, то концептуально каждый файл будет представлять собой квадрант 2×2. Файл просматривается в порядке “Z” (0, 1, 2, 3), то есть, рекурсивно. Допустим, у вас есть следующий SQL-запрос, в котором данные представляются в двух измерениях, то есть, откладываются по осям (x, y).
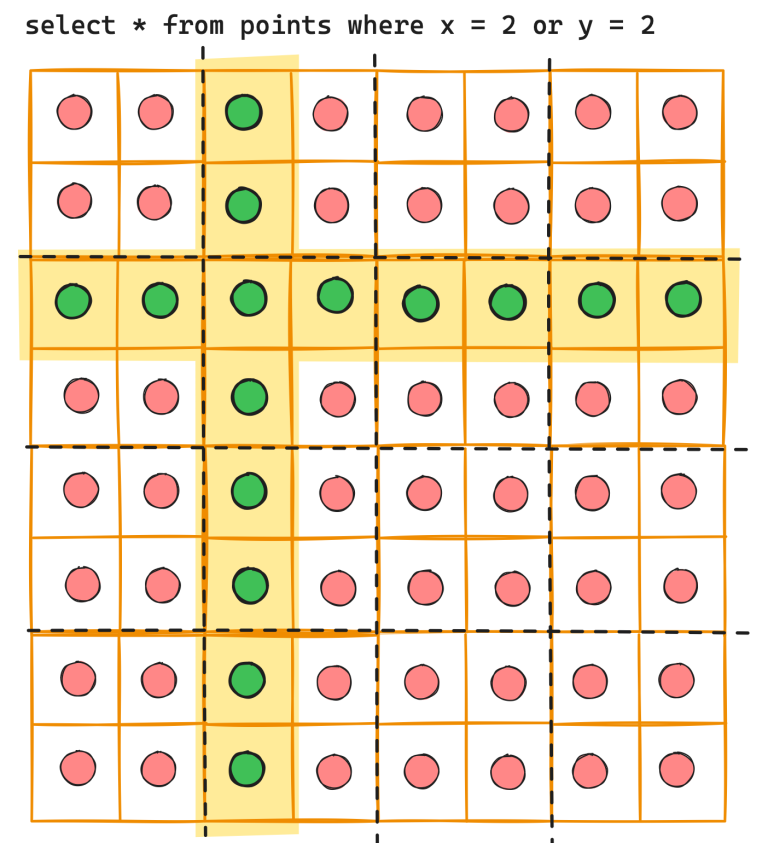
В зелёных кружках с жёлтым фоном — те данные, которые мы хотим прочитать. Красные данные мы собираемся пропустить. Напомню, что в соответствии с Z-порядком читается квадрат 2×2 (прерывистая линия), и таким квадратом представлен каждый файл.
Линейное сканирование
Но при запрашивании данных в линейном порядке каждому файлу соответствует прямоугольник 4×1 (прерывистая линия). При линейном сканировании приходится прочитать девять (9) файлов (жёлтый фон, прямоугольники, очерченные прерывистой линией). Также получается 21 ложноположительный результат, таким результатам соответствуют красные кружки на жёлтом фоне.
Сканирование в Z-порядке
С другой стороны, кластеризация в Z-порядке позволяет сократить количество как файлов, так и ложноположительных результатов. Каждый файл представлен квадратом 2×2 (прерывистая линия) и сканируется так, как рисуется буква Z (светло-голубая линия). Но связь между точками в каждом Z (т.e., в каждом файле) меняется и зависит от конкретных данных.
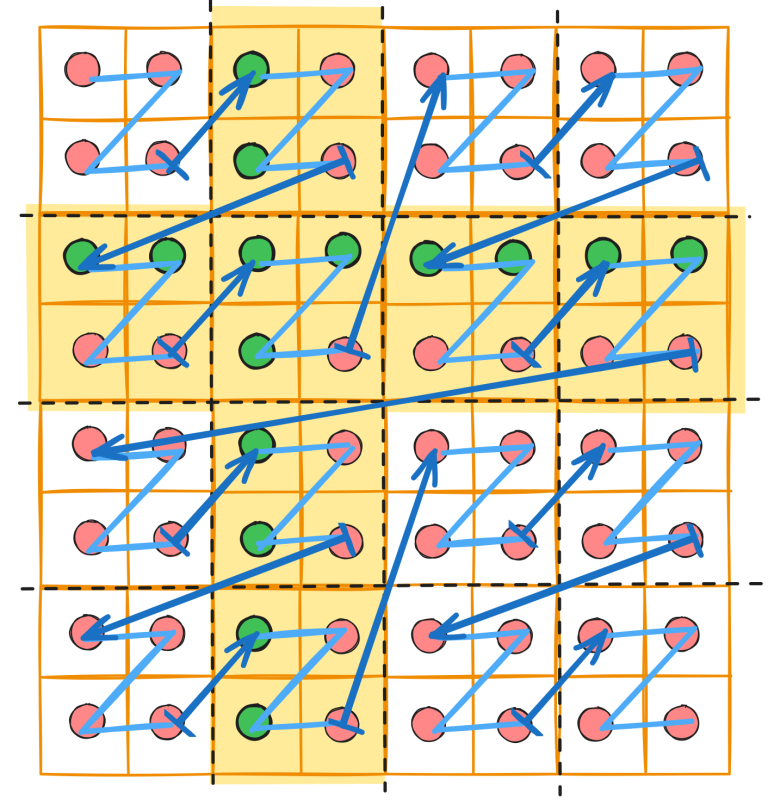
В данном примере движок запросов сканирует всего 7 файлов (а не 9). Кроме того, вместо 21 остаётся 13 ложноположительных результатов.
Обсуждение
Выше мы рассмотрели упрощённый двумерный пример (одно измерение — один столбец). Но кластеризация такого типа применима и со множеством столбцов. Здесь действует такое эмпирическое правило: данная техника наиболее эффективна при работе с 5-8 столбцами. Мы можем не ограничиваться несколькими столбцами, как при сегментировании, а приобрести гораздо более значительную гибкость, если будем кластеризовать данные для обхода в Z-порядке.