Python знают миллионы разработчиков. Но что сегодня отличает Junior+ от Middle, а Middle от Senior, кроме количества лет в резюме? Собрали актуальную матрицу компетенций для питонистов: от объектной модели и pytest до высоконагруженных систем, Big Data и промышленных решений с LLM.
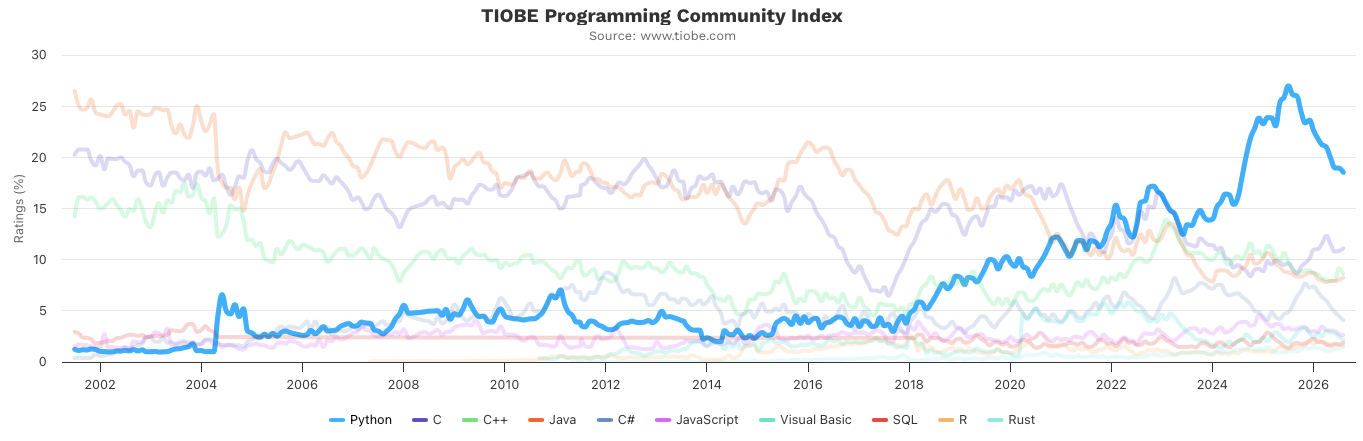
Python — самый популярный язык разработки в мире. Уже более трех лет он возглавляет индекс TIOBE, который оценивает распространенность языков на основе данных поисковых систем, количества квалифицированных специалистов, учебных курсов и поставщиков программного обеспечения. В августе 2026 года Python занимает первое место с показателем 18,53%, значительно опережая C, C++ и Java.
Согласно ежегодному опросу Stack Overflow, в котором приняли участие почти 50 000 инженеров из 177 стран, в 2025 году этот язык активно использовали 57,9% разработчиков — примерно на 14% больше, чем годом ранее. Авторы исследования связывают такой скачок популярности с активным применением Python в проектах ИИ, data science и серверной разработке.
Это подтверждается и отчетом GitHub Octoverse 2025. Python сохраняет лидерство в задачах, связанных с машинным обучением и анализом данных. На фоне развития генеративного ИИ число Python-контрибьюторов на GitHub за год увеличилось на 48,8% — до 2,6 миллиона.
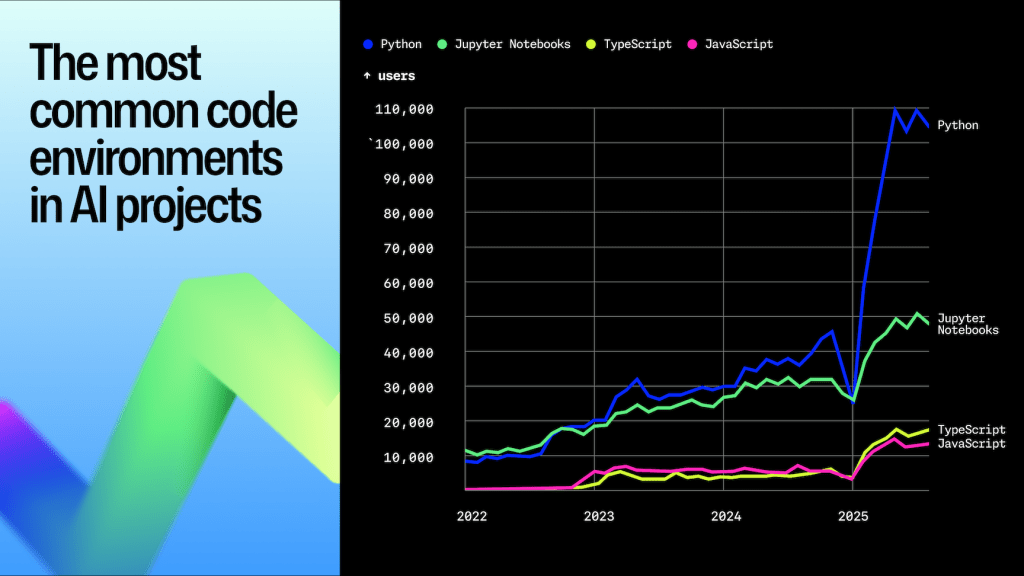
Одновременно меняются инструменты и подходы, которые используются в повседневной работе. По данным Stack Overflow, 84% разработчиков уже используют или планируют использовать ИИ-инструменты при создании программ, а среди профессиональных разработчиков 51% применяют их ежедневно. При этом доверие к результатам снижается: положительно к ИИ-инструментам относятся 60% респондентов против более 70% в 2023 и 2024 годах.
Для Python-разработчика это означает, что сегодня мало просто знать синтаксис или уметь написать рабочий эндпоинт. Да, по-прежнему необходимы фундаментальные знания языка, инженерные практики, тестирование, работа с базами данных, серверной частью и инфраструктурой. Но к ним добавляется еще один важный навык — грамотное использование ИИ. Важно не только уметь поручить модели написание кода, но и самостоятельно проверить результат, найти ошибки и уязвимости, защитить конфиденциальные данные и понимать ограничения таких инструментов.
Вместе с экспертами Учебного центра IBS мы собрали актуальную матрицу компетенций Python-разработчика и разбили ее по трем направлениям: язык и инженерные практики, бэкенд и инфраструктура, данные и алгоритмы. Посмотрим, что необходимо знать разработчику в целом и какие компетенции появляются на уровнях Middle и Senior.
Ключевые направления развития Python-разработчика
Язык и инженерные практики
Начнем с самого Python. На первых этапах важно понять, как устроен язык и почему код ведет себя именно так, а не просто запомнить синтаксис и набор конструкций. С ростом опыта к этому добавляются типизация, архитектура кода, конкурентное выполнение, профилирование и более глубокое понимание интерпретатора.
Базовый уровень: что должен уметь Python-разработчик
Junior+ — здесь имеем в виду разработчика на проекте, а не вчерашнего выпускника курсов — должен уверенно владеть базовыми конструкциями Python: списками, словарями, множествами, f-строками, функциями, аргументами и областями видимости LEGB. Важно понимать замыкания и lambda, знать генераторы и yield и хотя бы на базовом уровне оценивать сложность операций с коллекциями. Не обойтись без исключений и стандартной библиотеки: try/except/finally, datetime, pathlib, json, re. Для сетевого взаимодействия пригодятся requests.
На уровне теории нужно разбираться в декораторах, contextlib, itertools, dataclasses, MRO, Event Loop, Match/Case, walrus operator, миксинах, abc.ABC, typing.Protocol и метапрограммировании. Нужно знать устройство памяти Python: garbage collector, reference counting и GIL.
На этом же уровне формируются первые инженерные привычки: работа с Git (lifecycle, ветвление, merge vs. rebase, stash), pyenv, интерактивные оболочки IPython и Jupyter, виртуальные окружения через venv/poetry, управление пакетами с помощью pip, соблюдение PEP 8, форматирование и статический анализ с помощью Ruff и Flake8. Отдельная часть базы — типизация и тестирование. Нужно понимать основные Type Hints и уметь писать простые unit-тесты на pytest.
Junior-разработчик должен разобраться с объектно-ориентированным программированием (ООП) и моделью памяти Python: классами, методами и наследованием, ссылками на объекты, изменяемыми и неизменяемыми типами. Именно здесь часто обнаруживаются пробелы, которые не видны по способности написать прикладной код. По наблюдениям эксперта Учебного центра IBS Дмитрия Сысолятина, начинающим разработчикам нередко бывает сложно объяснить разницу между сравнением по значению и идентичности, понять поведение ссылок и копирования, определить хешируемость объекта или проследить работу областей видимости и замыканий. Джуны не всегда уверенно применяют декораторы, генераторы, протокол итерации, пользовательские исключения и контекстные менеджеры.
Хотя у нас пока недостаточно репрезентативной статистики по LLM-навыкам, их развитие точно стоит относить к приоритетам для питонистов. На уровне Junior+ ИИ стоит использовать как ускоритель рутины и объяснялку, а не как источник готового кода. Попросить модель помочь с регулярным выражением, разобрать traceback, объяснить незнакомый фрагмент чужого кода, сгенерировать докстринги. Требование одно — понимать код, который принимаешь.
Специалист: глубже в язык и качество кода
На уровне Middle от разработчика требуется уже не просто работающий код, а хороший код, который можно безопасно развивать. Поэтому появляется строгая типизация: mypy, Generics, X | None, TypeVar, Protocol и другие возможности typing. Pydantic используется для валидации данных и создания DTO. Код должен быть идиоматичным, а принципы SOLID применяться осмысленно, без превращения каждого класса в отдельный паттерн.
Отдельный рубеж — асинхронность. Специалист должен различать потоки, процессы и корутины, понимать async/await, работать с concurrent.futures и выбирать подходящий механизм конкурентного выполнения. По словам Дмитрия, именно выбор модели конкурентности часто оказывается проблемной зоной. Разработчики знают asyncio, threading и multiprocessing, но не всегда могут обосновать свой выбор, корректно организовать отмену задач и тайм-ауты, избежать неконтролируемого разделяемого состояния и предусмотреть обработку ошибок.
Тестирование также превращается из набора assert в отдельную инженерную практику: фикстуры, mocking, тестирование асинхронного кода и внешних интеграций, правильное определение границ unit-тестов. ИИ здесь выступает как инструмент рефакторинга, анализа и декомпозиции легаси-кода и генерации сложных тестов.
Профессионал: понимать, что происходит внутри
Сеньор уже должен уметь разбираться с ситуациями, где абстракции Python перестают скрывать детали. Там, где на уровне Junior+ достаточно было знать теорию (GIL и Event Loop, multiprocessing, garbage collector, reference counting), профессионалу нужно уметь решать рабочие кейсы высокой сложности, искать утечки памяти и анализировать поведение программы под нагрузкой.
Строгая типизация становится еще глубже: strict mypy, ковариантность, сложные типы и генераторы. Для отдельных задач могут потребоваться конечные автоматы на генераторах и более сложные механизмы метапрограммирования.
Важная область — многопоточность и многопроцессность: синхронизация, состояния гонки, блокировки, трудно воспроизводимые ошибки и диагностика проблем с конкурентным выполнением.
Сеньор проектирует системы и отвечает за безопасность. Джуны и мидлы будут приносить код от ИИ, а Senior должен уметь его проверять, искать уязвимости и утечки данных и понимать, когда для проекта с ограничениями по конфиденциальности нужны локальные модели. Это особенно актуально потому, что разработчики все чаще сталкиваются с ситуацией, когда сгенерированный код выглядит правдоподобно, но содержит ошибку или требует больше времени на отладку, чем написанный вручную.
Для Senior характерен другой сценарий работы с LLM: использовать модель как оппонента при разборе архитектурных решений — например, чтобы сравнить шардирование и партиционирование для конкретной схемы данных с учетом профиля нагрузки.
Бэкенд и инфраструктура
Python-разработчик работает не только с языком. Код должен стать сервисом, получить данные из базы, пройти авторизацию, попасть в контейнер и в конечном счете нормально работать в проде.
Базовый уровень: собрать работающий сервис
На начальном уровне достаточно понимать основы FastAPI: маршруты, модели и обработку запросов. Нужны базовые навыки логирования через logging и понимание Docker.
Обязательная часть — SQL: SELECT, JOIN и базовые операции с данными. Даже если большую часть запросов формирует ORM, разработчик должен понимать, что происходит на уровне базы.
Полезно знать основы объектно-реляционного отображения (ORM) и уметь подключать готовые LLM API без построения сложных RAG-систем.
Специалист: проектировать и эксплуатировать
Middle должен уметь строить бэкенд не только функционально, но и архитектурно. В матрицу компетенций входят FastAPI и Dependency Injection через Depends. Для работы с базами нужны SQLAlchemy и Alembic, а также Redis. Появляются вопросы безопасности: JWT, CORS, хэширование паролей и безопасное написание Dockerfile. В инфраструктуре — Docker Compose и CI/CD с GitLab CI или GitHub Actions. Для фоновых задач пригодятся Celery и базовое понимание RabbitMQ.
Наблюдаемость тоже становится частью ответственности разработчика: структурированное JSON-логирование и метрики в Prometheus должны помогать понять, что происходит с сервисом.
Именно на этом уровне становится заметно, что знание конкретного фреймворка — только часть компетенции. Как отмечает Дмитрий, разработчик может уверенно работать с FastAPI, Django или SQLAlchemy, но испытывать сложности при проектировании транзакций, выборе уровня изоляции, работе с блокировками и индексами, устранении N+1 или управлении ORM-сессиями.
В распределенных системах добавляются идемпотентность, повторные вызовы, частичные отказы, выбор между синхронным и асинхронным взаимодействием, гарантии доставки сообщений и согласованность данных.
Для ИИ-сервисов Middle должен уметь интегрировать модели в бэкенд и строить базовые RAG-системы с векторным поиском.
Профессионал: система под нагрузкой
На Senior-уровне разработчик должен понимать поведение всей системы, а не отдельного приложения. В базах данных это означает работу с проблемами высоконагруженных систем. В системах обмена сообщениями появляются Kafka-кластеры, топики, партиции и принципы распределенного хранения.
Наблюдаемость выходит за пределы обычных логов и метрик: профессионал должен уметь использовать распределенную трассировку через OpenTelemetry, отслеживать ошибки и оповещения в Sentry, визуализировать данные из Prometheus в Grafana и работать с Health Check API.
Отдельным направлением, которое пока не входит в формальную матрицу компетенций, становится harness engineering — проектирование инженерного контура, в котором работает модель или ИИ-агент. Качество такого решения определяется уже не только выбором модели и формулировкой запроса. Необходимо организовать доступ к инструментам и данным, управление контекстом и состоянием, разграничение прав, контроль стоимости, обработку сбоев, проверку результатов, трассировку и накопление обратной связи. Для Senior-разработчиков это означает переход от подключения отдельного LLM API к созданию управляемых и проверяемых агентных систем. Агент должен работать в среде, которая ограничивает возможные действия, фиксирует ход выполнения, проверяет результат и позволяет установить причину ошибки. По мере распространения ИИ-агентов качество такого инженерного контура будет все сильнее влиять на надежность решения.
Данные и алгоритмы
Python тесно связан с обработкой данных, поэтому даже бэкенд-разработчику полезно понимать, что происходит с данными после того, как они покинули базу или пришли из внешнего сервиса.
Базовый уровень: работать с данными и оценивать сложность
На начальном уровне разработчик должен уметь читать CSV, JSON и Excel, выполнять базовые операции с DataFrame и понимать, как работать с табличными данными. Параллельно нужно знать основы алгоритмической сложности. Big O — не только теория для собеседований: понимание сложности операций со списками и словарями помогает заранее увидеть решения, которые плохо масштабируются.
Отдельный весомый блок — высокопроизводительные вычисления в NumPy: векторизация, работа с массивами и матричные операции.
Специалист: строить обработку данных
Middle должен уверенно работать с Pandas: GroupBy, Merge, Pivot, очисткой и преобразованием данных. К этому добавляются базовые алгоритмы, сортировки, деревья и графы, а также инженерия данных: скрипты выгрузки и локальные ETL-пайплайны.
Но здесь важен не только правильный результат. По нашим наблюдениям, проблемы часто появляются при выборе типов данных, выравнивании по индексам, объединении таблиц, обработке пропусков и дубликатов, векторизации, оптимизации памяти и предотвращении неявных преобразований. Разработчик должен уметь ответить на вопрос, как его решение поведет себя при росте объема данных, а не только проверить его на небольшом подготовленном наборе.
Профессионал: большие данные и производительность
В конечном счете требования к профессионалу здесь те же, что и в других областях: он должен думать не только о том, получится ли правильный результат, но и о том, насколько решение устойчиво, воспроизводимо и предсказуемо при изменении объема и качества данных.
Senior имеет кругозор в смежных областях, владеет широким спектром подходов и инструментов, а главное — способен обоснованно выбрать технологию, методику решения задач и выстроить весь процесс.
Сертификация как способ найти пробелы
Чем больше становится матрица компетенций, тем сложнее самостоятельно определить, что именно пора подтянуть. Здесь может помочь независимая сертификация. В ней нет чисто теоретических тем, а также проверки софт-скилов вроде самостоятельности или менторства. Все темы сводятся к умению решать те или иные виды бизнес-задач. Сертификация разбита на три уровня по сложности этих самых задач: «Базовый» (Junior+), «Специалист» (Middle) и «Профессионал» (Senior).
По накопленным результатам оценок Python-разработчиков в Учебном центре IBS мы видим закономерную картину. На начальном уровне проблемы чаще всего связаны с объектной моделью Python: изменяемостью и неизменяемостью, ссылками и копированием, идентичностью, хешируемостью, областями видимости и замыканиями. На уровне Middle пробелы смещаются к строгой типизации, тестированию, управлению зависимостями и конкурентному выполнению. У Senior отдельные пробелы встречаются реже, но речь идет о более дорогих с точки зрения проекта ошибках: производительности, утечках памяти, синхронизации, многопоточности, метапрограммировании и проектировании API. Похожая ситуация с бэкендом и данными. Знание FastAPI или SQLAlchemy еще не означает понимания поведения сервиса под нагрузкой, а умение работать с Pandas — способности построить устойчивый процесс обработки данных.
Ниже — карта компетенций с разбивкой по уровням сертификации.
Список навыков и компетенций современного Python-разработчика
Уровень «Базовый»:
Базовые конструкции Python: PEP8, f-строки, списки, словари, множества; функции (аргументы, области видимости LEGB, lambda, замыкания); понимание сложности операций коллекций; генераторы (yield); Match/Case, walrus operator, расширенная распаковка, позиционные и именованные аргументы (/ и *), Exception Groups, heapq, itertools, reference counting.
ООП и модель памяти: классы, методы, наследование; ссылки, связи и изменяемость объектов (mutable/immutable); MRO.
Внутреннее устройство и метапрограммирование; устройство памяти (GC, GIL); дескрипторы.
Исключения и Stdlib: try/except/finally, datetime, pathlib, json, re.
Сеть и инструменты: использование requests; виртуальные окружения venv, pip; стайлеры Ruff/Flake8.
Использование LLM: ИИ-ассистент (генерация скриптов, regex, SQL); поиск ошибок, объяснение чужого кода, генерация докстрингов; понимание галлюцинаций.
Типизация и тесты: базовые Type Hints, базовый pytest (написание простых assert-/unit-тестов).
Прикладные основы: FastAPI (маршруты, модели), логирование (logging), основы Docker.
Базы данных: базовое понимание SQL-запросов (SELECT, JOIN), ORM.
LLM API: использование готовых API (OpenAI/DeepSeek) без построения сложных RAG.
Анализ таблиц: чтение CSV, JSON, Excel, базовая работа с DataFrame.
NumPy: ndarray, broadcasting, векторизация, слайсинг и булевы маски, линейная алгебра и статистика.
Алгоритмы: понимание алгоритмической сложности (Big O) для списков и словарей.
Уровень «Специалист»:
Чистый код и типизация: строгая типизация (mypy, Generics, X | None); Pydantic (валидация, DTO); идиоматичный код.
Глубокая база языка: O-сложность; декораторы, contextlib, itertools, yield from; кастомные исключения.
Асинхронность async/await: потоки vs процессы vs корутины; concurrent futures.
Архитектура тестов: pytest, фикстуры, Mocking.
Инструменты и сеть: менеджмент зависимостей (poetry), pre-commit; асинхронные HTTP-запросы (httpx).
Использование LLM: ИИ-рефакторинг и тесты; улучшение кода (SOLID, паттерны), разбор легаси с загрузкой контекста, генерация сложных тестов (pytest, моки).
Web-фреймворки: FastAPI, Dependency Injection.
Базы данных: ORM (SQLAlchemy), управление миграциями (Alembic), Redis.
Безопасность: JWT-авторизация, CORS, хэширование паролей, SQL-инъекции, XSS, CSRF и rate limiting.
Контейнеризация и CI/CD: Docker-compose, пайплайны GitLab CI / GitHub Actions.
Брокеры очередей: вынос фоновых задач в Celery, базовый RabbitMQ.
Логирование и наблюдаемость: JSON-логирование, экспорт метрик в Prometheus.
LLM API и RAG: интеграция LLM в бэкенд, базовый RAG (векторный поиск).
Анализ данных: продвинутый Pandas, GroupBy, Merge, Pivot, очистка данных.
Алгоритмы: сортировки, базовые деревья и графы для анализа данных, хеш-таблицы, связанные списки, динамическое программирование, бинарный поиск, BFS/DFS и Дейкстра.
Инженерия данных: написание скриптов выгрузки, локальные ETL-пайплайны.
Сложное ООП и метакод: метаклассы, дескрипторы; паттерны System Design; динамическая генерация классов.
Уровень «Профессионал»:
Память и многопоточность: Event Loop; multiprocessing; поиск утечек памяти.
Строгая типизация и генераторы: Strict mypy, ковариантность; yield from, стейт-машины на генераторах.
QA-архитектура: SDET.
Использование LLM: ревью ИИ-кода (поиск уязвимостей и утечек), LLM для System Design, безопасный кодинг (локальные модели под NDA).
Брокеры под нагрузкой: кластеры Kafka, топики, партиции и Consumer Groups.
Продвинутая наблюдаемость: распределенная трассировка (OpenTelemetry), Sentry, Grafana и Health Check API.
LLM Production: ИИ-агенты (Tool Calling); reranking; метрики RAG (Evals), внедрение Guardrails; prompt-инжиниринг (Zero-shot / Few-shot / Chain-of-Thought), Structured Outputs, token estimation, токенизация и подготовка датасетов; анонимизация данных.
Big Data: инженерия; потоковая обработка (Streaming).
Версионность данных: использование DVC для отслеживания изменений.
Что дальше
Матрица компетенций — не чек-лист, после которого можно считать обучение завершенным. Это ориентир, который помогает понять, где вы находитесь сейчас, какие навыки уже стали вашей сильной стороной, а какие стоит развивать дальше. Технологии продолжают меняться, инструменты становятся умнее, а привычные подходы — переосмысливаются. Но именно системное понимание разработки, способность разбираться в новых технологиях и принимать инженерные решения остаются теми компетенциями, которые не теряют ценности. Надеемся, что эта матрица поможет вам выстроить собственный маршрут профессионального развития — независимо от того, начинаете ли вы карьеру в Python или уже проектируете сложные системы.
Эта статья — пятая в серии полноценных дорожных карт развития. Ранее мы уже публиковали матрицы компетенций для системного аналитика, архитектора ПО, бизнес-аналитика и Java-разработчика. За какую профессию нам взяться в следующий раз? Пишите в комментариях!