Группа исследователей, среди которых Хэмиш Айвисон, один из авторов открытых рецептов пост-тренинга Tülu и OLMo, 14 октября опубликовала работу о методе CaLIF. Он решает известную проблему обучения с подкреплением на проверяемых наградах, RLVR, в задачах следования инструкциям. Модель учится выполнять формальные ограничения вроде «ровно три абзаца» или «без длинных тире» и одновременно перестает содержательно отвечать на вопрос.
В чем проблема
Бенчмарки вроде IFBench проверяют, соблюдены ли ограничения на форму ответа. Отвечает ли текст на сам запрос, верификатор не видит. Модель может получить полный балл, почти ничего не сказав по существу. Когда такой верификатор становится наградой в RL, возникает reward hacking. Доля выполненных требований растет, а качество ответа падает.
Масштаб эффекта хорошо виден на цифрах по OLMo 3, открытой модели AI2. Обычный IF-RLVR поднимает выполнение требований на IFBench с 26,98 до 44,93, но оценка качества ответа по 10-балльной шкале падает с 4,51 до 2,96. Модель почти удвоила формальную метрику ценой трети качества.
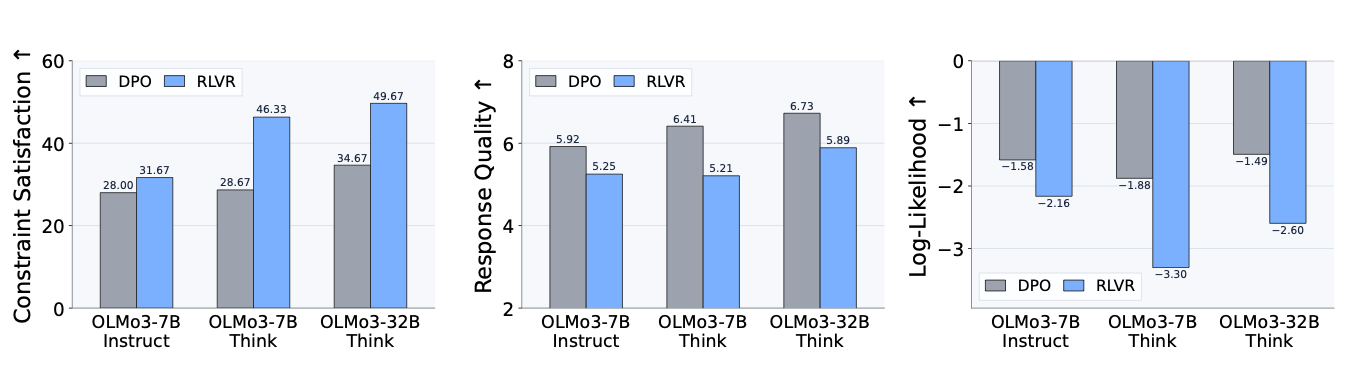
На графике из исследования отлично видны эти «ножницы» для моделей OLMo 3: слева — синие столбики (после RLVR) резко растут. Это формальное выполнение требований; в центре — те же синие столбики ощутимо падают по сравнению с серыми (DPO). Это потеря реального качества и смысла ответов.
Что предлагают авторы
CaLIF добавляет к награде верификатора бонус за правдоподобие. Ответ оценивается по тому, насколько он вероятен для исходной замороженной референс-модели при условии одного только запроса, без ограничений. Ответ, который выполнил все формальные условия и при этом стал пустым или странным, получает низкую вероятность у модели, которая просто отвечает на вопрос.
Бонус калиброван, и, что практически важно, метод не требует ни внешнего LLM-судьи, ни обученной reward-модели. Референс-политика в RL-пайплайне и так уже есть.
Результаты
С CaLIF качество ответа на OLMo 3 остается на уровне 4,59, даже чуть выше исходного, а выполнение требований растет до 34,64. Деградация качества за один проход обучения, по данным AI Weekly, снижается в семь раз. Формальная метрика растет меньше, чем при «чистом» RLVR, и это честная цена. Метод отказывается от той части прироста, которая была получена с помощью reward hacking.
На более широкой выборке CaLIF превосходит базовые политики в 40 из 45 сравнений «модель — метрика» на трех бенчмарках следования инструкциям с рубриками, указано на странице работы. Проверка шла на моделях от 1,7B до 8B параметров в режимах с рассуждением и без. Датасет опубликован на Hugging Face. Конкретные цифры по OLMo 3 приведены по вторичному обзору, полный текст статьи на arXiv для этого материала напрямую не перепроверялся.
Итог
Если в RL-пайплайне награда считается только проверяемыми правилами, метрика выполнения требований будет врать, и параллельно нужна оценка содержательного качества, хотя бы выборочная. Другой важный момент заключается в том, что бонус по правдоподобию у референс-модели почти ничего не стоит в реализации и закрывает самый частый сценарий reward hacking. Метод проверен только на моделях до 8B, поэтому для крупных моделей это пока гипотеза, но для типичного корпоративного дообучения такой размер как раз основной.

ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Запустить ИИ‑роутер →