Про бизнес-анализ написаны талмуды (привет, адепты Вигерса): карта стейкхолдеров, матрица влияния, дерево целей, пирамида требований и множество других страшных терминов.
А в реальной серой жизни простых крестьян аналитиков этап бизнес-анализа выглядит так:
Приходит продакт: «Нам надо сделать вот эту штуку. Сходи к тем ребятам, поставь встречу, если что непонятно - приходи ко мне, разберёмся».
Ты приходишь: «Ребят, что хотим?» - «Вот это». И выдают тебе требования к фиче и критерии её готовности в пяти предложениях. Всё.
Утрирую, конечно. Но каждый раз, когда говорю об этом в больших пабликах (и здесь в том числе), то ловлю волну хейта, якобы разлагаю молодёжь и вообще еретик и не должен называться инженером.
Спорить про методологии у меня нет времени, и так эту статью за меня ИИ пишет пока я снимаю лайфстайл-контент как хорошо живется аналитику и как я могу летать почилить на острова раз в месяц (спойлер - нет, нет и еще раз нет. Бегите от таких инфоцыган, если видите IT-рилсы из высоток Дубая или посты на "проработанном-3бланском" с виллы на Бали).
Тут я просто покажу один из своих рабочих подходов: что я делаю после того, как эти пять предложений бизнес-требований записаны, и где именно на каждом шаге подключаю LLM.
Фича для примера маленькая: представим, что мы - маркетплейс и нам необходимо сделать кнопку «Повторить заказ» в сервисе доставки продуктов. Погнали.
Как я проектирую фичу с LLM
Маршрут целиком
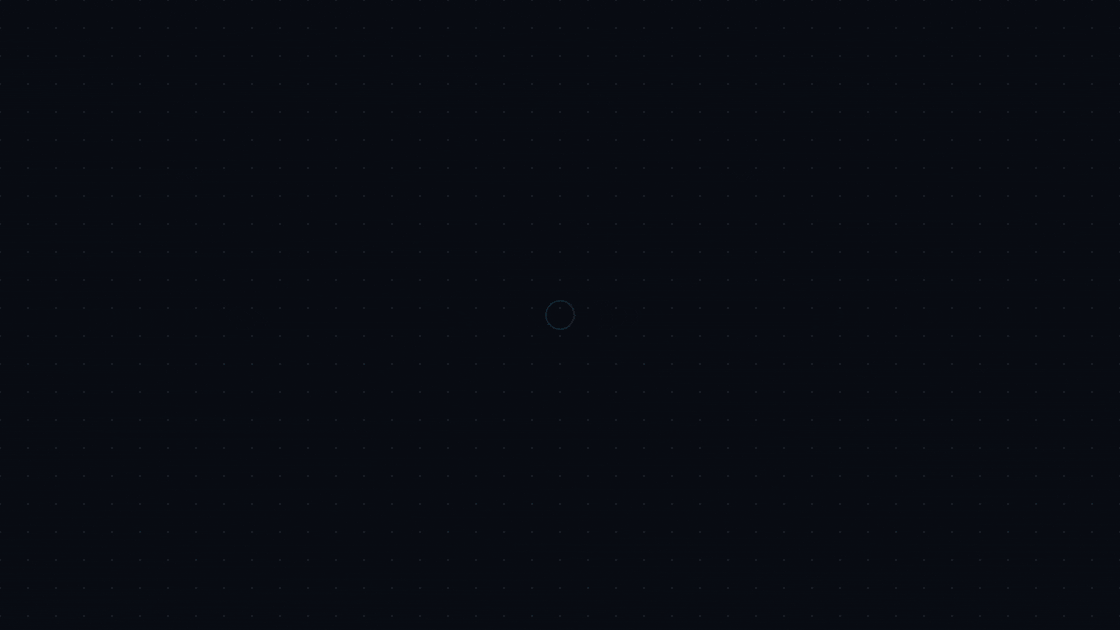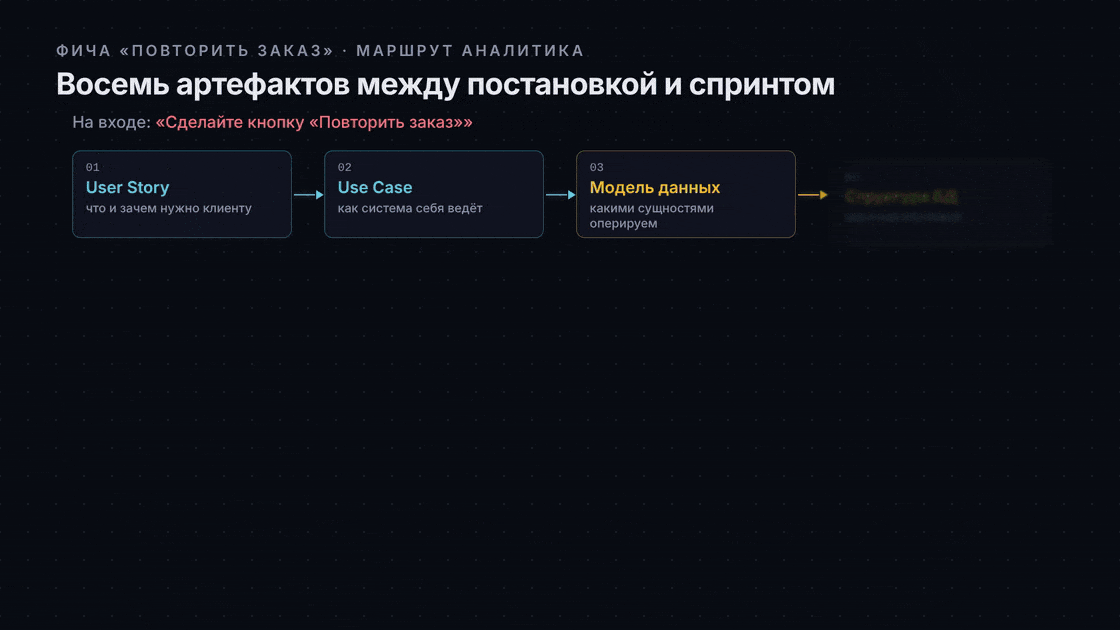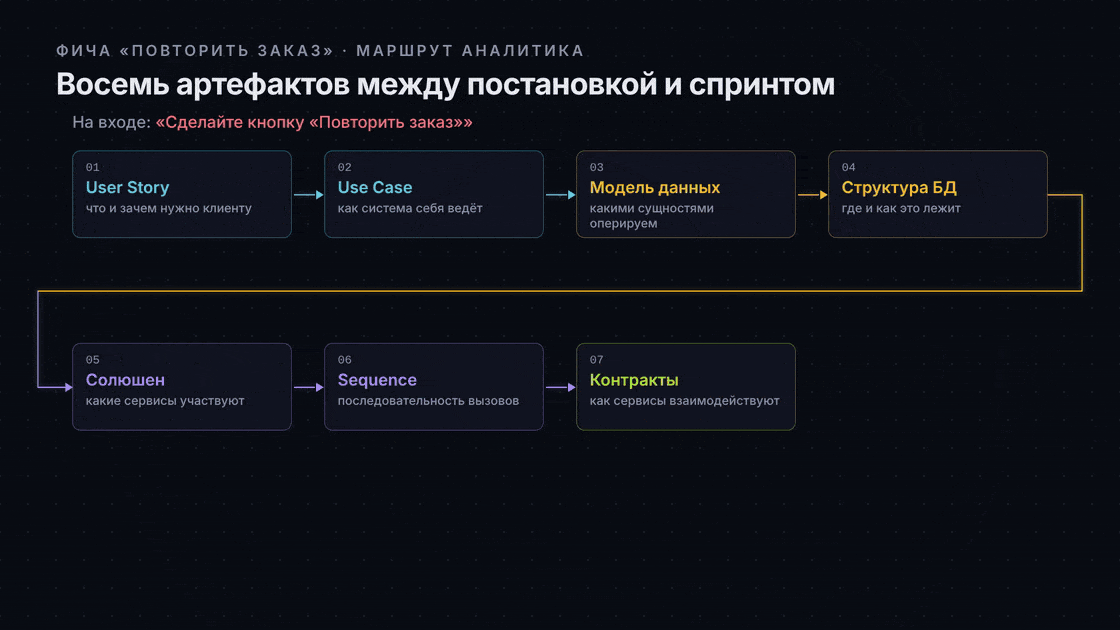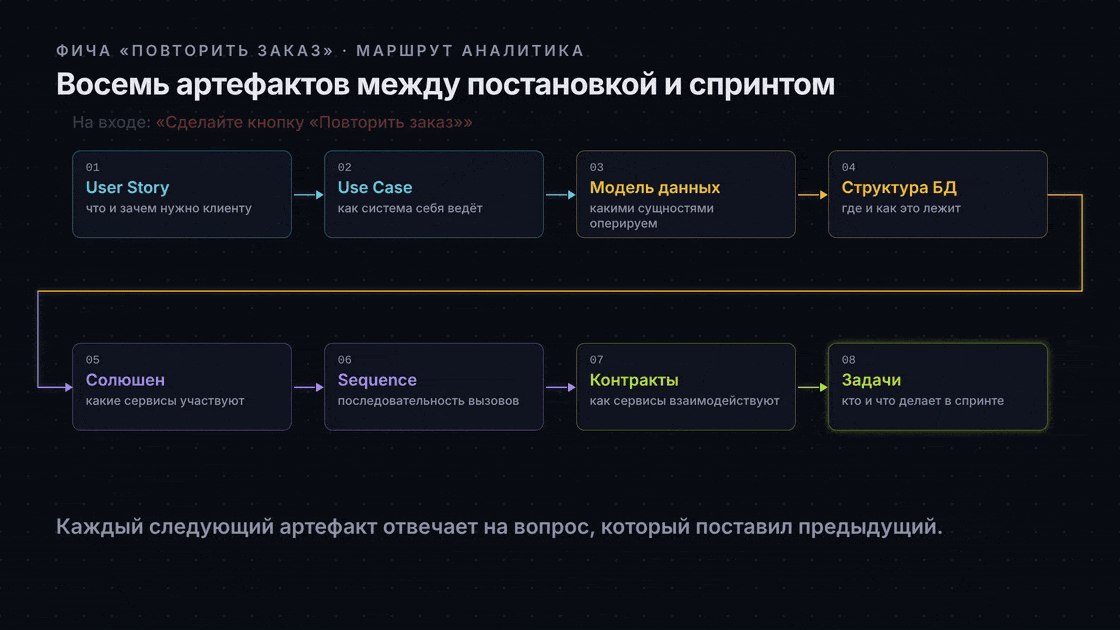
Порядок о котором я тут пишу - не догма. Он довольно удобен для проектирования и выстроен так, чтобы каждое решение принималось один раз и на том этапе, когда для него есть вся необходимая информация.
Замечание про промпты в статье
<ПРОЕКТ> — это одна страница. Тот самый Readme.md. Во всех user prompt есть этот блок: глоссарий с терминами, устройством проекта итд. Собирается один раз, подставляется везде в вызов LLM, постоянно актуализируется. Без него модель будет ресерчить ваш проект заново на каждом шаге, а это излишне и может вызывать галлюцинации.
Каждый следующий промпт (в этом флоу) получает результат предыдущего. Цепочка артефактов работает, только если модель видит, что было до. Ну или если вы делаете это все в рамках одного репозитория/проекта в IDE/Cursor/Claude итд
Блок «ОТКРЫТЫЕ ВОПРОСЫ» желателен в каждом промпте. Это самая ценная часть ответа - мы не дадим модели додумать что-то за нас, и задать вопросы, которые мы, в свою очередь, пойдем уточнять к нашим контрагентам или внутри команды.
Новый диалог на каждый шаг. В длинном чате модель накапливает лишний контекст (а равно и свои же ошибки) и может активнее галлюцинировать или предлагать неправильные решения.
Шаг 1. User Story
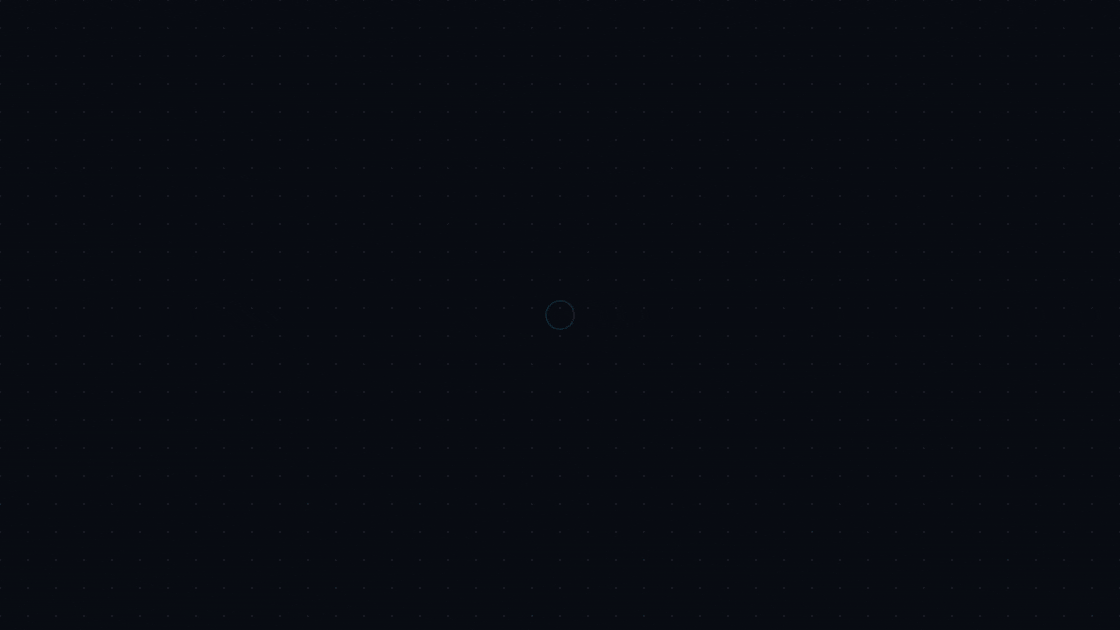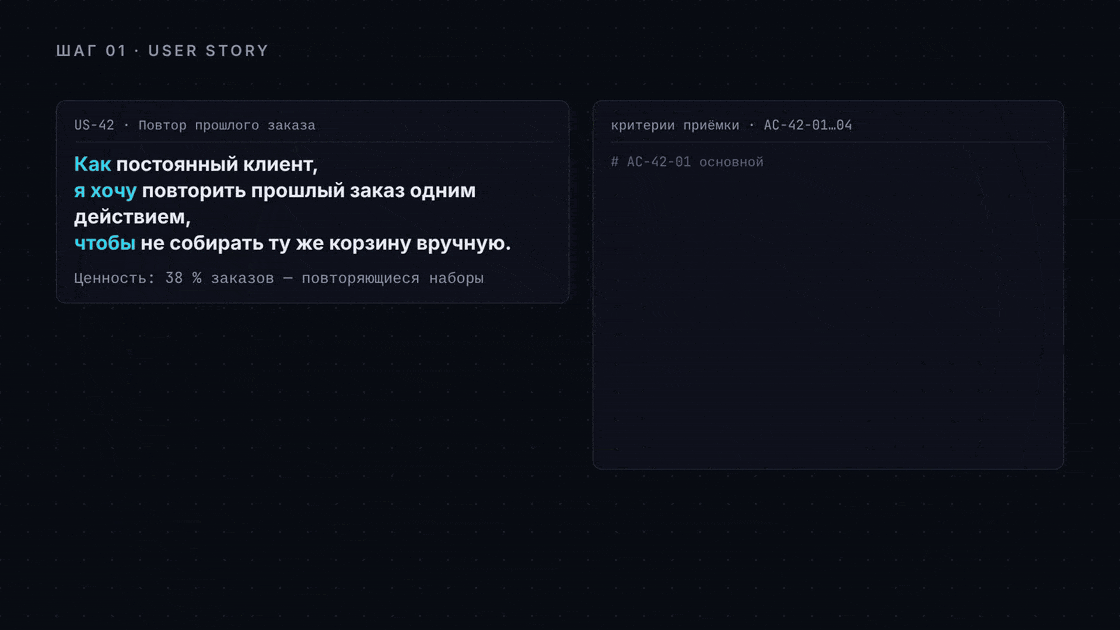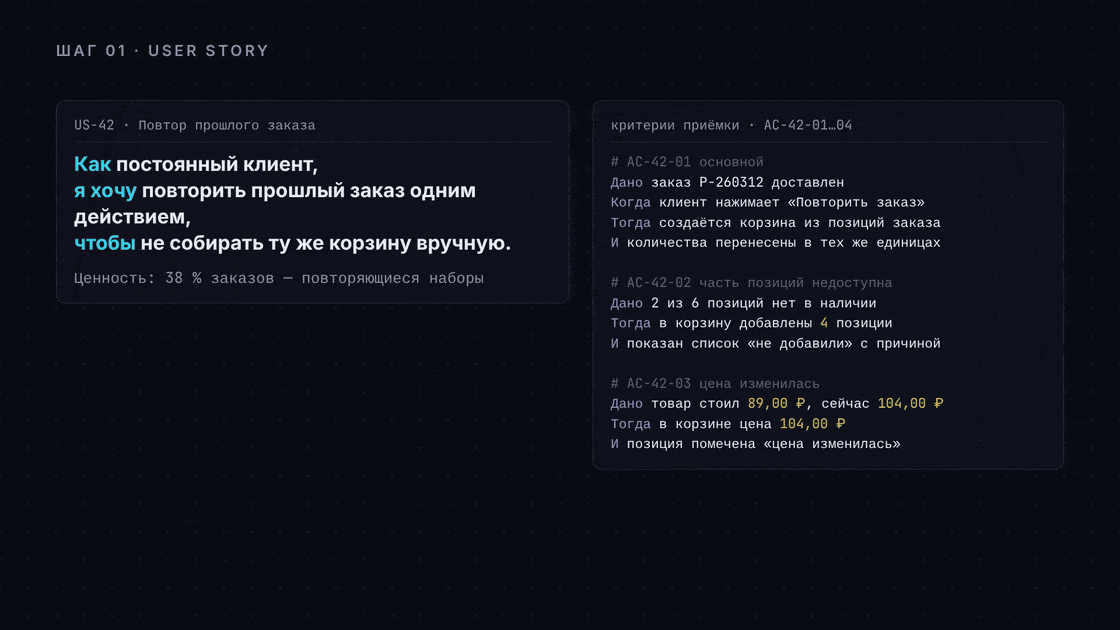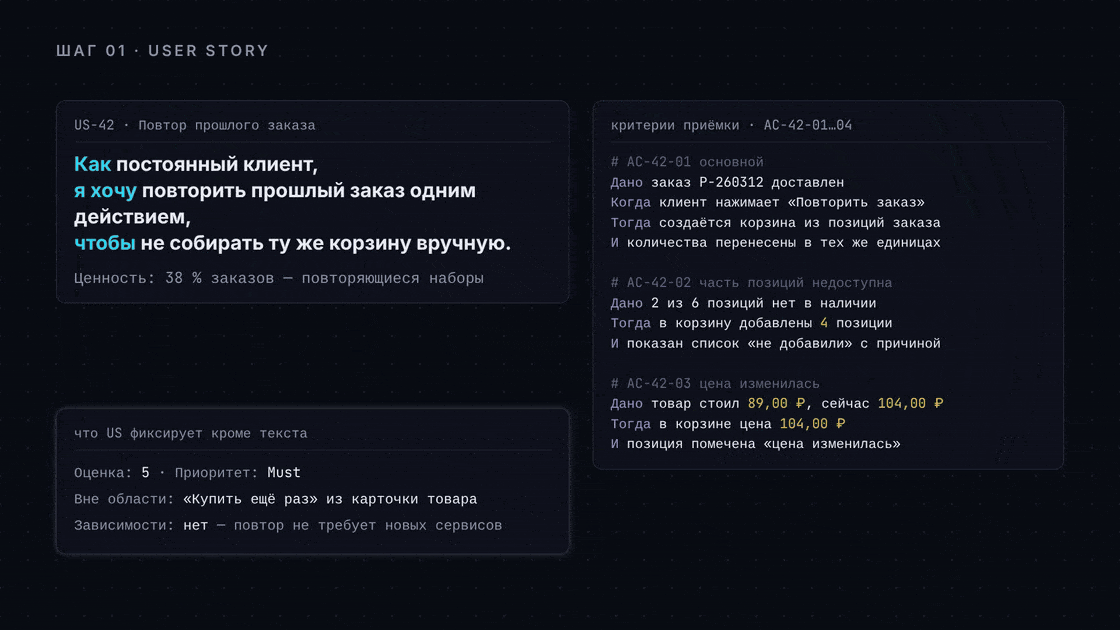
US - единственный артефакт, который аналитик пишет вместе с продактом. Что в ней важно: формулировка ожиданий бизнес-заказчика и критерии приемки результата.
Чего в US нет и быть не должно: сценарии реализации бизнес-требований. Это работа следующего шага.
Что здесь делает LLM
Переводит пять предложений бизнес-требований в корректный формат и помогает проработать/обнаружить граничные сценарии, которые аналитик сразу мог бы не предусмотреть.
System prompt:
Ты — продуктовый аналитик. Твоя задача — превращать сырые требования
заказчика в пользовательские истории с проверяемыми критериями приёмки.

ПРАВИЛА
1. Формат истории: «Как <роль>, я хочу <действие>, чтобы <ценность>».
   В ценности не повторяй действие другими словами.
2. Критерии приёмки — Given/When/Then (Дано / Когда / Тогда). Минимум три
   сценария: основной, граничный, негативный.
3. Все значения в сценариях конкретные. «Некоторая сумма», «любой
   статус», «корректно» — запрещены.
4. Если история не помещается в один спринт одной команды — раздели
   и покажи разделение явно.
5. Отдельным блоком: «Вне области задач» — что похоже, но в эту историю
   не входит.
6. Всё, чего нет во входных данных, не выдумывай: выноси в блок
   ОТКРЫТЫЕ ВОПРОСЫ с формулировкой, кому этот вопрос адресован.
7. Не предлагай технических решений.
User prompt:
<ПРОЕКТ>

ДАННЫЕ ОТ ЗАКАЗЧИКА:
1. На странице заказа — кнопка «Повторить заказ».
2. По нажатию собирается такой же заказ.
3. Если чего-то нет в наличии — показать, чего нет.
4. Цены берём актуальные.
5. Готово, когда повтор оформляется в два клика.

ИЗВЕСТНО ДОПОЛНИТЕЛЬНО:
- 38 % заказов — повторяющиеся наборы (данные аналитики за квартал).
- Повтор из карточки товара («купить ещё раз») — отдельная задача,
  в эту не входит.

ЗАДАЧА
Составь пользовательскую историю и критерии приёмки
Шаг 2. Use Case
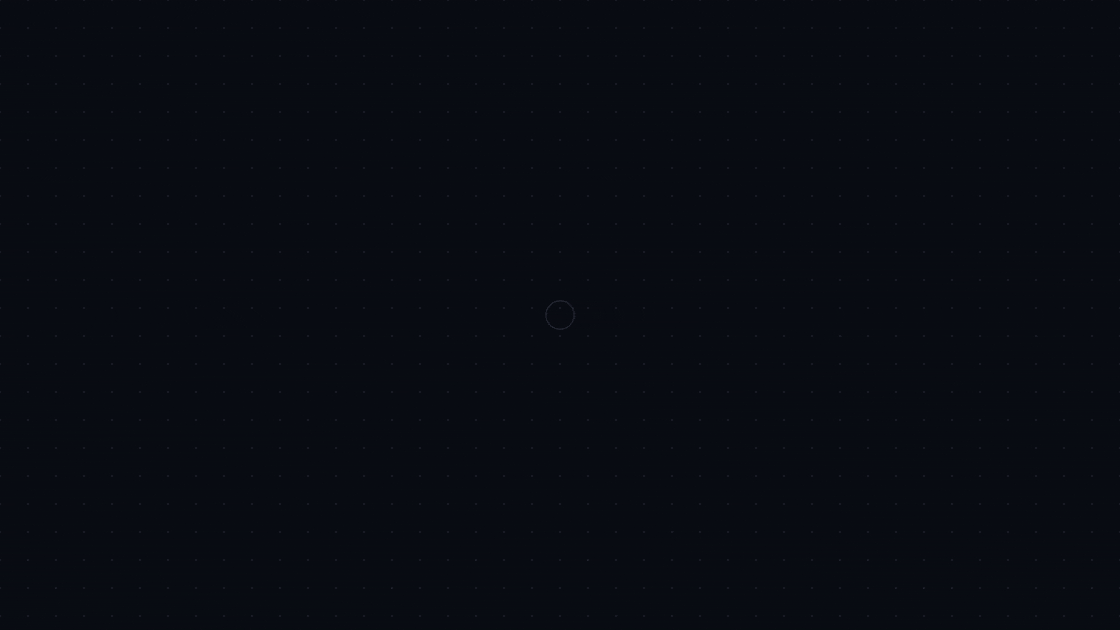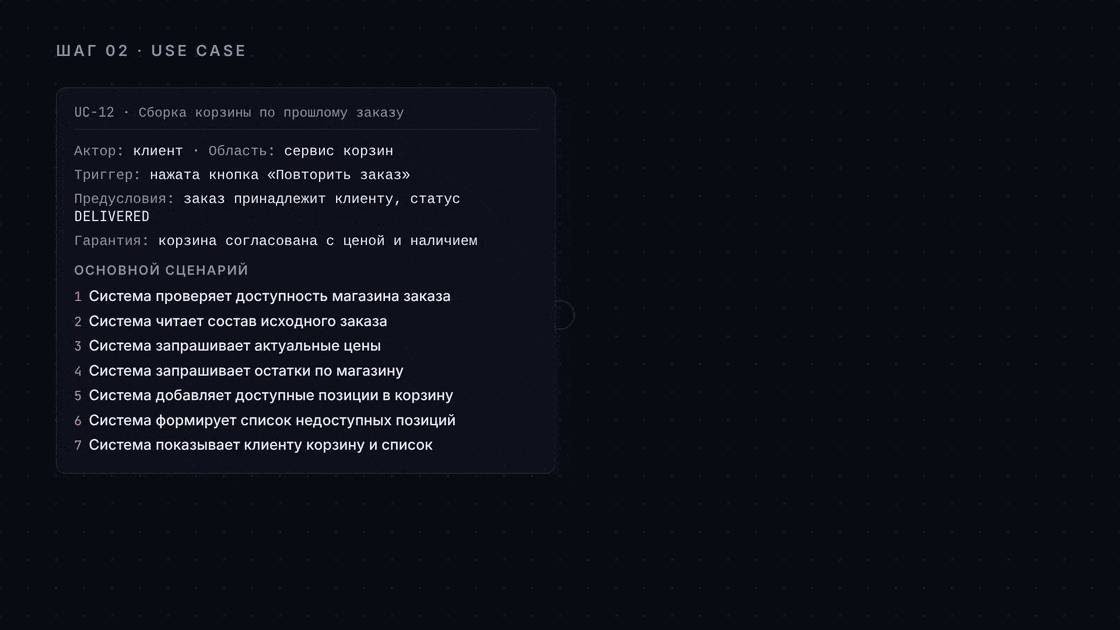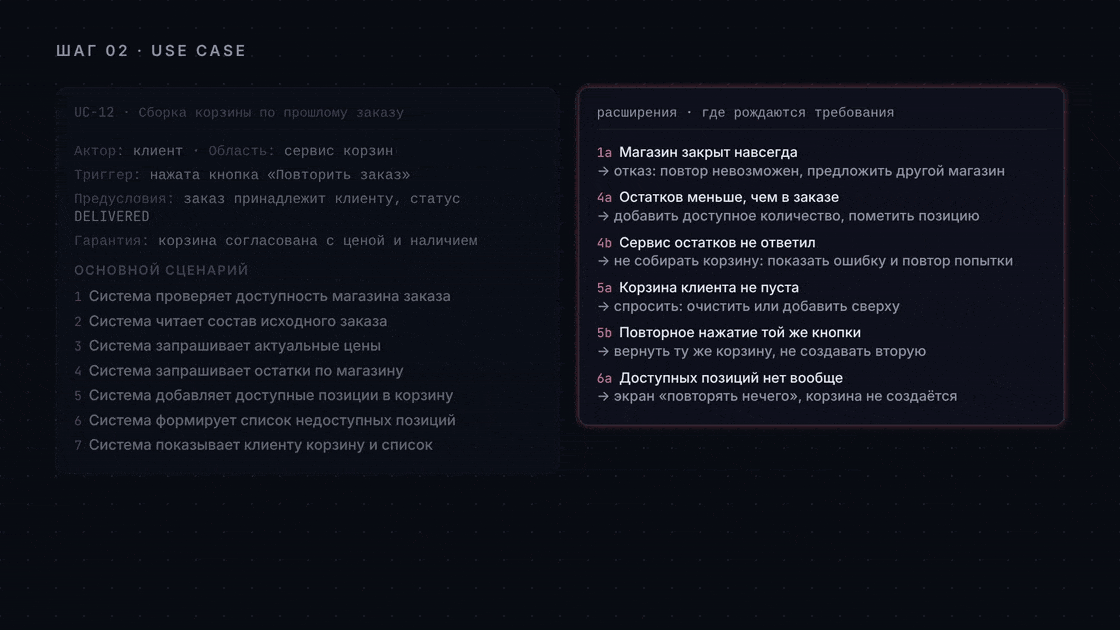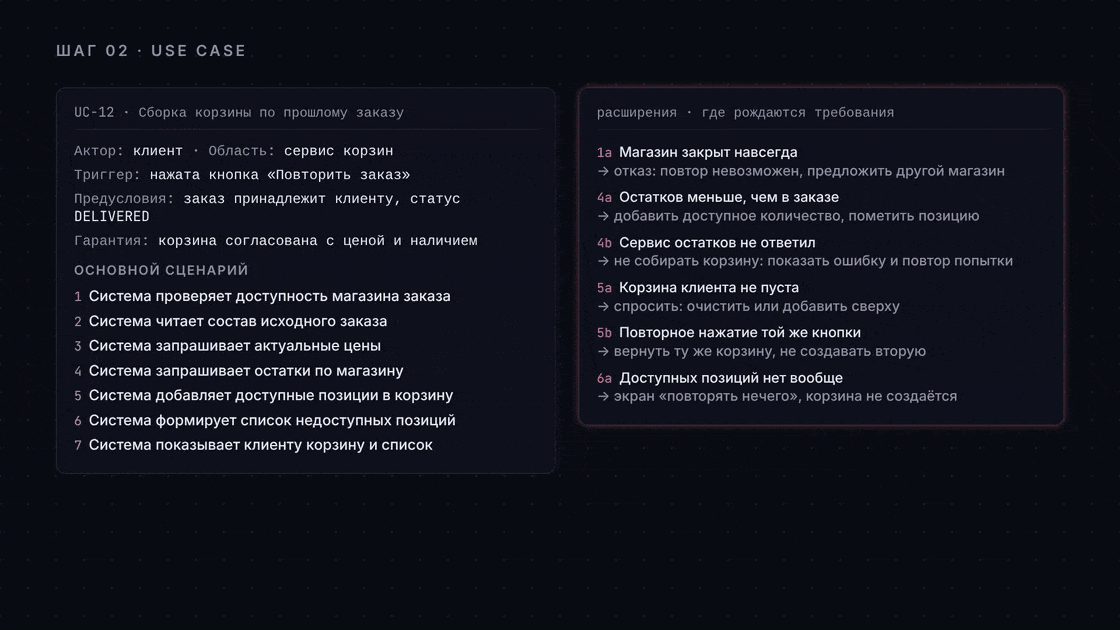
Теперь формируем Use Cases на основании User Story для ее декомпозиции.
Что здесь делает LLM
Вопросы, расширяющие поведение системы, прекрасно формализуются - и это отличное применение LLM. "Что, если внешняя система не ответила? Что, если данных меньше, чем ожидали? Что, если шаг выполняется второй раз? Что, если предыдущее состояние не то, которое мы предполагали?". Системный промпт ниже помогает в большинстве случаев предусмотреть большинство альтернативных веток при формировании Use Cases.
System prompt:
Ты — системный аналитик. Ты описываешь поведение системы в формате
use case.

СТРУКТУРА (все разделы обязательны)
ID и название · область действия · основное действующее лицо ·
предусловия · минимальные гарантии · гарантии успеха · триггер ·
основной сценарий · расширения · открытые вопросы.

ПРАВИЛА
1. Шаг — одно действие одного участника. «Система обрабатывает
   и отправляет» запрещено: это два шага.
2. Активный залог, явно указано, кто действует.
3. Никаких элементов интерфейса.
4. Для КАЖДОГО шага проверь четыре вопроса и заведи расширение,
   если ответ не «невозможно»:
   — внешняя система не ответила или ответила ошибкой;
   — данных пришло меньше, чем ожидалось;
   — шаг выполняется повторно (дубль запроса или события);
   — исходное состояние не то, которое предполагал шаг.
   Если расширения для шага нет — напиши «расширений нет»
   и обоснуй одной строкой.
5. Нумерация расширений: 3a, 3b, 5a — по номеру шага.
6. Минимальные гарантии формулируй как проверяемые утверждения,
   которые верны при ЛЮБОМ исходе сценария.
7. Не выдумывай бизнес-правила и не ссылайся на документы, которых
   нет во входных данных. Недостающее — в ОТКРЫТЫЕ ВОПРОСЫ.
User prompt:
<ПРОЕКТ>

<US И КРИТЕРИИ ПРИЁМКИ — результат шага 1 целиком>

ОГРАНИЧЕНИЯ СИСТЕМЫ, КОТОРЫЕ НАДО СОБЛЮСТИ:
- Состав заказа неизменяем: заказ — это документ на момент оформления.
- Корзина у клиента одна на магазин.
- Сервисы заказов, каталога и остатков — внешние по отношению
  к сервису корзин, вызовы синхронные.

ЗАДАЧА
Составь UC «Сборка корзины по прошлому заказу».
Шаг 3. Модель данных
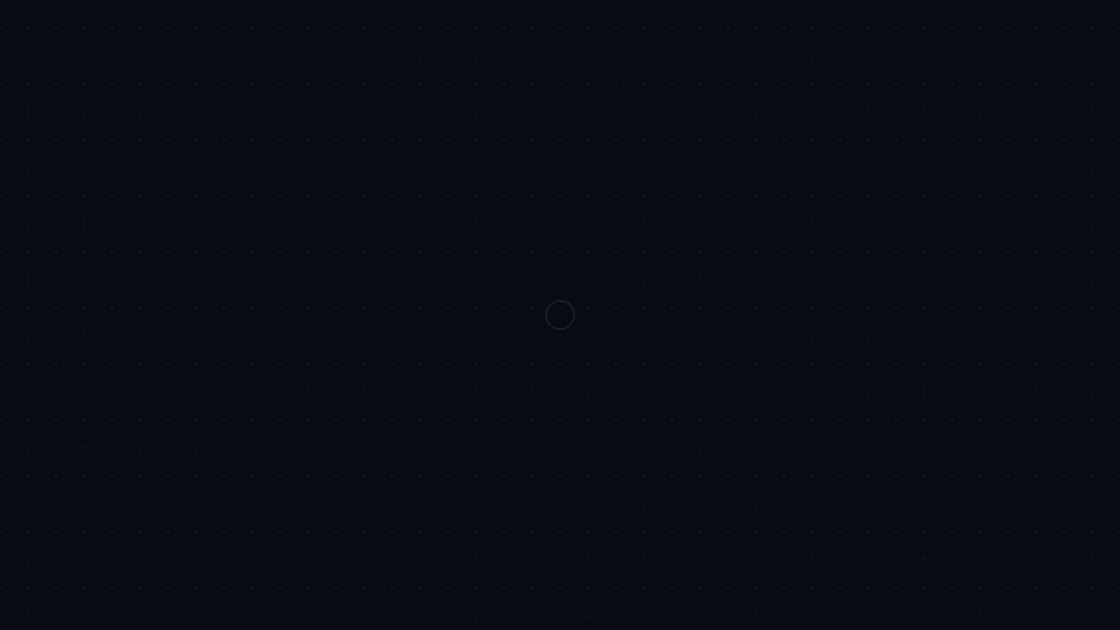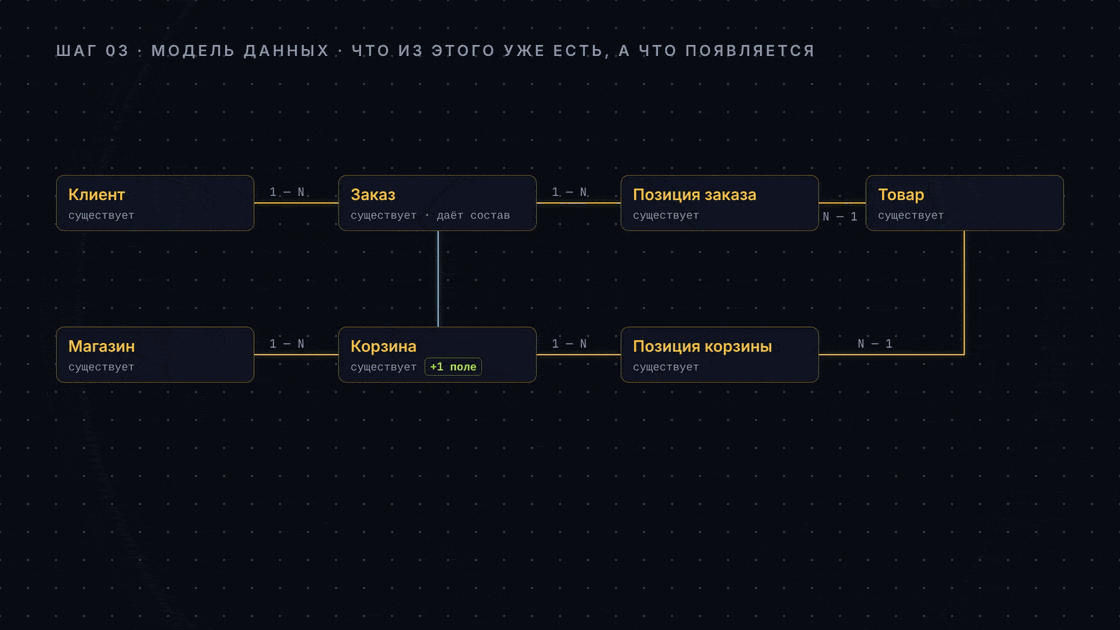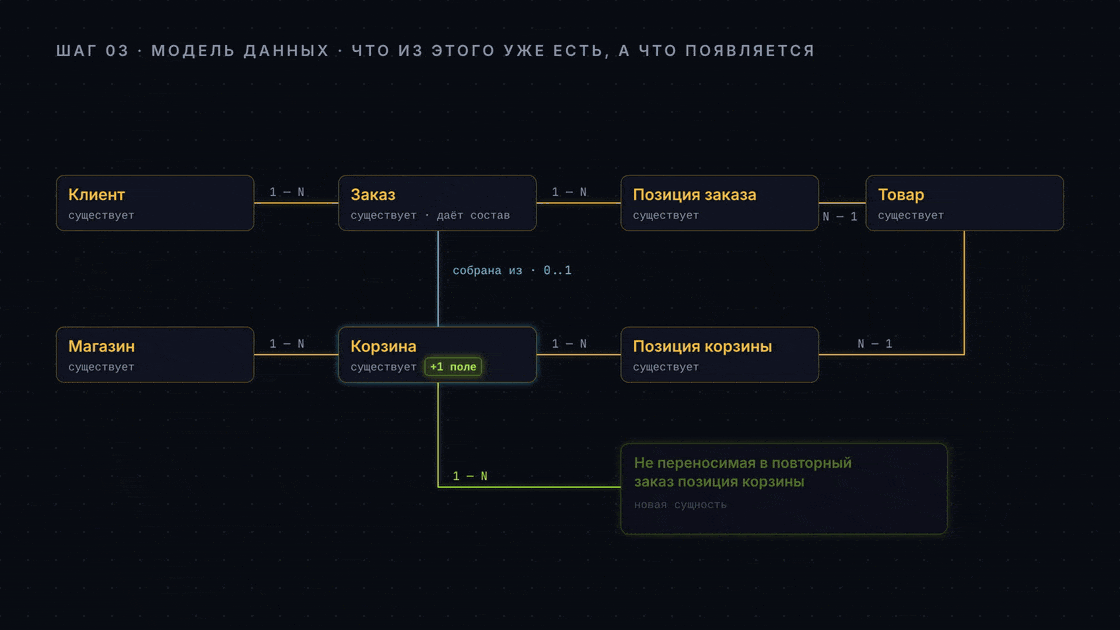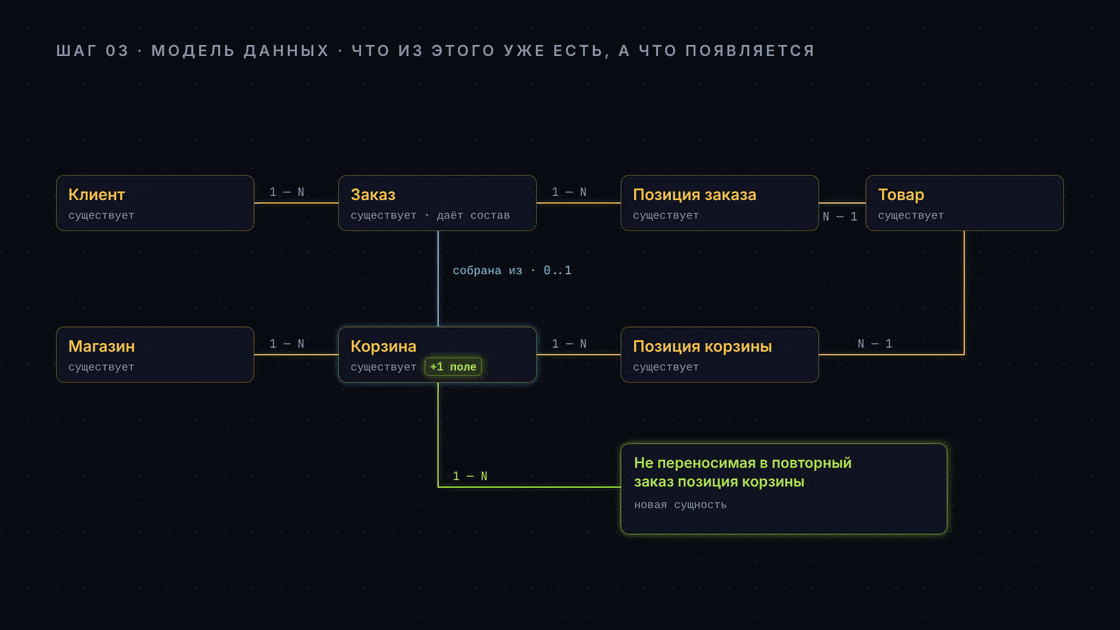
Этот шаг многие пропускают, сразу проектируя структуру БД. А зря: он отвечает на вопрос какие сущности у нас уже есть, а какие необходимо создать/изменить.
Что здесь делает LLM
Главная польза - не нарисовать модель данных, а заставить модель разделить сущности на существующие и новые/изменяемые. Это ровно тот вопрос, на который она ответит только если дать ей список того, что уже есть в системе. Кстати, это можно сделать, попросив ее (предварительно/или в процессе подготовки ответа) заресерчить код приложения или структуру БД.
System prompt:
Ты — системный аналитик, проектируешь концептуальную модель данных.

ПРАВИЛА
1. Работай только с сущностями и связями. Никаких типов, индексов
   и физических таблиц — это следующий шаг.
2. Каждую сущность помечай одной из меток:
   [существует] — есть в списке текущих сущностей,
   [+поле] — существует, но нужны новые атрибуты (назови их),
   [новая] — появляется из-за этой фичи.
3. Для каждой связи укажи кардинальность с обеих сторон
   и обязательность.
4. Если данные нужно хранить снимком, а не ссылкой, — скажи об этом
   явно и обоснуй одной строкой.
5. Отдельным блоком: «Решения и альтернативы» — для каждого
   нетривиального решения перечисли отвергнутые варианты и причину.
6. Если из входных данных непонятно, как моделировать, — не решай
   сам, опиши варианты в ОТКРЫТЫЕ ВОПРОСЫ.
User prompt:
<ПРОЕКТ>

<UC ЦЕЛИКОМ — результат шага 2>

ТЕКУЩИЕ СУЩНОСТИ СИСТЕМЫ:
Клиент, Магазин, Товар, Заказ, Позиция заказа, Корзина,
Позиция корзины, Слот доставки, Платёж.

ЗАДАЧА
Построй концептуальную модель данных для фичи повтора заказа.
Покажи, какие сущности переиспользуются как есть, каким нужны
новые атрибуты и какие появляются впервые.
Шаг 4. Структура БД
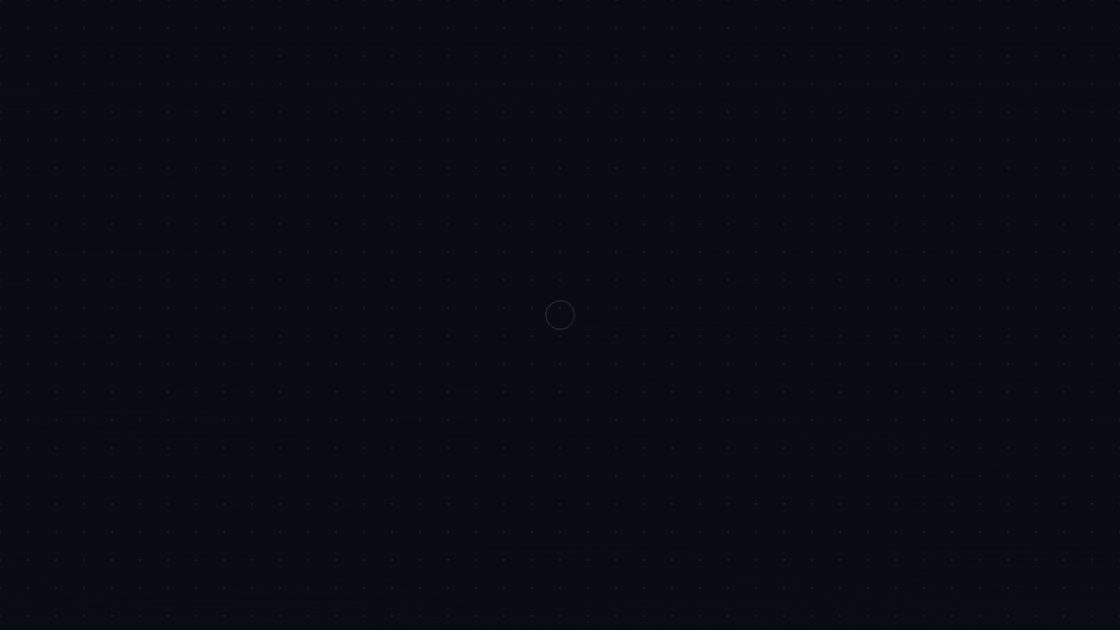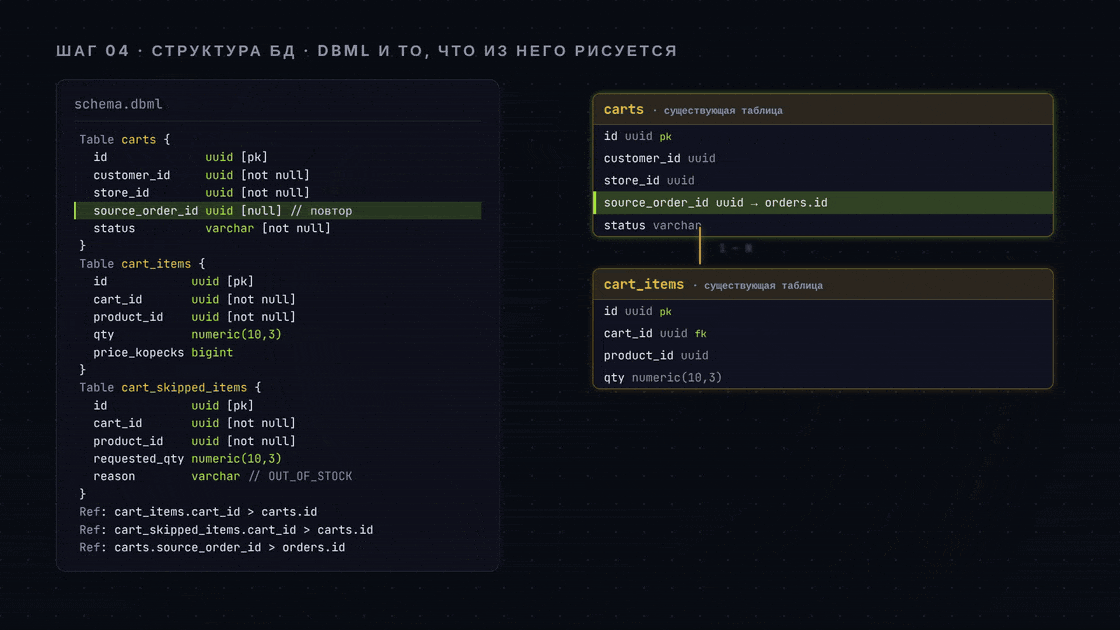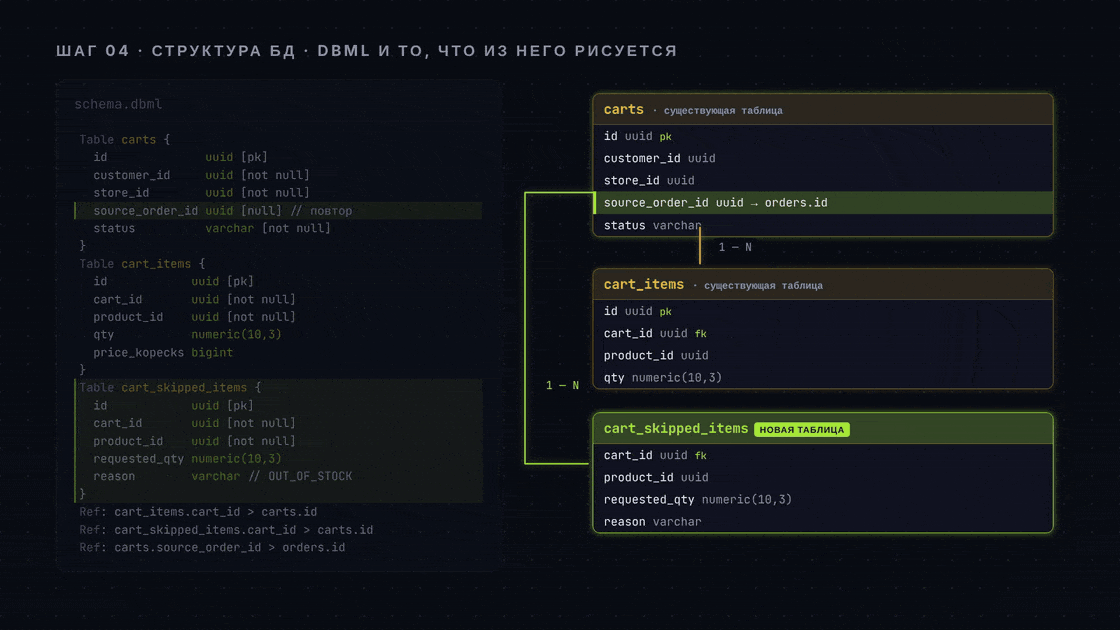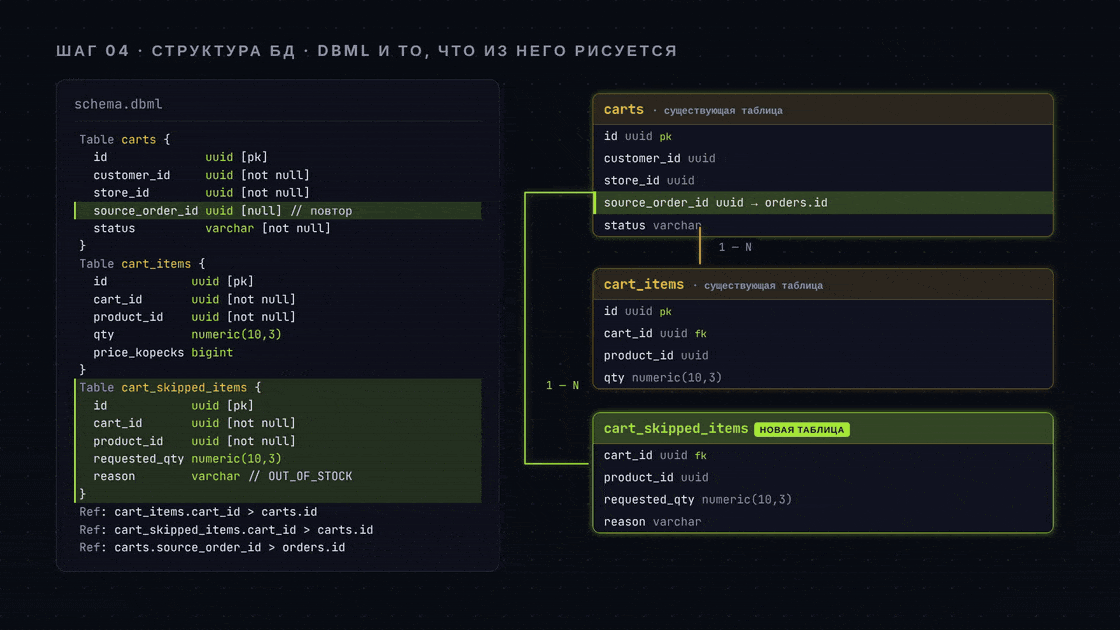
Теперь модель данных переезжает в физическую схему. Я обычно проектирую её в DBML - удобно редактировать и рендерить ER-диаграммы
Что здесь делает LLM
Генерация DBML - рутинная работа, которую модель делает быстро и точно. Ценность добавляют два требования в system prompt: соблюдение соглашений и блок про миграцию.
System prompt:
Ты — системный аналитик, проектируешь физическую схему БД
и выдаёшь её в формате DBML (dbdiagram.io).

ПРАВИЛА
1. Соблюдай соглашения проекта по типам БЕЗ ИСКЛЮЧЕНИЙ. При конфликте
   между удобством и соглашением выбирай соглашение.
2. Для каждого поля: тип, обязательность, значение по умолчанию,
   ограничения. Перечислимые значения — комментарием рядом с полем.
3. Для каждой таблицы пометь в комментарии: новая она или существующая.
   Для существующих перечисли ТОЛЬКО добавляемые поля.
4. Все связи — через Ref. Внешние ключи на таблицы вне области
   описания тоже укажи.
5. Отдельным блоком после DBML: «Миграция» — что сделать
   с существующими строками, нужен ли backfill, где потребуется
   проход по всей таблице.
6. Отдельным блоком: «Проверить у DBA» — индексы, ожидаемый рост
   объёма, потенциальные горячие точки.
7. Не используй физическое удаление строк для сущностей, участвующих
   в денежных расчётах.
8. Непонятное — в ОТКРЫТЫЕ ВОПРОСЫ, не решай сам.
User prompt:
<ПРОЕКТ>

<МОДЕЛЬ ДАННЫХ — результат шага 3 целиком>

СОГЛАШЕНИЯ ПО ТИПАМ:
- Идентификаторы — uuid.
- Деньги — bigint в копейках, суффикс поля _kopecks.
- Количество — numeric(10,3): бывают весовые товары.
- Даты — timestamptz, хранение в UTC.
- Перечисления — varchar с закрытым списком значений в комментарии.

СУЩЕСТВУЮЩИЕ ТАБЛИЦЫ, КОТОРЫЕ ТРОГАЕМ: carts, cart_items.

ЗАДАЧА
Выдай DBML для фичи повтора заказа.
Шаг 5. Солюшен-архитектура
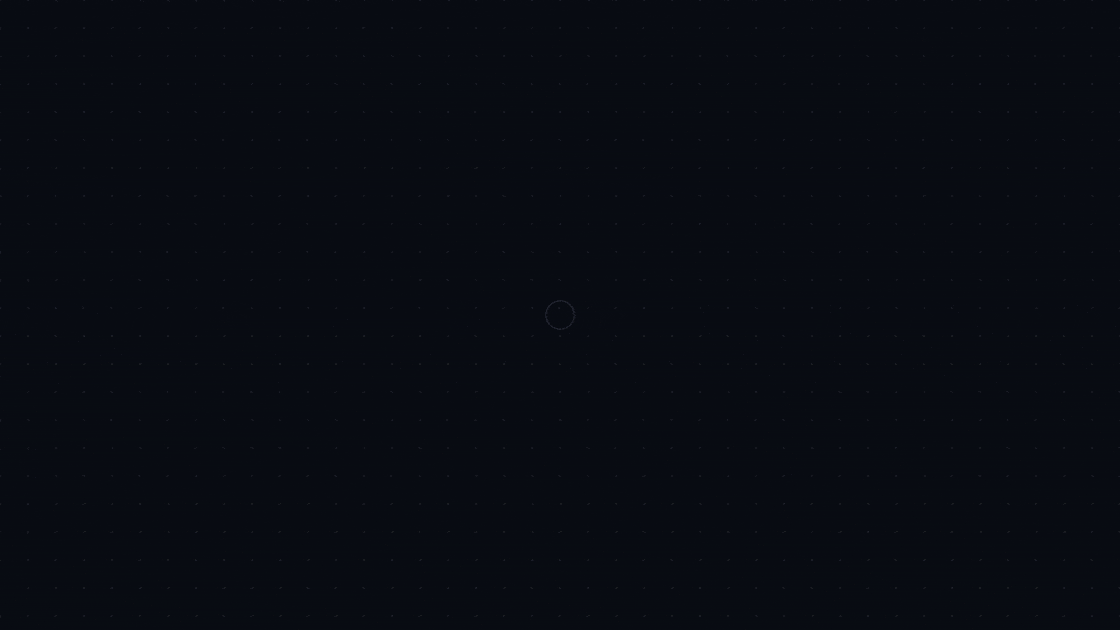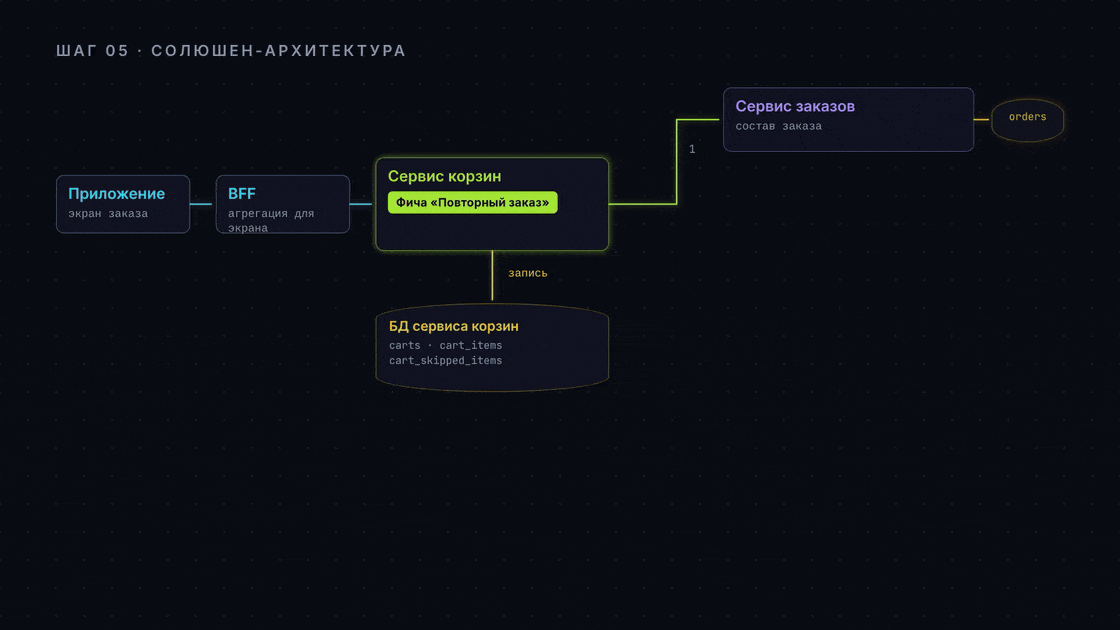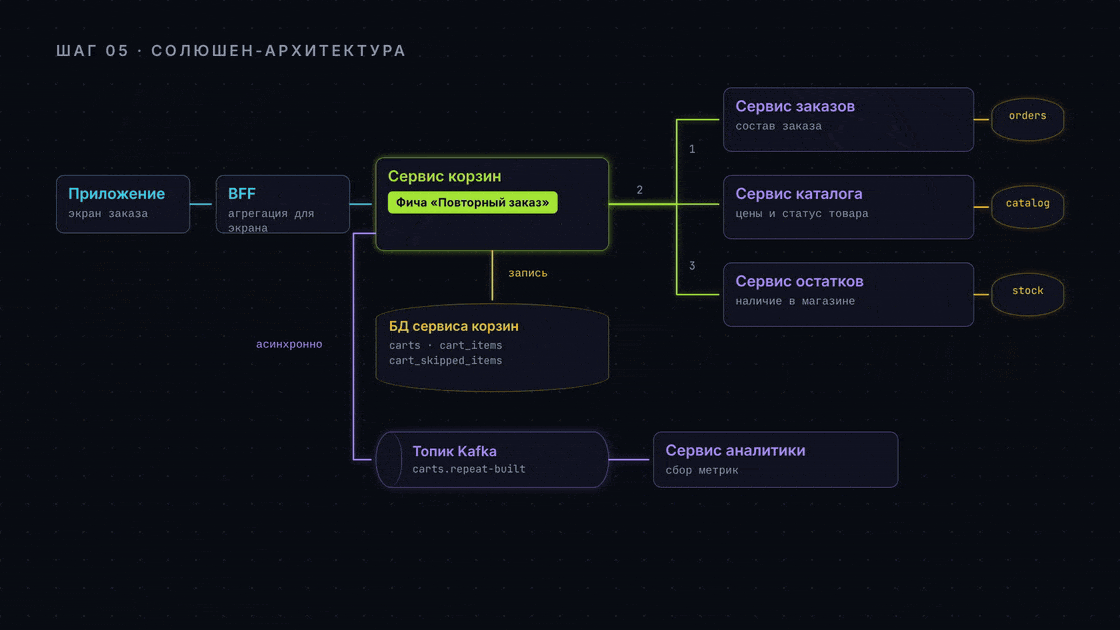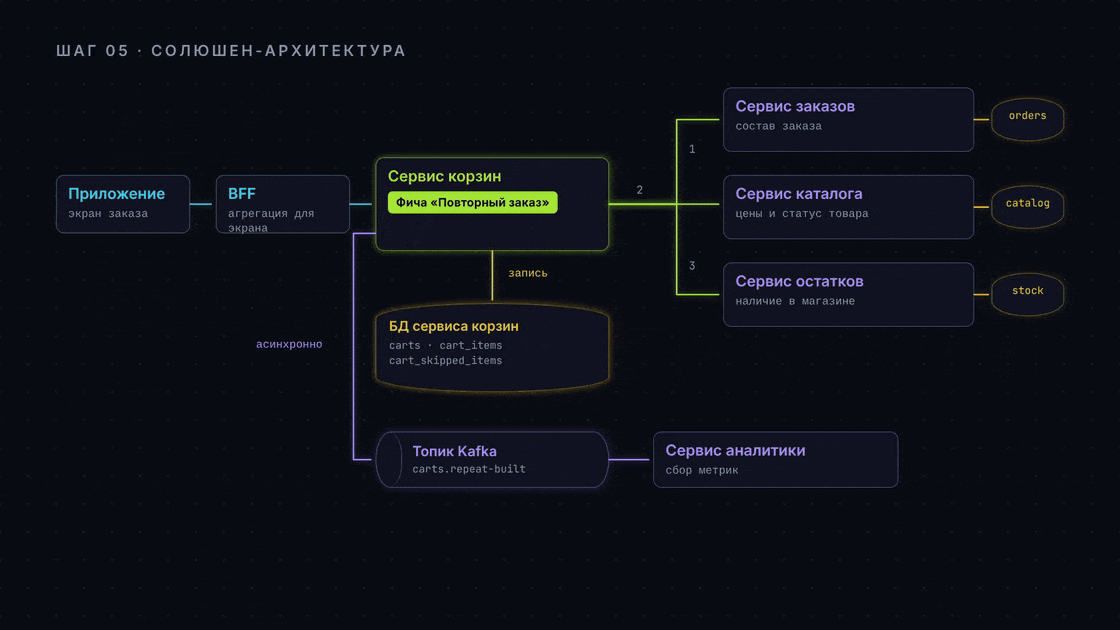
Зачем рисуем солюшен для каждой фичи? Чтобы понять окружение - какие сервисы между собой взаимодействуют и сколько из них придется дорабатывать.
В этом кейсе мы видим, что новых сервисов нам создавать не потребуется, потому что изменения будет делать в имеющемся сервисе корзины. Значит, фича не потребует межкомандных согласований и укладывается в спринт одной команды. Если бы блоков с изменениями было больше, то дополнительно встал бы вопрос про порядок доработки и последующего деплоя сервисов.
Что здесь делает LLM
Это самый рискованный шаг для модели - и промпт написан так, чтобы она не притворялась, будто знает архитектуру продукта. Иначе она может легко нагаллюцинировать вам несуществующих сервисов, интеграций и всего остального. Идеально - если вы снова на вход в пользовательском промпте будете подавать заранее выполненный ресерч (или готовый readme с архитектурой продукта или конкретной его части).
System prompt:
Ты — системный аналитик, размечаешь, в каких сервисах появится
новый код для реализации фичи.

ПРАВИЛА
1. Используй ТОЛЬКО те сервисы, которые перечислены во входных данных.
   Придумывать новые сервисы запрещено.
2. Если для реализации не хватает ответственности ни у одного
   существующего сервиса — не придумывай сервис, напиши
   «требуется решение архитектора» и опиши, какой ответственности
   не хватает.
3. Для каждого сервиса укажи: что меняется (новый код / новая таблица /
   только чтение / не меняется).
4. Для каждого взаимодействия укажи: синхронное или асинхронное,
   и что произойдёт при отказе участника.
5. Отдельным блоком: «Оценка охвата» — сколько сервисов затронуто,
   сколько команд, можно ли выкатывать независимо.
6. Не предлагай оптимизаций архитектуры: твоя задача — разметка,
   а не перепроектирование.
User prompt:
<ПРОЕКТ>

<UC ЦЕЛИКОМ>
<DBML — результат шага 4>

СУЩЕСТВУЮЩИЕ СЕРВИСЫ И ИХ ОТВЕТСТВЕННОСТЬ:
- Мобильное приложение — экраны клиента.
- BFF — агрегация данных для экранов.
- Сервис корзин — владеет корзиной и её позициями.
- Сервис заказов — владеет заказами, отдаёт состав.
- Каталог — цены по магазинам, статус товара.
- Остатки — наличие в магазине.
- Kafka — шина событий.
- Аналитика — читает события из брокера.

ЗАДАЧА
Разметь, где появится новый код для фичи повтора заказа.
Шаг 6. Sequence-диаграмма
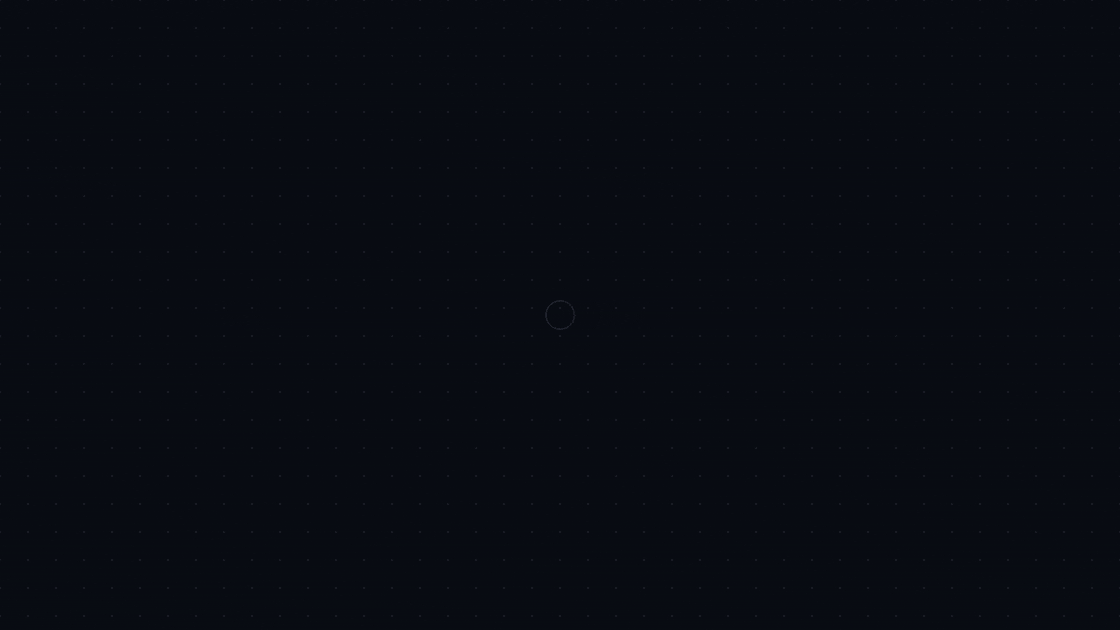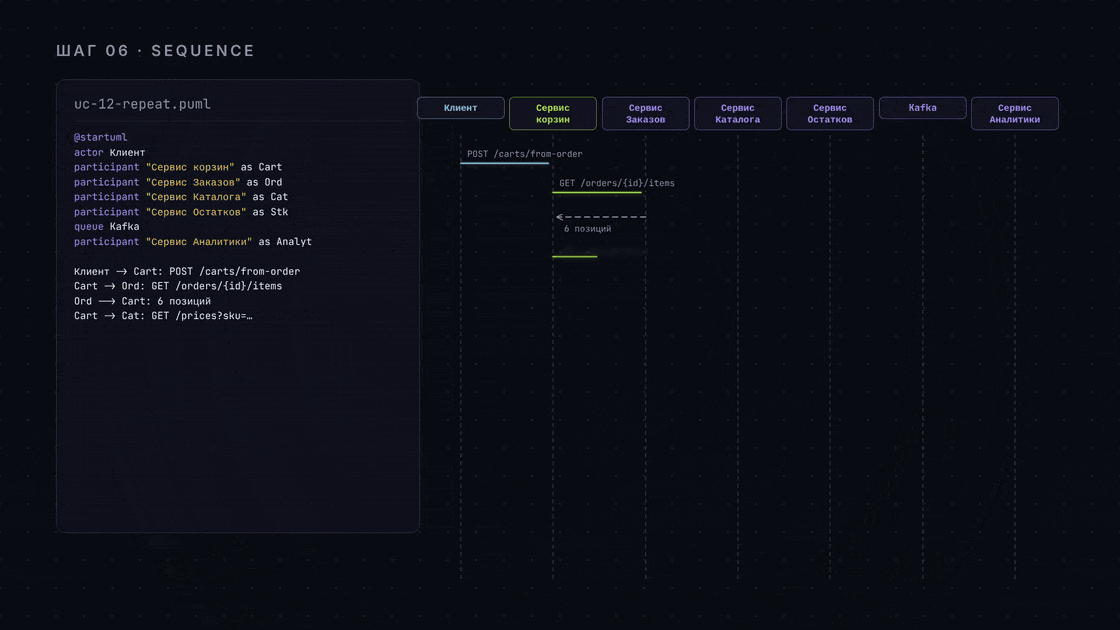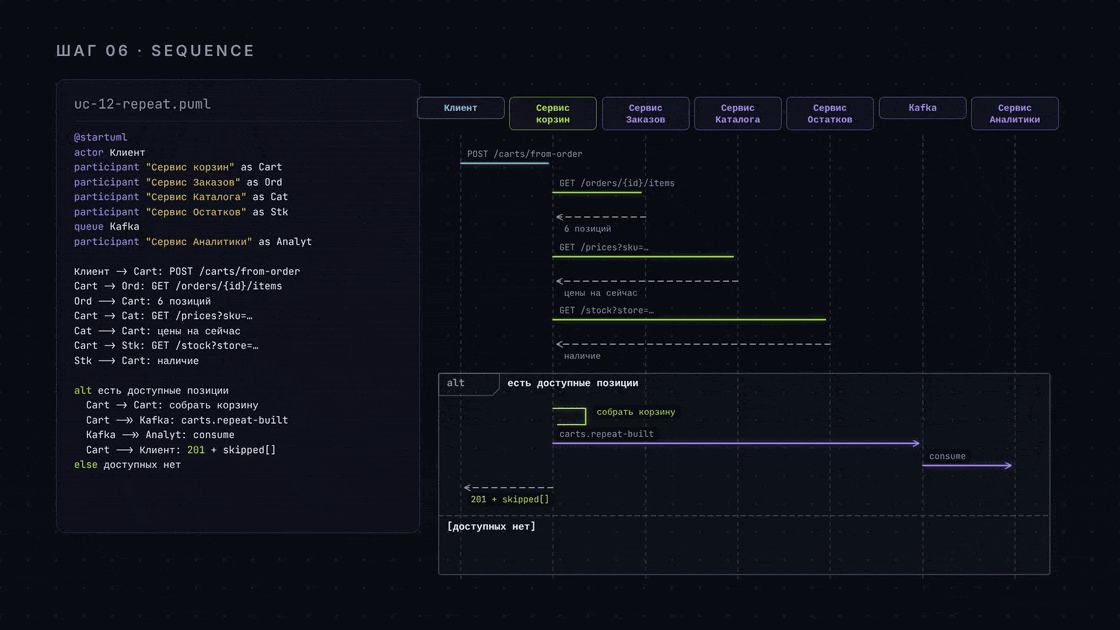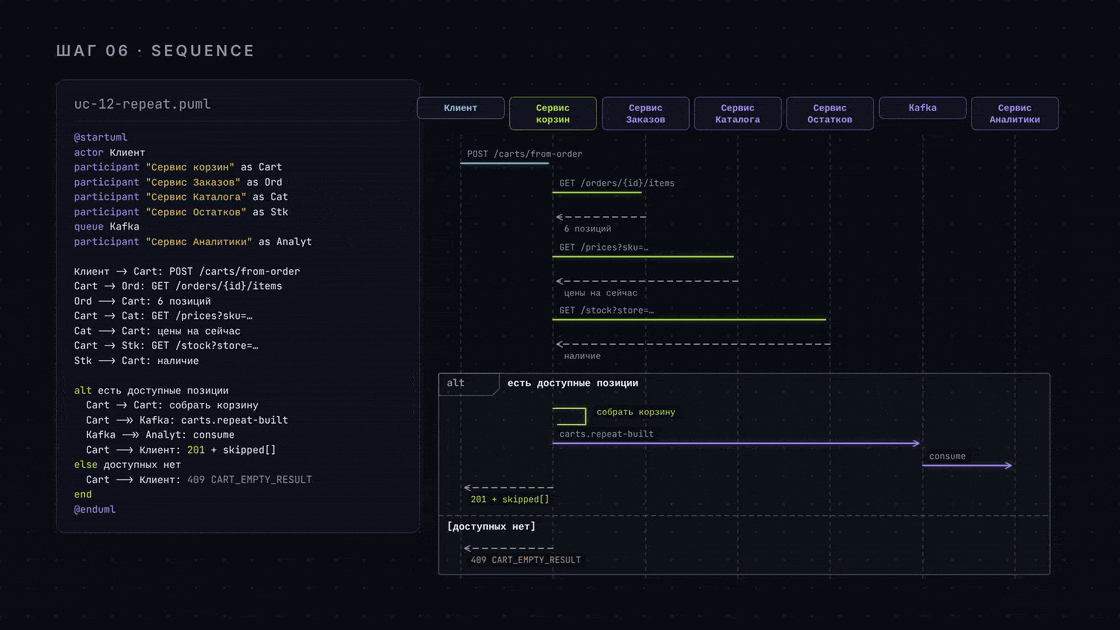
Теперь мы имеем солюшен-архитектуру и понимаем участников процесса. Чтобы быстро и понятно объясниить всем (и разработчикам) порядок взаимодействия компонентов системы в рамках фичи лучше всего будет спроектировать Sequence-диаграмму.
Для этого я использую PlantUML по той же причине, что и DBML: легко писать/изменять и рендерить в диаграмму
Что здесь делает LLM
Перевод Use Case в PlantUML модель делает отлично, но важно указать в промпте участников (технические компоненты) системы, чтобы система не начала вам рисовать бизнес-процесс или вообще не выдала архитектурно-бизнесовый микс.
System prompt:
Ты — системный аналитик, строишь sequence-диаграммы в PlantUML
по описанию сценария.

ПРАВИЛА
1. Используй ТОЛЬКО участников из предоставленного списка.
   Не добавляй и не убирай.
2. Если из сценария непонятно, какой участник выполняет шаг, —
   НЕ УГАДЫВАЙ. Поставь участника с именем ??? и вынеси вопрос
   в ОТКРЫТЫЕ ВОПРОСЫ после диаграммы.
3. Синхронный вызов — стрелка ->, ответ — -->, асинхронная
   публикация — ->>.
4. Подписывай вызовы так, чтобы были видны операция и ключевые
   данные: не «запрос», а «GET /orders/{id}/items».
5. Альтернативные ветки из расширений сценария показывай
   через alt/else.
6. Событие публикуется ПОСЛЕ фиксации изменения в хранилище.
   Если в сценарии порядок другой — отметь это как замечание.
7. Диаграмма должна быть синтаксически валидной PlantUML.
8. После диаграммы: ОТКРЫТЫЕ ВОПРОСЫ — всё, что пришлось
   домыслить о распределении ответственности.
User prompt:
<ПРОЕКТ>

<UC ЦЕЛИКОМ>
<РАЗМЕТКА СЕРВИСОВ — результат шага 5>

УЧАСТНИКИ:
actor Клиент
participant "Сервис корзин" as Cart
participant "Сервис Заказов" as Ord
participant "Сервис Каталога" as Cat
participant "Сервис Остатков" as Stk
queue Kafka
participant "Сервис Аналитики" as Analyt


ЗАДАЧА
Построй sequence-диаграмму для основного сценария UC
и расширений 4b, 5a, 6a.
Шаг 7. Контракты API
Теперь, когда у нас есть уже и архитектура и последовательность вызовов, остается спроектировать интеграцию и описать ее.
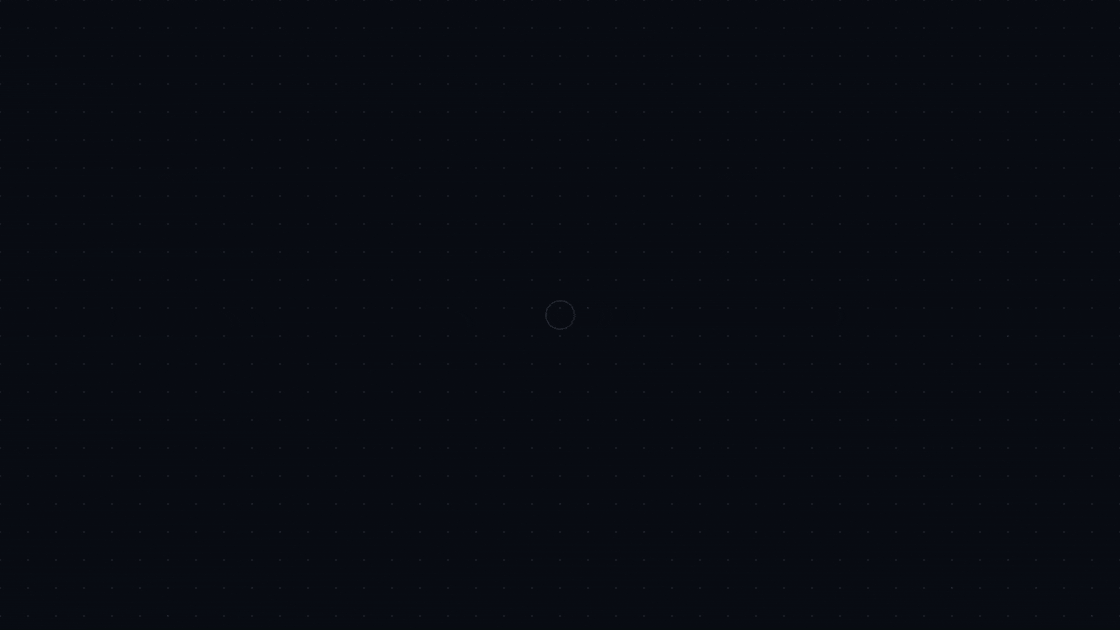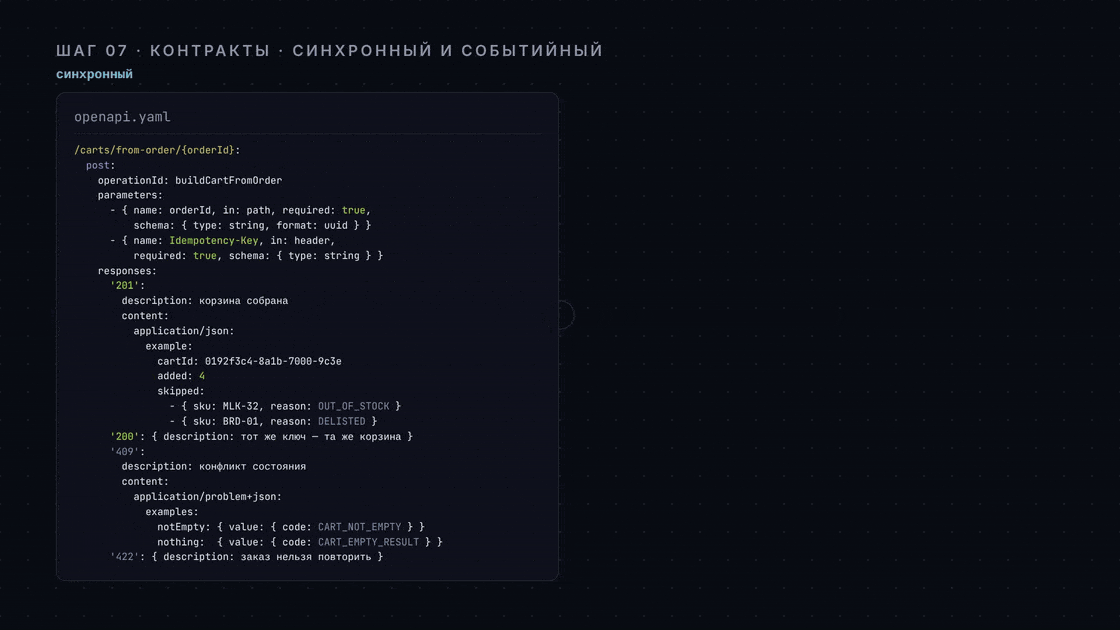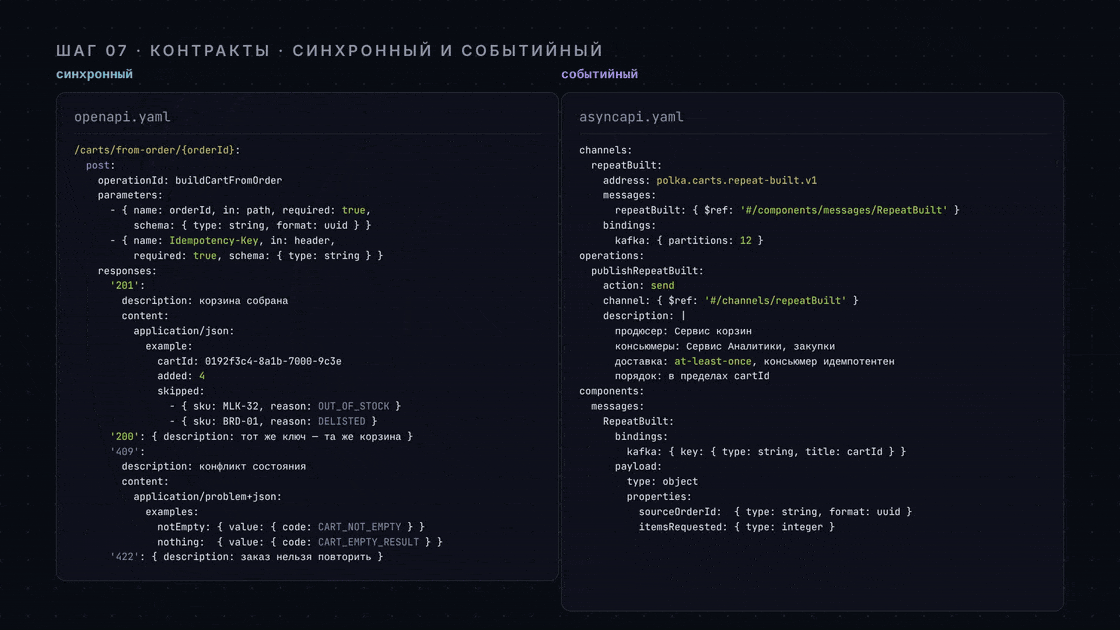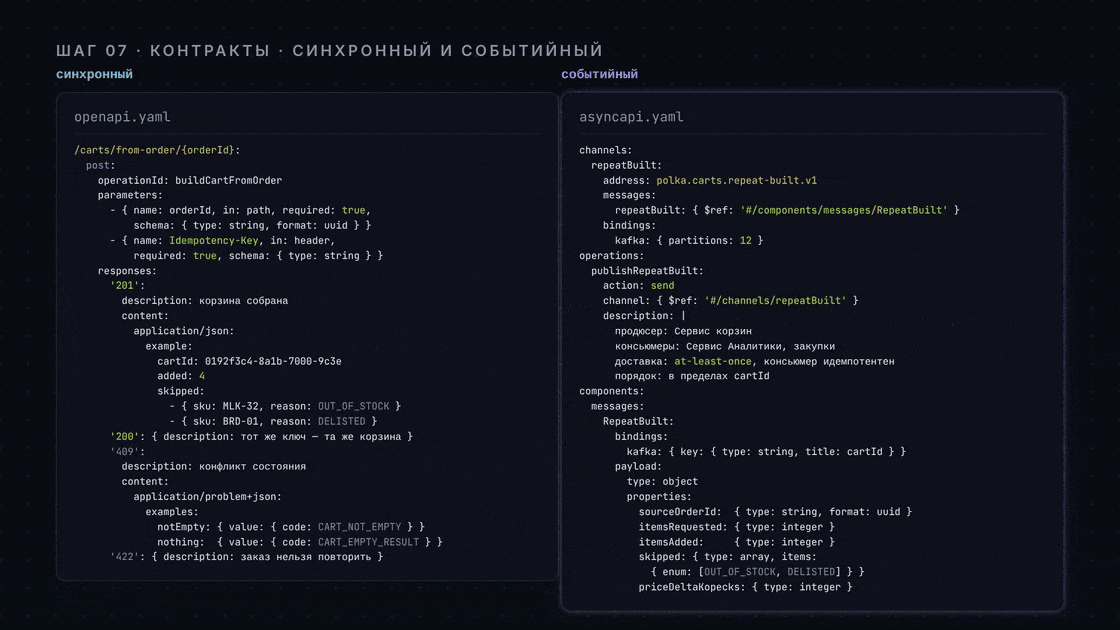
Для синхронных интеграций используем REST API и описываем с помощью OpenAPI. Для асинхронной отправки в сервис аналитики используем брокер Kafka и описываем контракт в AsyncAPI
На вход в промпт отправляем Use Case, DBML схему БД и Sequence-диаграмму и при необходимости указываем соглашения по API, принятые у вас в команде/компании.
Что здесь делает LLM
Отлично генерирует оба формата как OpenAPI так и AsyncAPI так и любые другие форматы. Ценность промпта - в том, что он заставляет модель вывести коды ответа из расширений сценария, а не из общих представлений.
System prompt:
Ты — системный аналитик, описываешь контракты интеграции.
Выдаёшь два файла: OpenAPI 3.1 и AsyncAPI 3.0.

ПРАВИЛА ДЛЯ OPENAPI
1. Каждый код ответа должен выводиться из конкретного шага или
   расширения сценария. Рядом с кодом в описании укажи, из какого.
   Код, который ниоткуда не выводится, не добавляй.
2. Коды ошибок — закрытый enum в components. Придуманные на ходу
   строки запрещены.
3. Для операций, изменяющих состояние, опиши идемпотентность:
   время жизни ключа, поведение при том же ключе и том же теле,
   поведение при том же ключе и ДРУГОМ теле.
4. Частичный успех — это успех. Если операция выполнилась не полностью,
   это код 2xx с описанием невыполненной части, а не ошибка.
5. У каждого поля есть description и пример.

ПРАВИЛА ДЛЯ ASYNCAPI
6. Для каждого канала в description обязательно: продюсер, известные
   консьюмеры, семантика доставки, что делает консьюмер при дубле,
   гарантии порядка, ключ партиционирования, политика ретенции.
7. Если какой-то из этих пунктов неизвестен — напиши TODO,
   не придумывай значение.
8. Событие публикуем только если у него есть потребитель, который
   не ждёт синхронного ответа. Для каждого предложенного события
   назови потребителя; если не можешь — не предлагай событие.

ОБЩЕЕ
9. Соблюдай соглашения проекта по формату ошибок, пагинации и деньгам.
10. Непонятное — маркером TODO в описании поля или операции.
User prompt:
<ПРОЕКТ>

<UC ЦЕЛИКОМ>
<SEQUENCE-ДИАГРАММА — результат шага 6>
<DBML — результат шага 4>

СОГЛАШЕНИЯ ПО API:
- Ошибки — RFC 7807, application/problem+json, плюс поле code из enum.
- Идемпотентность — заголовок Idempotency-Key для всех операций,
  изменяющих состояние.
- Деньги в API — строка с двумя знаками + отдельное поле currency.
- События — CloudEvents 1.0, транспорт Kafka,
  имя топика polka.<домен>.<событие>.v<версия>.

ЗАДАЧА
Опиши контракты для операции сборки корзины по прошлому заказу.
Шаг 8. Декомпозиция фичи на задачи
Финальный артефакт, если вам уж совсем лень - это разбивка фичи на задачи для фиксации в таск-трекере.
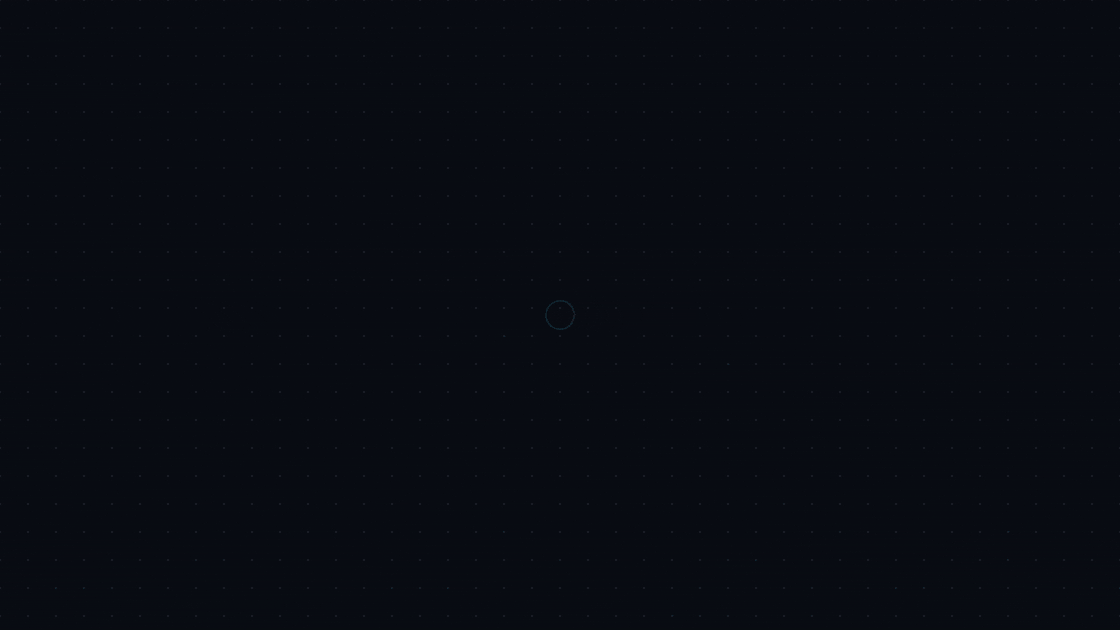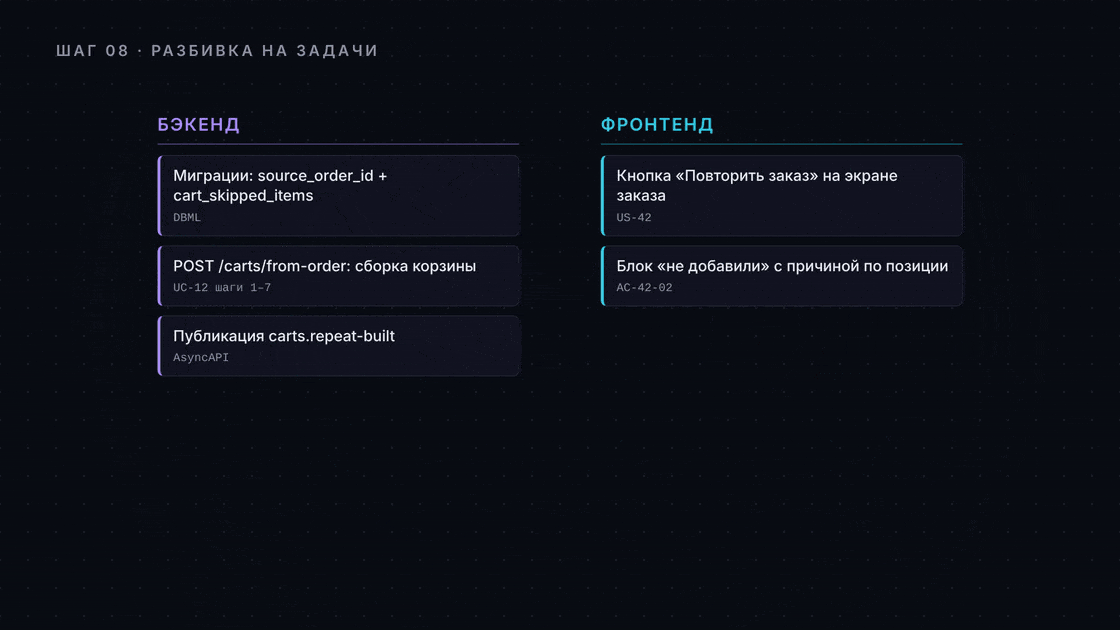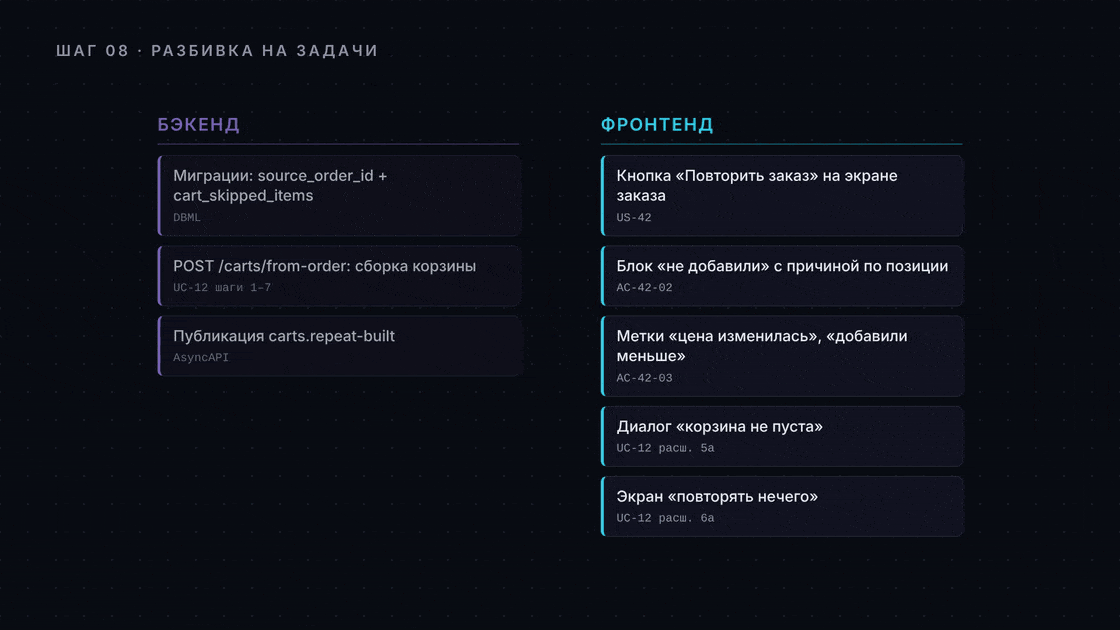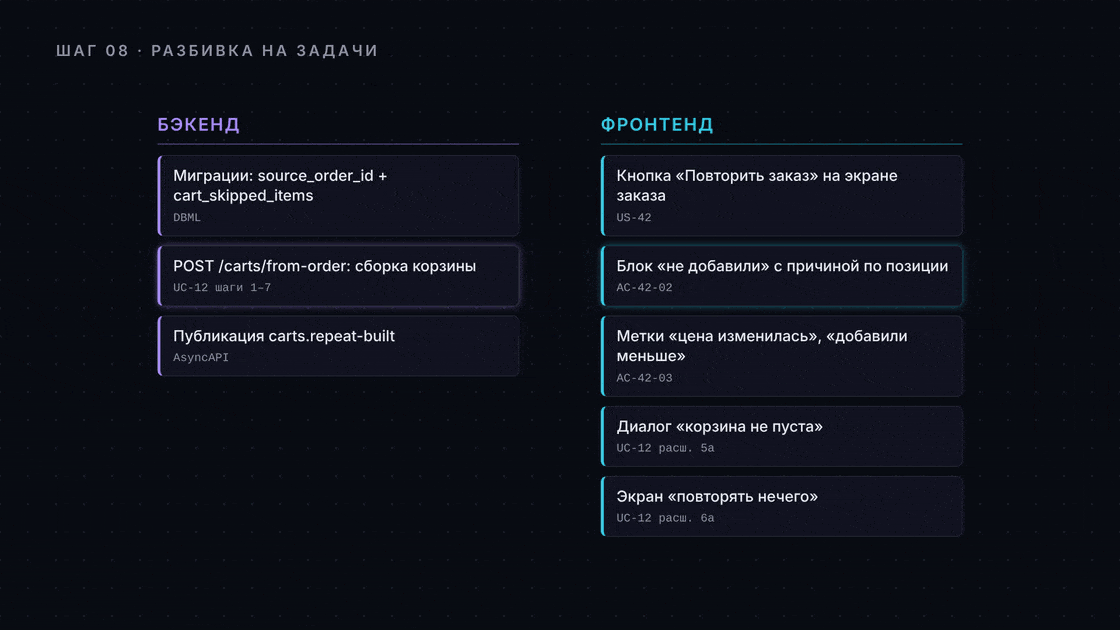
Посмотрите на подписи под карточками - каждая задача ссылается на артефакт, из которого она проистекает.
Что здесь делает LLM
Декомпозиция по артефактам - простейшая задача для LLM, а вы можете пойти сделать себе кофе
System prompt:
Ты — системный аналитик, раскладываешь спроектированную фичу
на задачи для спринта.

ПРАВИЛА
1. Каждая задача ОБЯЗАНА ссылаться на артефакт, из которого она
   выведена: номер шага UC, идентификатор критерия приёмки, таблицу
   DBML, операцию OpenAPI, канал AsyncAPI. Задача без ссылки
   не допускается — если не можешь сослаться, значит, задача лишняя
   или пропущен артефакт: напиши об этом.
2. Группируй по исполнителям: бэкенд, фронтенд, аналитика и QA.
3. Формулировка задачи — результат, а не процесс:
   «Эндпоинт сборки корзины», а не «Поработать над корзиной».
4. Оценка в story points по шкале Фибоначчи, 1–8. Задачу больше 8
   раздели.
5. Отдельным блоком: «Покрытие» — перечисли расширения сценария
   и критерии приёмки, на которые НЕ ссылается ни одна задача.
   Это дыры в декомпозиции.
6. Отдельным блоком: «Порядок» — что блокирует что.
7. Не добавляй задач на то, чего нет в артефактах: ни рефакторинга,
   ни «улучшить логирование», ни нагрузочного тестирования,
   если о них не сказано.
User prompt:
<ПРОЕКТ>

<US И КРИТЕРИИ ПРИЁМКИ>
<UC ЦЕЛИКОМ>
<DBML>
<СОЛЮШЕН АРХИТЕКТУРА>
<OPENAPI И ASYNCAPI>

ЗАДАЧА
Разложи фичу на задачи. Для каждой — исполнитель, ссылка
на артефакт, оценка.
Что остаётся человеку в современной парадигме
Качество ответа определяется данным, которые собирает и подает на вход LLM аналитик. Самый показательный шаг - пятый: разметка сервисов вышла идеальной не потому, что модель умная, а потому, что ей дали список сервисов с их зонами ответственности. Без списка она легко изобрете вам по отдельному микросервису под каждую операцию.
Узким местом работы аналитика становится продуктовый и технический ресерч и проверка результата генерации артефактов LLM. Когда артефакт генерируется за минуты, время уходит не на написание документации, а на внимательное изучение продукта/домена и ревью того, что нейронка вам сгенерила.
Еще больше материалов и личной экспертизы по системному анализу и IT-архитектуре вы сможете найти в моем Telegram-канале: Записки системного аналитика
А также у меня есть крутой гайд по профессии системного аналитика на Хабре из 5 частей.