

Недавно на хабре вышла статья Скрапинг современных веб-сайтов без headless-браузеров, и в комментариях было высказано мнение, что без headless-браузера не выйдет получить номер телефона из объявления на "авито" или "юле". Хочу это опровергнуть, ниже скрипт на python размером менее 100 строк кода, который успешно парсит "авито"
Я не являюсь специалистом по "парсингу" сайтов и это не моя работа, но не редки случаи, когда для решения моих рабочих, и не только задач, приходится это делать. Например необходимо получить баланс лицевого счета в каком-то сервисе(мобильные операторы), который не имеет для этого API или, что совсем печально, список доменов у регистратора (ещё один), который так-же не имеет API.
Как и в статье, пара комментариев из которой побудили меня написать этот пост, я тоже для использую Python и библиотеку requests. Если не удается найти "внутренний" API , то приходится подключать библиотеку BeautifulSoup. Но тут всё оказалось намного проще.
Если открыть "полную" версию сайта https://avito.ru, и попытаться скопировать номер телефона, то станет понятно, что номер телефона на сайте не написан, а нарисован. Но в мобильной версии сайта, на номер отдается текстом. Это можно проверить, если в инструментах разработчика в браузере посмотреть ответы при нажатии на кнопку "Позвонить".
Я не буду детально разбирать свой скрипт, в коде достаточно комментариев, чтоб понять что и на каком этапе происходит. Если кратко, то используется мобильная версия сайта, объявляются переменные для поиска по сайту а так-же две переменные "key" и "cookie", о них далее подробнее, потом идет процесс получения куки путем открытия главной страницы, далее запускается цикл, которые собирает id всех объявлений проходя по всем страницам. После того, как получены все объявления вторым циклом проходим по ним и получаем интересующую нас информацию.
Скриншот работы скрипта:
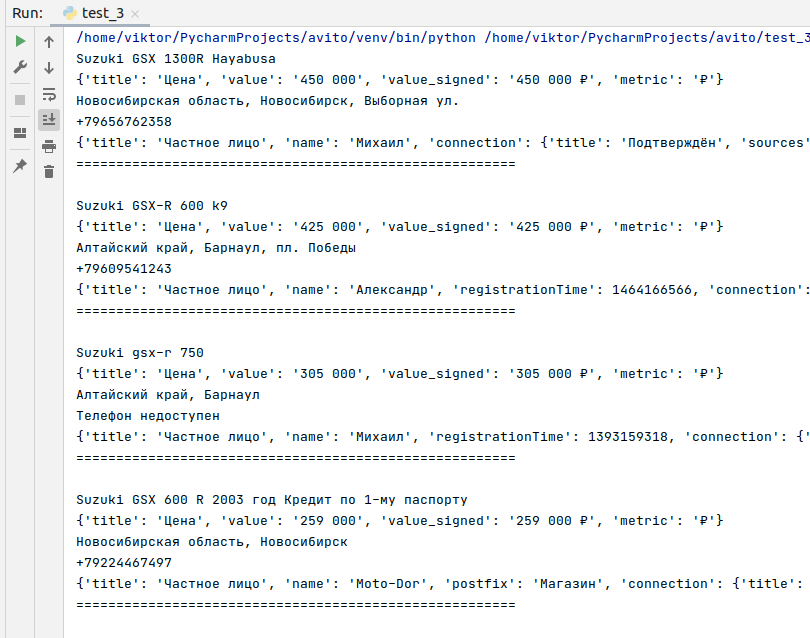
Всё так легко выглядит, т.к. были найдены нужные API. По сути данный скрипт похож на такой-же будь в нем применены официальные API. Я старался не добавлять функции или проверки ответов или обрабатывать исключения, это ведь демонстрация метода, а не боевой инструмент. Хотя несколько проверок и обработок там всё-же есть. Так-же я старался уместить скрипт в 100 строк кода.
По поводу переменных "key" и "cookie", key как я понял статичен, он легко гуглится, то-есть не генерируется на ходу. cookie же я использовал, как простой "антиблок", как оказалось вердикт, что мой IP заблокирован на самом деле не является правдой, достаточно подсунуть свежие куки и "парсинг" продолжается.
Если будет интересно, я подробнее расскажу, как я искал API или могу подобный пример написать и для "юла".
Сам скрипт


