Самым распространенным способом выполнить запрос с GROUP BY является сканирование всей таблицы или индекса и извлечение из него только уникальных значений. Существует две стратегии выполнения этого запроса.
Хэш-таблица в памяти
Этот метод обычно используется, когда запросу требуется группировать данные по колонке без индекса. В процессе группировки создается хеш-таблица, где ключи представляют уникальные значения колонок.
При выполнении запроса СУБД сканирует строки, вычисляет хеш для каждого значения в колонке, и сохраняет количество встретившихся значений для каждого элемента в хеш-таблице.
Несмотря на то, что этот метод может быть ресурсоемким для больших наборов данных, это часто самый быстрый подход, когда на сервере достаточно памяти для хранения хеш-таблицы.
Потоковая агрегация
Потоковая агрегация используется, когда данные, которые нужно сгруппировать, уже отсортированы. В этом случае, движку базы данных не надо хранить все данные в памяти, а достаточно лишь сравнивать текущее значение с предыдущим в процессе сканирования.
Если текущая строка принадлежит той же группе, движок базы данных увеличивает количество встретившихся значений на один. Если же значения различаются, то начинается новая группа, а агрегированный результат предыдущей группы проходит в плане выполнения в следующий оператор.
Потоковая агрегация использует меньше памяти по сравнению с хэш таблице, но требует сортировки данных, что может потребовать дополнительной операции сортировки, если данные еще не отсортированы в плане выполнения перед этапом агрегации.
Однако обе эти стратегии все еще требуют полного сканирования колонки, и есть лучшая стратегия при работе со столбцами с низкой кардинальностью (когда количество уникальных значений в столбце сильно меньше общего количества строк), которой нет у PostgreSQL и MS SQL Server, но есть у MySQL.
Что такое Loose Scan?
Loose Scan - это техника оптимизации в MySQL, которая хорошо применима для операций GROUP BY, особенно в сценариях, где количество уникальных значений в стобце относительно небольшое количество по сравнению с общим числом строк в таблице.
Эта техника значительно улучшает производительность запросов, уменьшая количество данных, которое требуется прочитать из базы данных.
Основной принцип Loose Scan
В сущности, техника Loose Scan работает по простому принципу: вместо сканирования всего индекса (так называемого "tight scan"), она выбирает только первое значение для каждой группы. После этого она немедленно переходит к следующей группе. Для этого обязательно нужен индекс, чтобы уметь быстро переходить к следующему значению.
Этот метод обеспечивает снижение количества строк, которые нужно оценивать, тем самым сокращая общее время, необходимое для выполнения запроса.
Помимо MySQL, подобная техника также реализована в других движках баз данных. Она называется "Skip Scan" в Oracle, SQLite и CockroachDB, "Jump Scan" в DB2, и "Hybrid Scan" в YugabyteDB.
Настройка тестового окружения
Думаю, теории было достаточно; перейдем к практической части и проведем сравнительный анализ техники Loose Scan в MySQL по сравнению с перебором всех значений в PostgreSQL и Microsoft SQL Server. Я буду использовать последние версии Docker контейнеров MySQL 8.0.33, PostgreSQL 15.3 и MS SQL 2022-CU4 на своем ноутбуке.
Я создам одну таблицу с 1 миллионом строк и тремя столбцами целочисленного типа с разной кардинальностью. В первом столбце 100 тысяч уникальных значений, во втором 1 тысяча, а в третьем всего 10 уникальных значений.
Также я добавлю три отдельных некластеризованных индекса и выполню запросы GROUP BY для каждого столбца. Каждый запрос перед замером времени будет выполнен 5 раз, чтобы "прогреть" базу данных, а затем еще 20 раз с замером времени выполнения, и после этого мы сравним среднее время выполнения.
Таким образом, я постарался поставить все движки баз данных в примерно равные условия. Вот скрипт, который я использовал для инициализации образцовых таблиц во всех базах данных:
-- MySQL
create table numbers (
  id int not null
);

insert into numbers(id)
with tmp as (
  select a.id + b.id * 10 + c.id * 100 + d.id * 1000 as id
  from (select 0 as id union all select 1 union all select 2 union all select 3 union all select 4 union all select 5 union all select 6 union all select 7 union all select 8 union all select 9) as a
  cross join (select 0 as id union all select 1 union all select 2 union all select 3 union all select 4 union all select 5 union all select 6 union all select 7 union all select 8 union all select 9) as b
  cross join (select 0 as id union all select 1 union all select 2 union all select 3 union all select 4 union all select 5 union all select 6 union all select 7 union all select 8 union all select 9) as c
  cross join (select 0 as id union all select 1 union all select 2 union all select 3 union all select 4 union all select 5 union all select 6 union all select 7 union all select 8 union all select 9) as d
)
select id from tmp;

create table group_by_table (
  id int not null,
  a int not null,
  b int not null,
  c int not null,

  primary key (id)
);

insert into group_by_table(id, a, b, c)
with tmp as (
  select
    a.id + b.id * 10000 as id
  from numbers as a
  cross join numbers as b
)
select
  id,
  floor(rand() * 100000) as a,
  floor(rand() * 1000) as b,
  floor(rand() * 10) as c
from tmp
where id < 1000000;

create index idx_group_by_table_a on group_by_table(a);
create index idx_group_by_table_b on group_by_table(b);
create index idx_group_by_table_c on group_by_table(c);

-- PostgreSQL
create table group_by_table
(
  id int not null,
  a int not null,
  b int not null,
  c int not null,

  primary key (id)
);

insert into group_by_table(id, a, b, c)
select
  id,
  floor(random() * 100000) as a,
  floor(random() * 1000) as b,
  floor(random() * 10) as c
from generate_series(1, 1000000, 1) as numbers(id);

create index idx_group_by_table_a on group_by_table(a);
create index idx_group_by_table_b on group_by_table(b);
create index idx_group_by_table_c on group_by_table(c);

-- MS SQL Server
create table group_by_table
(
  id int not null,
  a int not null,
  b int not null,
  c int not null,

  primary key clustered (id)
);

with tmp as (
  select
    row_number() over (order by (select 1)) - 1 as id
  from sys.all_columns as a
  cross join sys.all_columns as b
)
insert into group_by_table(id, a, b, c)
select
  id,
  floor(rand(checksum(newid())) * 100000) as a,
  floor(rand(checksum(newid())) * 1000) as b,
  floor(rand(checksum(newid())) * 10) as c
from tmp
where id < 1000000;

create nonclustered index idx_group_by_table_a on group_by_table(a);
create nonclustered index idx_group_by_table_b on group_by_table(b);
create nonclustered index idx_group_by_table_c on group_by_table(c);
Запросы, используемые для сравнения производительности движков баз данных:
select count(*) from (select a from group_by_table group by a) as tmp; -- ~ 100 thousand unique values
select count(*) from (select b from group_by_table group by b) as tmp; -- 1000 unique values
select count(*) from (select c from group_by_table group by c) as tmp; -- 10 unique values
Результаты
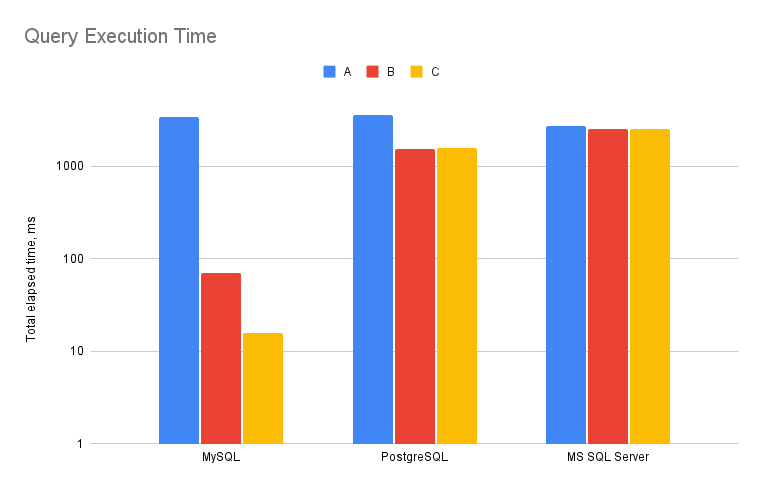
Все базы данных показывают примерно одинаковые результаты на столбце A, где кардинальность данных высока (100 тысяч уникальных значений из 1 миллиона строк). Общее время выполнения PostgreSQL составило 3.57 секунды, MS SQL Server - 2.72 секунды, а MySQL - 3.44 секунды.
Но в столбце B, где кардинальность составляет всего 1000 уникальных значений, общее время выполнения MySQL сокращается до 70.76 миллисекунд, в то время как PostgreSQL делает это за 1.56 секунды, а MS SQL Server за 2.52 секунды.
Таким образом, MySQL выполняет второй запрос в 22 раза быстрее, чем PostgreSQL, и в 35 раз быстрее, чем MS SQL Server.
Ситуация еще интереснее в столбце C, где всего 10 уникальных значений: MySQL - 16.66мс, PostgreSQL - 1.58с и MS SQL Server - 2.55с.
В последнем примере MySQL работает невероятно быстро и превосходит PostgreSQL почти в 95 раз, а MS SQL Server - более чем в 150 раз.
Ниже представлена визуализация на логарифмической шкале. Она показывает общее время выполнения после 20 выполнений.
Что можно сделать в MS SQL и PostgreSQL для улучшения производительности?
Хотя в настоящее время в PostgreSQL и MS SQL Server отсутствует такая оптимизация, есть трюк, который вы можете использовать для улучшения производительности ваших запросов GROUP BY в этих СУБД. Идея заключается в том, чтобы выполнить несколько поисков в индексе, вместо того чтобы полагаться на полное сканирование индекса по умолчанию.
Например, в PostgreSQL вы можете выполнить рекурсивный запрос, чтобы найти все уникальные значения. Первая итерация выбирает минимальное значение из столбца, а каждая последующая итерация выбирает следующее значение, большее предыдущего.
with recursive t as (
   select min(a) as x from group_by_table
   union all
   select (select min(a) from group_by_table where a > t.x)
   from t where t.x is not null
)
select count(*)
from (
    select x from t where x is not null
    union all
    select null where exists (select 1 from group_by_table where a is null)
) as tmp;
Мы можем использовать тот же трюк и в MS SQL Server. Но, к сожалению, рекурсивные запросы MS SQL Server не поддерживают операторы TOP или агрегации, поэтому я буду использовать временную таблицу для хранения результата и итерации с использованием LOOP.
Это, конечно, требует больше накладных расходов, но, похоже, нет другого общего способа выполнить такую оптимизацию в SQL Server.
create table #result (x int);
declare @current int;

select top (1) @current = a from group_by_table order by a;
while @@rowcount > 0
begin
    insert into #result values (@current);
    select top (1) @current = a from group_by_table where a > @current order by a;
end;

select count(*) from #result;
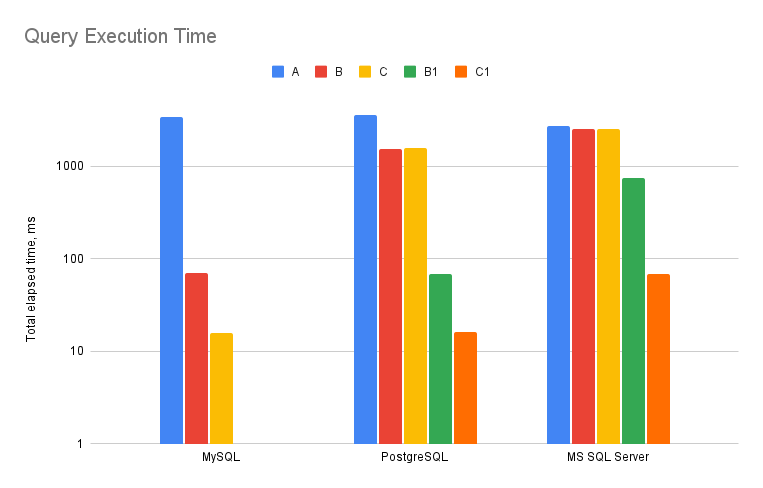
Теперь давайте сравним, как эти модифицированные запросы работают по сравнению с оригиналом и MySQL. Я буду обозначать модифицированные запросы как A1, B1 и C1 к соответствующим столбцам. Вот таблица с полными результатами.
A | A1 | B | B1 | C | C1 | |
MySQL | 3.44s | 70.76ms | 15.66ms | |||
PostgreSQL | 3.57s | 6.27s | 1.56s | 68.90ms | 1.58s | 16.02ms |
MS SQL Server | 2.72s | 68.07s | 2.52s | 745.07ms | 2.55s | 68.76ms |
ВремВыводы
Результаты весьма очевидны, Loose Scan - отличная оптимизация, которая значительно сокращает количество строк, выбираемых для запросов GROUP BY или DISTINCT при использовании индекса.
Хотя PostgreSQL позволяет вам писать сложные рекурсивные запросы для обработки столбцов с низкой кардинальностью почти с такой же эффективностью, как в MySQL, он имеет значительное ухудшение на столбце A, где кардинальность высока. Поэтому нужно точно знать распределение данных в столце прежде чем применять модифицированный запрос.
MS SQL Server работает лучше других на столбце A, но явно хуже в любых других случаях, хотя, конечно, некоторые обходные пути все равно лучше оригинального запроса.
Очень надеюсь, что PostgreSQL и MS SQL Server реализуют оптимизацию Skip Scan в какой-то момент в следующих версиях.