Недавние достижения в области генерации изображений на основе искусственного интеллекта, возглавляемые диффузионными моделями, такими как Glide, Dalle-2, Imagen и Stable Diffusion, взяли мир “искусственного интеллекта” штурмом. Создание высококачественных изображений на основе текстовых описаний - сложная задача. Это требует глубокого понимания основного значения текста и способности генерировать изображение, соответствующее этому значению.В последние годы диффузионные модели стали мощным инструментом для решения этой проблемы.
Эти модели позволяют невероятно легко создавать высококачественные изображения в различных стилях, используя всего несколько слов. Например, мы создали изображение ниже, просто предоставив подсказку:
“дом в лесу, темная ночь, листья в воздухе, флуоресцентные грибы, четкий фокус, очень четкая, очень подробная, контрастная, яркая, цифровая живопись”


В этой статье рассмотрим следующие темы в понятной и простой форме, понятной для любого новичка в захватывающем мире диффузионных моделей для генерации изображений.
Кратко обсудим пространство моделей генерации изображений на основе глубокого обучения, а также плюсы и минусы различных используемых методов.
Объясним в простых терминах, что такое “диффузия” и как работают диффузионные модели.
Представим высокоуровневый обзор четырех наиболее популярных диффузионных моделей:
Dall-E 2 от OpenAI
Imagen от Google
StabilityAI’s Stable Diffusion
Midjourney
Наконец, обсудим некоторые приложения и веб-сайты, которые предоставляют услуги, связанные с диффузионными моделями, или используют диффузионные модели в качестве сервиса.
Содержание
Что такое генеративные модели?
Что такое диффузия?
Что такое диффузионные модели?
Как работают диффузионные модели генерации изображений?
Сравнение с GaN
Хорошо известные диффузионные модели для генерации изображений
DALL-E 2
Imagen
Stable Diffusion
Midjourney
Популярные варианты стабильных диффузионных моделей
Anything V3
Robo Diffusion
Open Journey
Arcane Diffusion
Mo-Di Fusion
Применение диффузионных моделей
Textual Inversion
Text To Videos
Text To 3D
Text To Motion
Image To Image
Image Inpainting
Image Outpainting
Infinite Zoom In & Zoom Out
Image Search & Reverse Image Search
Инструменты
Для локальной и Colab установки
Для онлайн-тестирования
Краткие сведения
Что такое генеративные модели?
Большинство задач машинного обучения и глубокого обучения, которые вы решаете, концептуализируются из Генеративных и дискриминационных модели. Проще говоря, “генеративные модели” - это статистические модели, предназначенные для “генерации / синтеза данных”. Их задача состоит в том, чтобы “преобразовать шум в репрезентативную выборку данных”.
На протяжении многих лет мы видели много творческих применений генеративных моделей. Одним из конкретных приложений, которое большинство из нас помнит, была реклама Cadbury, в которой использовались Генерация звука и синхронизация по губам составить карту выражения лица и речи различных знаменитостей. Его можно использовать для создания персонализированной рекламы знаменитостей.
Четыре хорошо известные модели генерации изображений, основанные на глубоком обучении::
Вариационные автоэнкодеры (VAE)
Flow-based models
Генеративные состязательные сети (GAN).
Diffusion (недавняя тенденция)

Эти модели сначала обучаются, чтобы научиться моделировать “распределение данных” (обучающих данных). После обучения модель знает, как аппроксимировать исходное распределение данных, и может использовать его для генерации новых данных (изображений) по желанию.
Предшественником понимания “Variational Autoencoders” являются “Autoencoders”. Основной задачей автоэнкодеров является сжатие данных. Архитектура автоэнкодеров довольно проста. Оно содержит три компонента:
Кодировщик
Узкое место (ответственное за сжатие)
Декодер
Дополнительным преимуществом этой конструкции является то, что мы можем использовать Автоэнкодеры для шумоподавления изображения.
В автоэнкодерах распределение сжатых данных / скрытых данных “без ограничений”. Данные сжимаются таким образом, что ошибка восстановления минимальна. Это приводит к серьезному недостатку, т.е. потому, что у нас нет представления / информации о распределении скрытого, поэтому генерировать новые выборки (используя только декодер) сложно.
В вариационных автоэнкодерах это больше не проблема. К уровню узких мест добавляется ограничение, поэтому сжатые данные кодера должны максимально точно имитировать (простое, подобранное вручную) распределение вероятностей (обычно стандартное гауссово). Чтобы сгенерировать новые выборки, мы можем просто выбрать точку из выбранного распределения вероятностей и передать ее в декодер.
На момент написания статьи мы все еще не определились с единой моделью для всех задач, связанных с генеративным моделированием, и это справедливо. В каждой области применения есть свои проблемы, и люди обычно используют различные методы для их решения. Все четыре вышеперечисленные модели имеют проблемы, которые хорошо иллюстрируются на gif ниже.
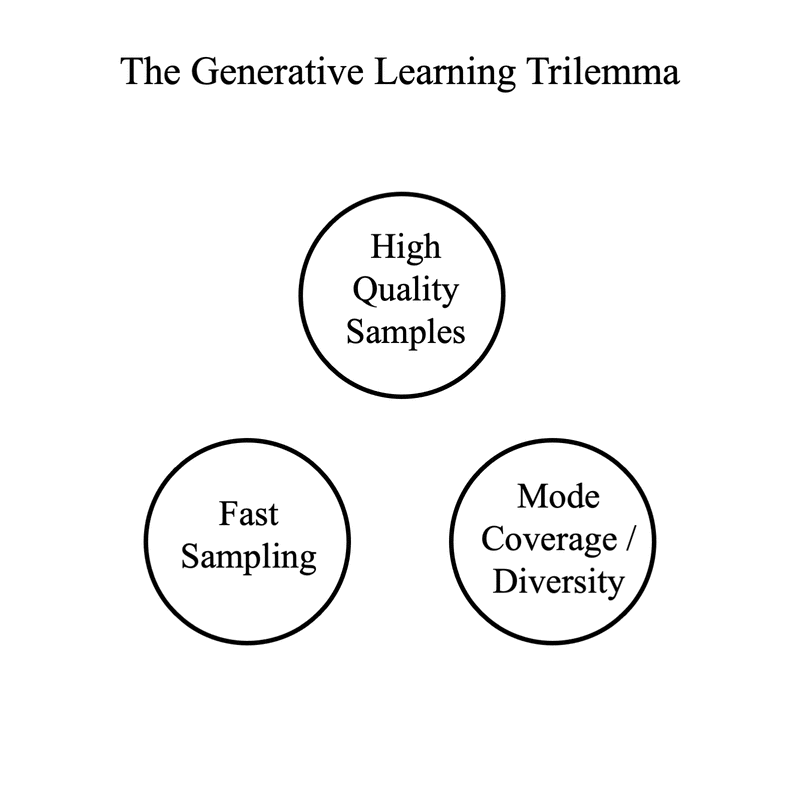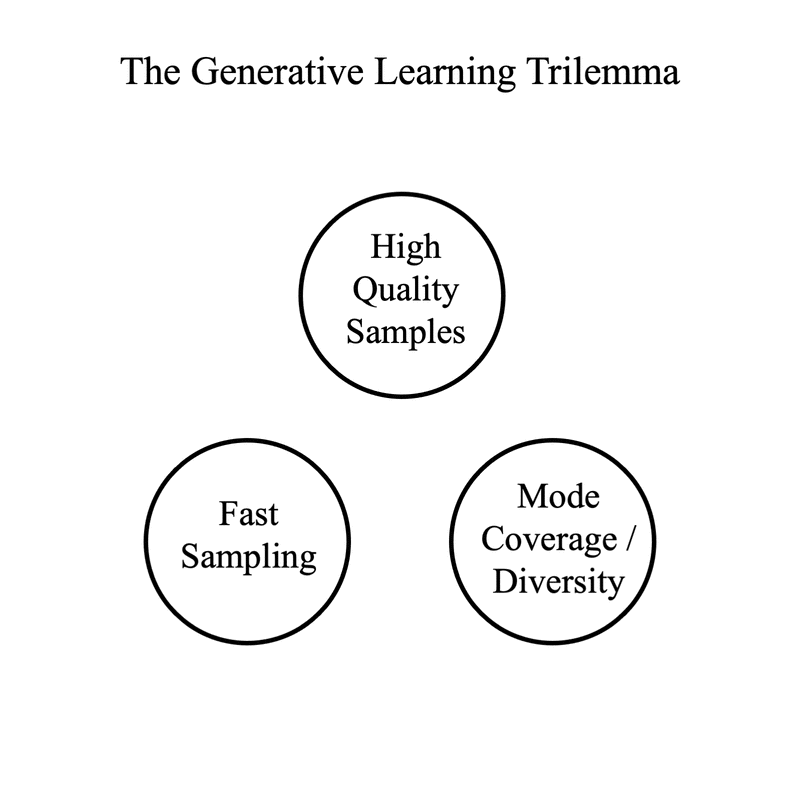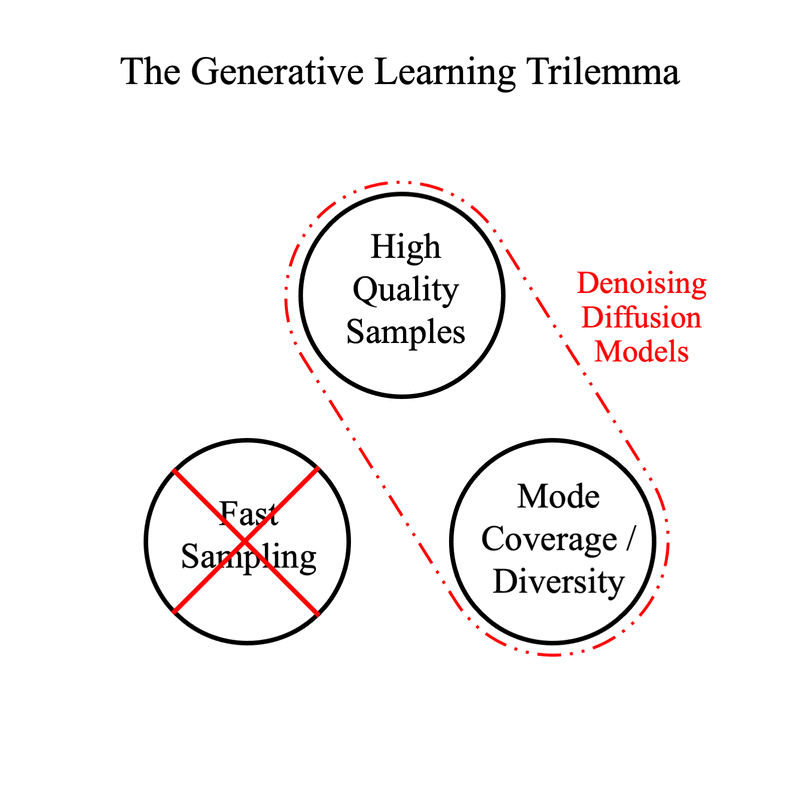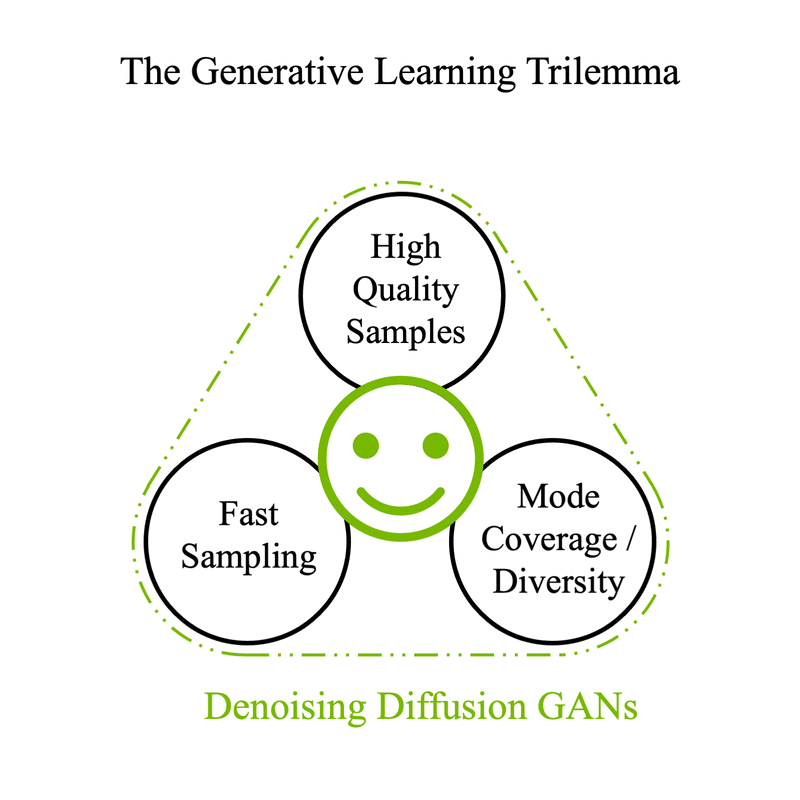
Подводя итог:
VAE | Поток | GAN | Диффузия | |
Плюсы | Высокая частота дискретизации. Генерация разнообразных образцов | Высокая частота дискретизации. Генерация разнообразных образцов | Высокая частота дискретизации.Высокое качество генерации образцов. | Высокое качество генерации образцов.Генерация разнообразных образцов |
Минусы | Низкое качество генерации выборки | Требуется специализированная архитектура,низкое качество генерации выборки | Нестабильное обучение,низкое разнообразие генерации выборки(коллапс режима) | Низкая частота дискретизации |
Созданные в 14 году Иэном Гудфеллоу генеративные состязательные сети (GAN) были в значительной степени нормой для генерации образцов изображений.
Было создано множество вариаций оригинального GAN, таких как:
Условный GAN (cGAN): управление классом / категорией генерируемых изображений.
Глубокая сверточная GAN (DCGAN): архитектура значительно улучшает качество GAN с использованием сверточных слоев.
Преобразование изображения в изображение с помощью Pix2Pix: преобразование изображений из одного домена в другой путем изучения сопоставления между входом и выходом.
Сейчас, в эпоху диффузионных моделей, исследователи обязательно используют знания, накопленные за годы работы над GaN. Это одна из основных причин такого быстрого прогресса в диффузионных моделях за такой короткий промежуток времени.
Что такое диффузия?
Прежде чем мы разберемся с диффузионными моделями, давайте быстро разберемся в значении термина “диффузия”. Диффузия (или диффузионный процесс) является хорошо известной и изученной областью неравновесной статистической физики.
В неравновесной статистической физике процесс диффузии относится к:
“Перемещение частиц или молекул из области высокой концентрации в область низкой концентрации, обусловленное градиентом концентрации”.
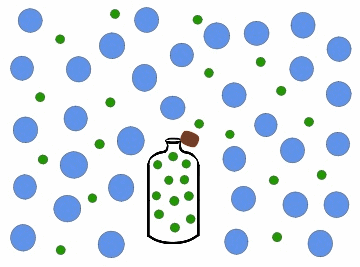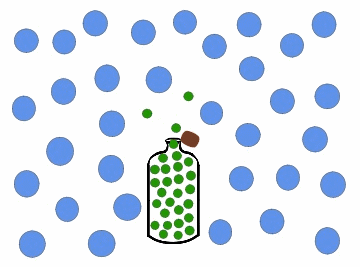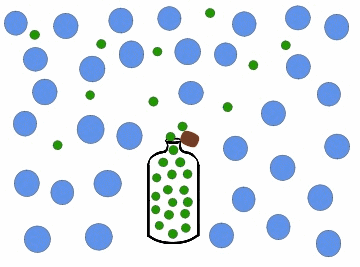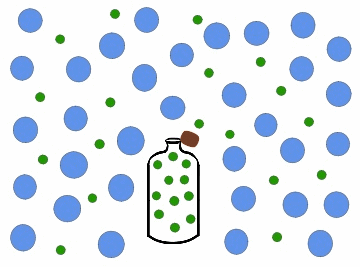
Процесс диффузии обусловлен случайным движением частиц или молекул, описываемым законами термодинамики и статистической механики.
Что такое диффузионные модели?
В простых терминах – “Диффузионные модели представляют собой класс вероятностных генеративных моделей, которые превращают шум в репрезентативную выборку данных”.
Используя диффузионные модели, мы можем генерировать изображения как условно, так и безоговорочно.
Безусловная генерация изображений просто означает, что модель преобразует шум в любую “случайную репрезентативную выборку данных”. Процесс генерации не контролируется и не управляется, и модель может генерировать изображение любого характера.
Условная генерация изображений - это когда модели предоставляется дополнительная информация с помощью текста (text2img) или меток классов (как в CGANs). Это случай управляемой или управляемой генерации изображений. Предоставляя дополнительную информацию, мы ожидаем, что модель будет генерировать определенные наборы изображений. Например, вы можете обратиться к двум изображениям в начале сообщения.
В этом разделе мы сосредоточимся на процессе “безусловной генерации изображений”.
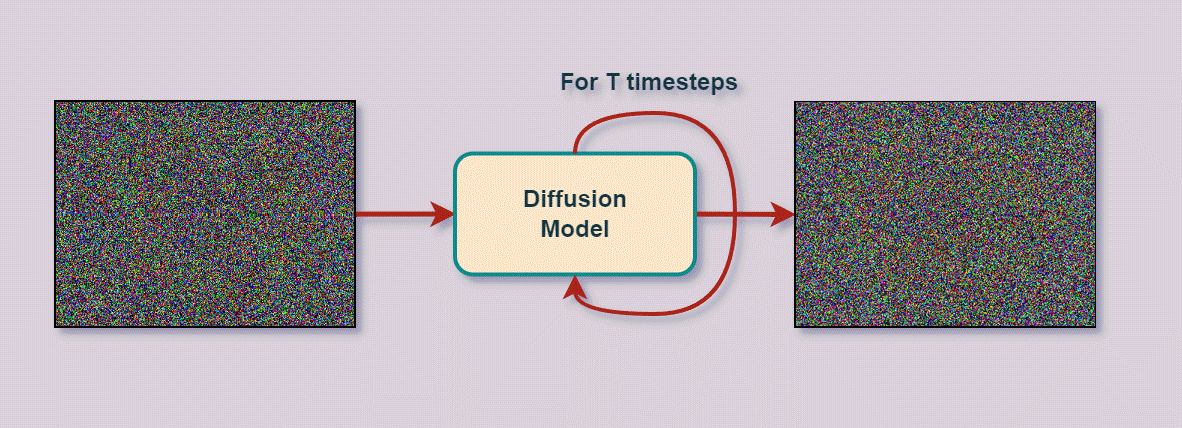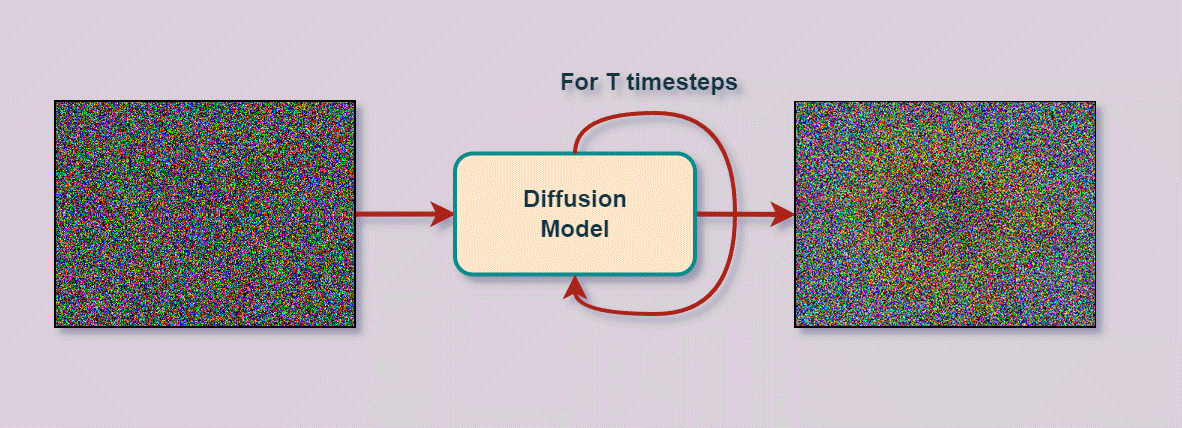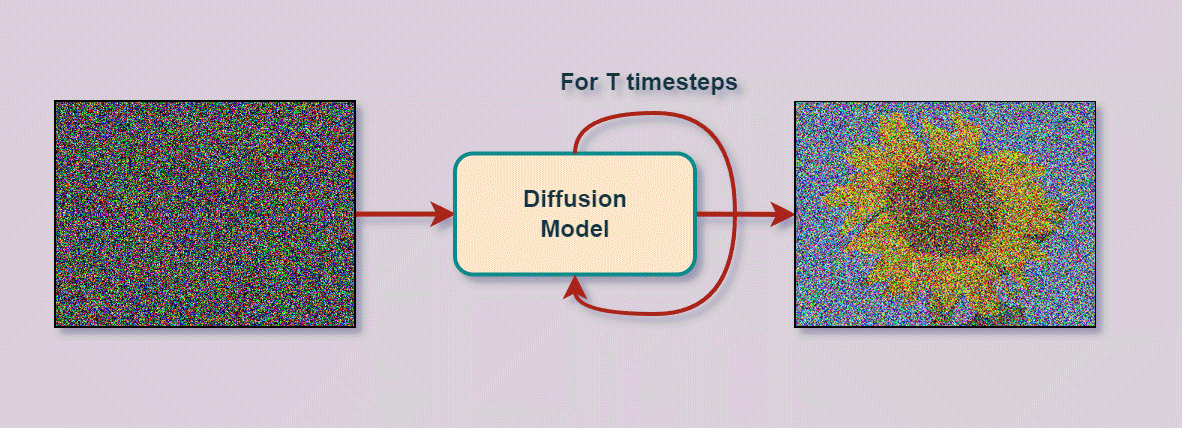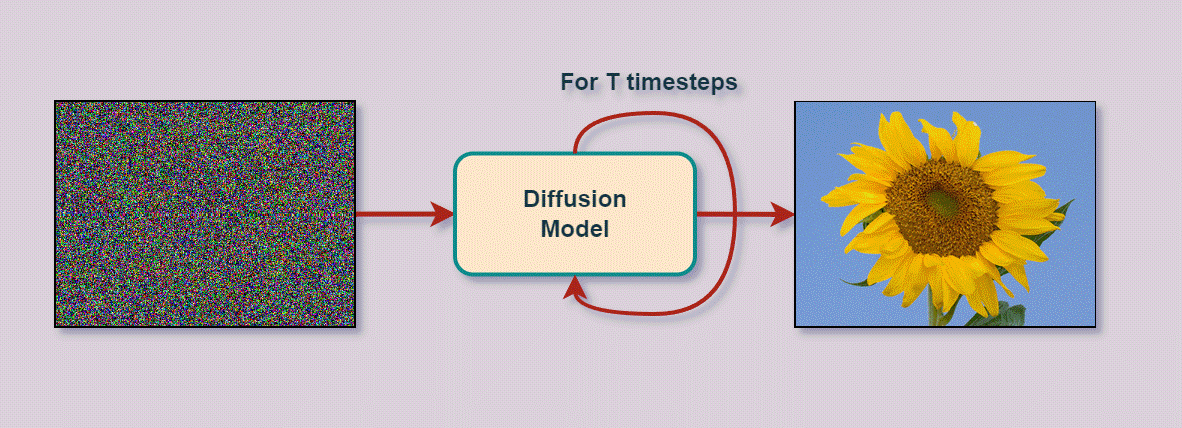
Немного истории…
Диффузионные модели в глубоком обучении были впервые представлены Соул-Дикштейном и др. в оригинальной статье 2015 года “Глубокое неконтролируемое обучение с использованием неравновесной термодинамики”. К сожалению, это оставалось за кулисами некоторое время.
Но в 2019 году Сонг и др. опубликовал статью “Генеративное моделирование путем оценки градиентов распределения данных”, использующую тот же принцип, но другой подход. В 2020 году Хо и др. опубликовал популярную в настоящее время статью “Вероятностные модели рассеяния шума” (сокращенно DDPM).
После 2020 года исследования в области диффузионных моделей начались
Интересные статьи
Интересные статьи