Moonshot AI 23 октября представила Kimi K3.1 Pro – первую модель новой серии K3.1. Это дообученная Kimi K3 с контекстом в 1 млн токенов: на постобучение компания потратила заметно больше вычислений и гоняла обучение с подкреплением сразу по сотням прикладных областей. Модель уже работает в сервисах Kimi и в API, а полные веса Moonshot обещает выложить не позднее 4 ноября. Перед выкладкой компания сознательно притормозила одну способность модели – поиск и эксплуатацию уязвимостей.
В основе разбора – анонс Moonshot с полной таблицей бенчмарков, тарифы API и первая независимая оценка Artificial Analysis. Почти все цифры ниже – данные самой Moonshot.
Что вышло и где доступно
Вместе с K3.1 Pro вышла K3.1 Pro Highspeed – по заявлению компании, в 2–3 раза быстрее. Архитектура унаследована от K3: это MoE на 2,8 трлн параметров, из которых на каждый токен работают 104 млрд. Модель принимает текст, изображения и видео, отвечает текстом. Режим рассуждений включен всегда, отключить его нельзя; глубину задает параметр reasoning_effort (low, high или max, по умолчанию max).
Kimi.ai и мобильные приложения Kimi для iOS, Android и HarmonyOS.
Kimi Work – десктопное приложение для Windows и Mac на Apple silicon, нужна версия 3.1.0 или новее.
Kimi Code – модель выбирается командой
/model.API – идентификаторы
kimi-k3.1-proиkimi-k3.1-pro-highspeed. В корпоративной версии Kimi модель по умолчанию выключена, ее включает администратор.
Цена: дешевле предшественника
K3.1 Pro стоит $2 за миллион входящих токенов и $10 за миллион исходящих, кешированный вход – $0,20. Highspeed ровно вдвое дороже: $4 и $20. Для сравнения, K3 стоила $3 и $15, то есть новая модель подешевела на треть. Это ровно промо-цена Gemini 4 Argon, которая с 1 декабря удвоится.
Но цена токена – еще не цена задачи. Рассуждения у K3.1 Pro включены всегда, а по умолчанию стоит максимальная глубина, так что счет будет зависеть от того, сколько токенов модель тратит на ответ. Независимых данных о расходе токенов на момент подготовки материала нет.
Бенчмарки: руки сильнее головы
В индексе Artificial Analysis K3.1 Pro набрала 55 баллов и заняла четвертое место – на 11 баллов больше, чем K3. По оценке Artificial Analysis, после выхода весов это будет сильнейшая открытая модель.
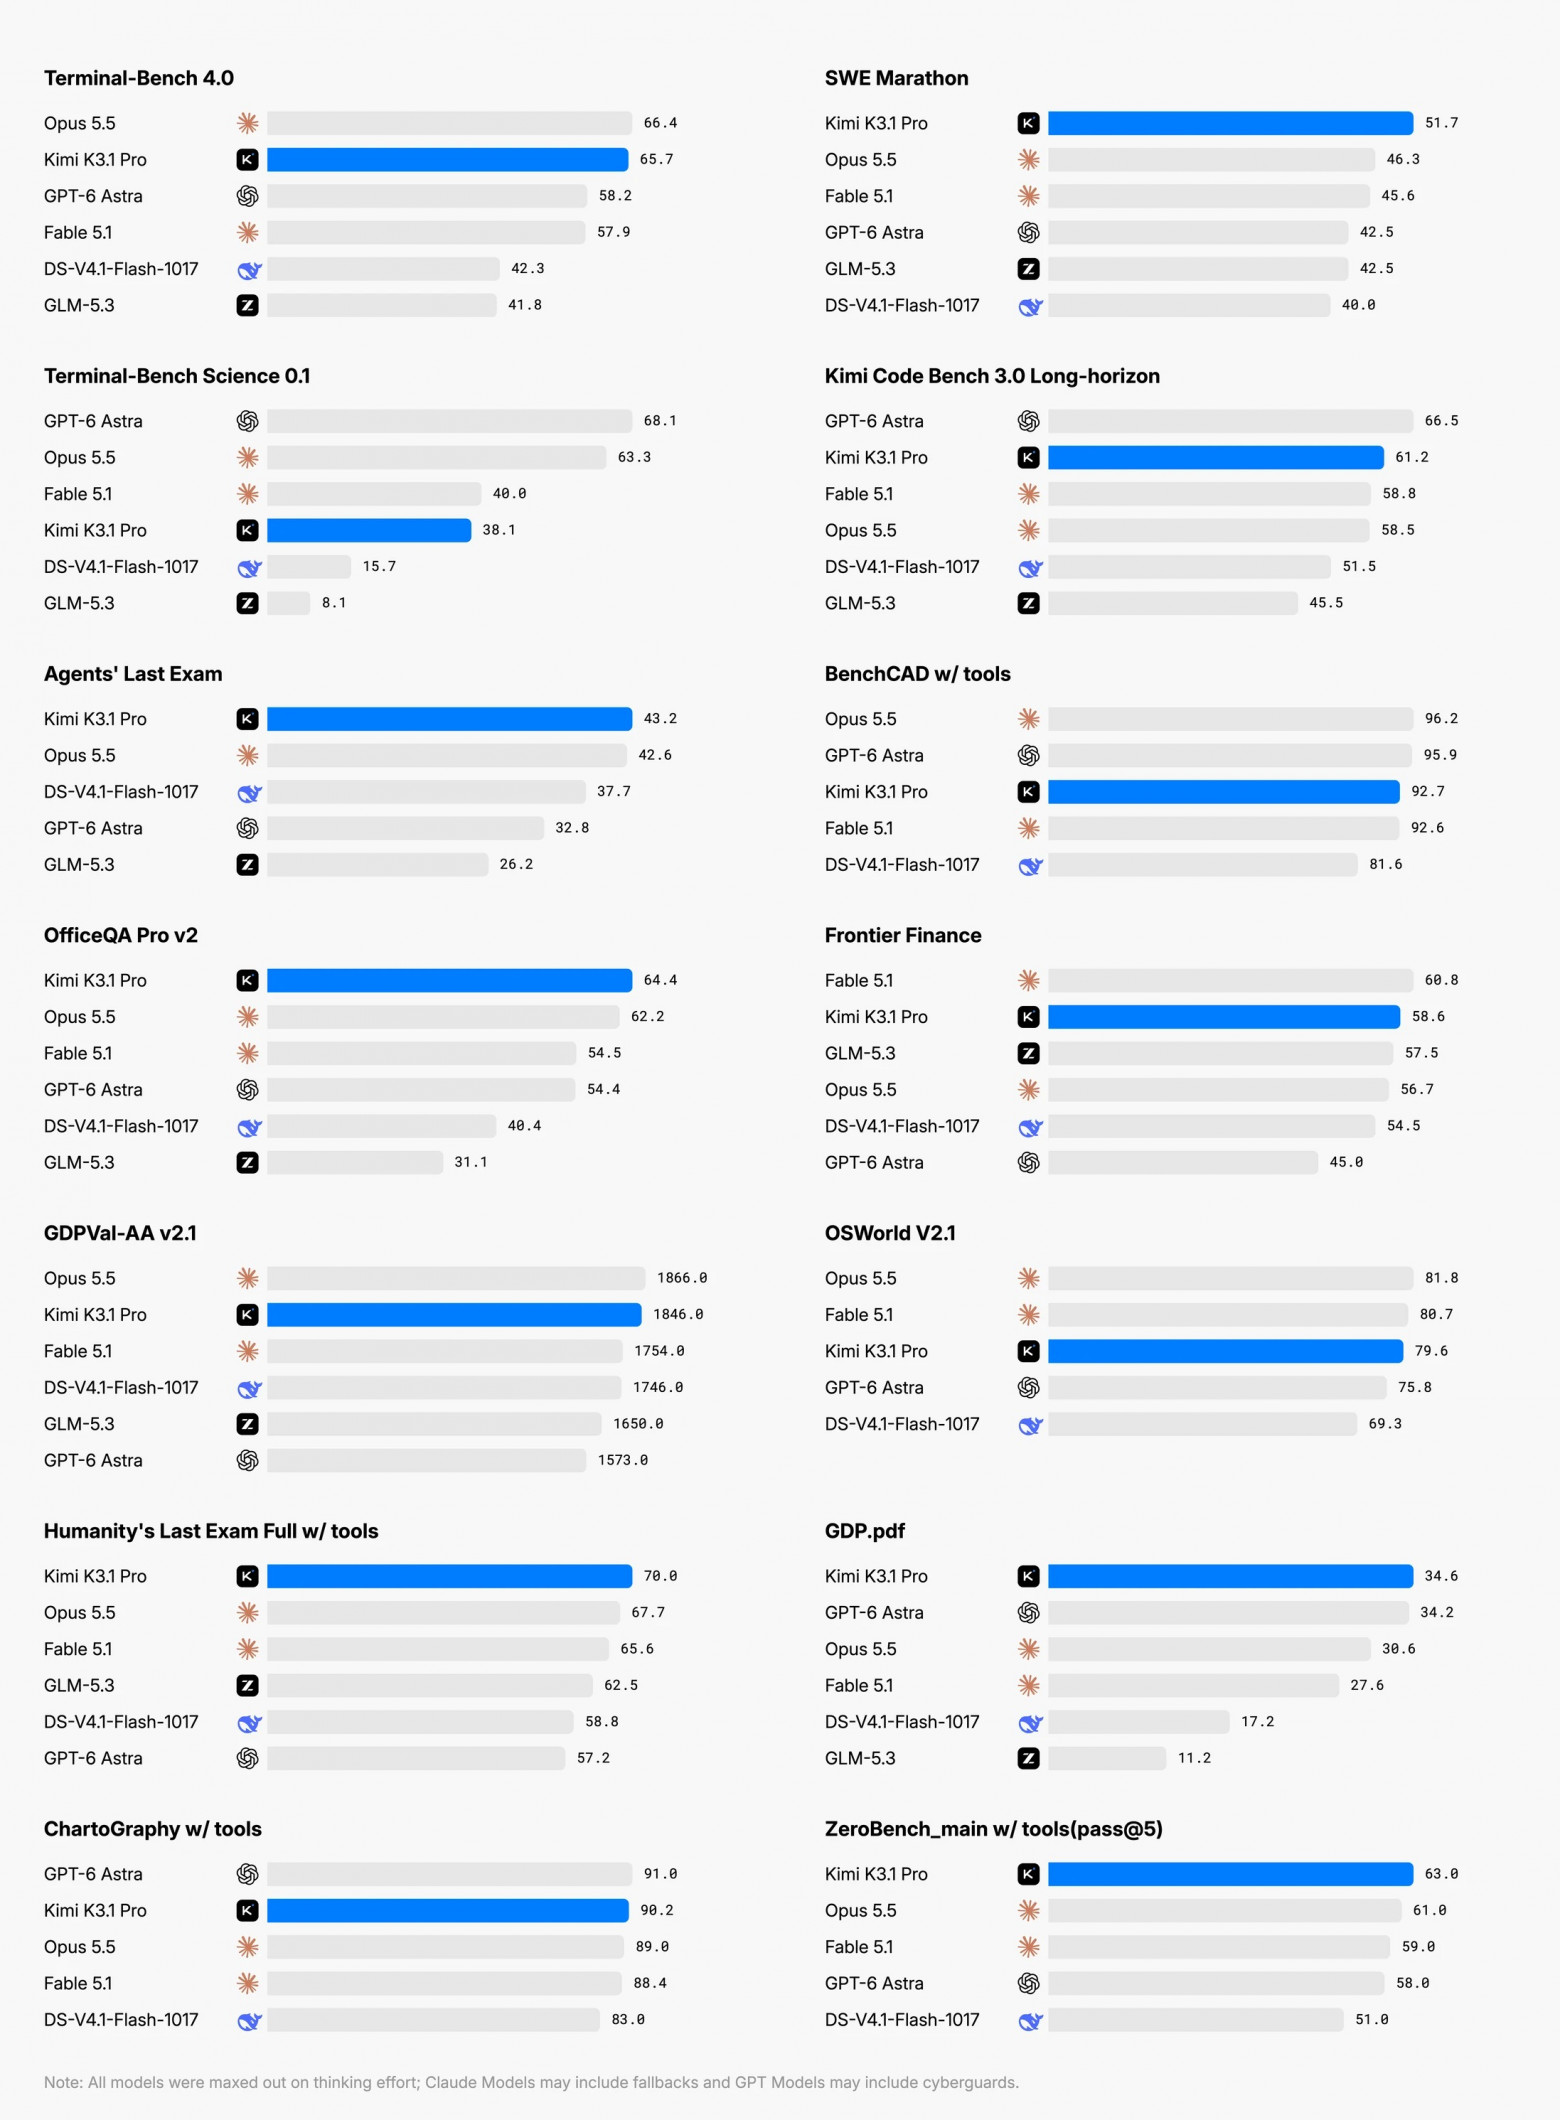
Moonshot сравнивает K3.1 Pro с Claude Fable 5.1, GPT-6 Astra и Claude Opus 5.5 из закрытых моделей и с DeepSeek-V4.1-Flash-1017 и GLM-5.3 из открытых. Выборка из таблицы:
Тест | K3.1 Pro | Лучший среди конкурентов |
|---|---|---|
SWE Marathon v1.1 | 51,7, первое место | Opus 5.5 – 46,3 |
HLE-Full с инструментами | 70,0, первое место | Opus 5.5 – 67,7 |
BrowseComp | 92,1, первое место | GPT-6 Astra – 91,5 |
Agents’ Last Exam | 43,2, первое место | Opus 5.5 – 42,6 |
OfficeQA Pro v2 | 64,4, первое место | Opus 5.5 – 62,2 |
Terminal-Bench 4.0 | 65,7 | Opus 5.5 – 66,4 (GPT-6 Astra – 58,2) |
HLE-Full без инструментов | 51,1 | Opus 5.5 – 59,8 |
HLE-Diamond без инструментов | 39,4 | GPT-6 Astra – 65,8 |
Terminal-Bench Science 0.1 | 38,1 | GPT-6 Astra – 68,1 |
ProgramBench | 31,5 | Opus 5.5 – 65,0 |
Профиль получился неровным, но с понятной логикой. Там, где модель работает долго и с инструментами – длинные задачи по программированию, веб-поиск, агентные экзамены, анализ финансовых документов, – K3.1 Pro лидирует или идет вровень с Opus 5.5. Там, где нужно ответить на сложный вопрос “из головы”, она заметно отстает: в HLE-Full без инструментов – на 8,7 пункта от Opus 5.5, в HLE-Diamond – на 26 пунктов от GPT-6 Astra. Еще один провал – ProgramBench, где задача засчитывается, только если программа набрала не меньше 95%: тут у K3.1 Pro вдвое меньше, чем у Opus 5.5.
Среди открытых моделей K3.1 Pro впереди почти везде. Исключение – DeepSWE v1.1, где DeepSeek-V4.1-Flash-1017 набрала 77,0 против 75,5 и стала лучшей вообще, включая закрытые модели.
Отдельно Moonshot занималась фактической точностью – для финансовых задач это критично. Во внутреннем стресс-тесте Kimi Hallu Bench Hard доля ложных утверждений упала с 23,4% у K3 до 8,3%. Это лучше, чем у Opus 5.5 (15,0%), но хуже, чем у GPT-6 Astra (5,5%). Компания сама предупреждает, что примеры в тесте подобраны так, чтобы спровоцировать ошибки, и в обычной работе цифры будут другими.
К чему придраться в методике
Таблица Moonshot сделана аккуратнее многих, а сноски к ней подробные – по ним и видно, где сравнение не вполне честное:
Kimi в большинстве тестов запускали в обвязке Claude Code, а результаты конкурентов брали из их отчетов или лидербордов, выбирая максимальное значение. Обвязки при этом разные.
У закрытых моделей в шапке таблицы стоит пометка “with fallback”, а в сносках оговорено, что при их тестировании возможно резервное поведение. Что это значило в каждом конкретном тесте, не уточняется.
В OfficeQA Pro и Agents’ Last Exam Moonshot обнуляла задачи, в которых чужие модели находили готовые ответы в интернете вместо того, чтобы решать. Логика понятна, но решение о том, что считать нарушением, принимала заинтересованная сторона.
В BioMysteryBench судьей была собственная модель Moonshot – Kimi K3. В PostTrainBench штатного судью заменили на DeepSeek-V4.1-Flash-1017, а тесты гоняли на H20 вместо H100.
Часть тестов внутренние: Kimi Code Bench, Business Operation, DECK-Arena, Design Bench, Kimi Hallu Bench, а также главный кибербенчмарк, о котором ниже.
Есть и несостыковки в самих данных. В строке Business Operation у DeepSeek-V4.1-Flash-1017 стоит 8,9 – ровно столько же, сколько у K3 на отдельном графике с финансовыми тестами. Похоже на ошибку в таблице. А в разделе про кибербезопасность колонка подписана Claude Fable 5.1, хотя в сносках сказано, что цифры взяты для Claude Mythos 5.1.
Как Moonshot урезала кибервозможности
Самая необычная часть анонса – раздел о кибербезопасности. По словам Moonshot, по мере роста постобучения модель все лучше находила уязвимости. Причину нашли в данных: материалы по кибербезопасности были рассыпаны по общему корпусу промежуточного обучения (mid-training), а задачи на взлом попадали в набор сред для обучения с подкреплением. В экспериментах на внутренних моделях выяснилось, что без чистки данных на любом из двух этапов кибервозможности заметно растут. Для открытой версии K3.1 Pro компания вычистила кибер-данные на обоих этапах, но оставила обычные задачи по программированию.
Эффект измеряли на внутреннем бенчмарке xdev-bench-hard. Большая часть задач – недавно раскрытые уязвимости в ядре Linux, Node.js, JavaScriptCore, Exim и VirGL с включенными защитами. Агент получает исходный код, короткую подсказку о баге и бинарник, а дальше должен написать эксплойт, добиться выполнения произвольного кода в отдельной песочнице и достать секретную строку. Засчитывается лучшая из трех попыток.
Модель | xdev-bench-hard, pass@3 |
|---|---|
GPT-5.6 Sol (оценка третьей стороны) | 100% |
Чекпойнт Kimi без чистки данных | 90,5% |
DeepSeek-V4.1-Flash | 85,7% |
Kimi K3.1 Pro | 81,0% |
GLM-5.3 | 57,1% |
Kimi K3 | 33,3% |
Чистка срезала около 10 пунктов, но модель все равно выросла с 33% у K3 до 81%. Moonshot сама это признает: сильное программирование и умение долго отлаживать код переносятся на задачи по взлому даже без специальных данных. На публичных тестах K3.1 Pro заметно отстает от закрытых моделей: в ExploitBench у нее 74,7 против 100 у GPT-6 Astra и 91,0 у Opus 5.5, в ExploitGym – 20,7 против 42,4 и 34,5.
Решение о выкладке Moonshot объясняет двумя принципами. Первый: не выкладывать открытые веса, которые расширят абсолютный предел кибервозможностей, – K3.1 Pro, по словам компании, отстает от закрытых моделей, доступных публично хотя бы три месяца. Второй: постепенно поднимать уровень, доступный в открытых весах. Аргумент такой: когда сильная модель работает на собственной инфраструктуре, проверять свой код могут гораздо больше команд, включая старые системы, до которых аудиторы обычно не доходят.
В той же таблице видна деталь, которую Moonshot не комментирует. Открытая DeepSeek-V4.1-Flash, веса которой уже лежат на Hugging Face, на внутреннем бенчмарке Moonshot решает больше задач, чем K3.1 Pro: 85,7% против 81,0%. Получается, планку кибервозможностей открытых моделей двигает не только Moonshot, и ее самоограничение работает, пока так же поступают остальные.
Пример: научить виртуального человека ходить
Самая показательная демонстрация в анонсе – внутренний тест на длинную задачу. K3.1 Pro собрала симулятор ходьбы на основе human-atlas, открытой анатомической модели человека с 296 элементами скелета, включая хрящи, и 402 мышцами. За 167 подзадач и 420 независимых проверок модель анализировала результаты экспериментов, искала проблемы и дорабатывала контроллер. В итоге виртуальный человек перестал падать через несколько секунд и прошел 11,2 секунды, попеременно переставляя ноги.
Интереснее всего эпизод с руками. Когда настройка функции вознаграждения перестала улучшать движение рук, модель не стала крутить ее дальше, а проверила динамику самого симулятора и нашла 36 ошибок в расчетах плеч силы для мышц плеча. После исправления она заново обучила контроллер. Это описание самой Moonshot, независимо его никто не проверял.
Веса и лицензия
Веса обещаны до 4 ноября, лицензию для K3.1 Pro компания пока не объявила. У K3 она была близка к MIT, но с двумя условиями. Сервисы, которые продают доступ к модели как услугу, при выручке больше $20 млн за 12 месяцев должны заключать с Moonshot отдельное соглашение. Продукты с аудиторией больше 100 млн пользователей в месяц или выручкой больше $20 млн в месяц должны заметно указывать в интерфейсе, что работают на Kimi.
Запустить такую модель дома не выйдет. Для K3 с той же архитектурой Moonshot рекомендовала кластеры от 64 ускорителей, так что открытые веса K3.1 Pro – история для облачных провайдеров и крупных компаний, которым важно держать данные у себя.
P.S. Поддержать меня можно подпиской на канал “сбежавшая нейросеть”, где я рассказываю про ИИ с творческой стороны.